


8
月
在社区成长 8 月
LEVEL 50
100 XP
大语言模型中的幻觉通常是指模型生成不忠实、捏造、不一致或无意义的内容。作为一个术语,幻觉在某种程度上被泛化为模型出错的情况。在这里,我想将幻觉问题缩小到模型输出是捏造的并且不以所提供的上下文或世界知识为基础的情况。
幻觉有两种类型:
上下文幻觉: 模型输出应与上下文中的源内容一致。
外在幻觉: 模型输出应以预训练数据集为基础。然而,考虑到预训练数据集的大小,检索和识别每代冲突的成本太高。如果我们将预训练数据语料库视为世界知识的代理,那么我们本质上是试图确保模型输出是事实的并且可以通过外部世界知识进行验证。同样重要的是,当模型不知道某个事实时,它应该这样说。
这篇文章的重点是外在幻觉。为了避免产生幻觉,法学硕士需要(1) 实事求是,(2) 在适用时承认不知道答案。
微调通常消耗的计算量要少得多,因此模型是否能够通过小规模微调可靠地学习新知识存在争议。格克曼等人。 2024年研究了法学硕士对新知识进行微调是否会鼓励产生幻觉的研究问题。他们发现(1)法学硕士学习新知识的微调示例的速度比其他具有与模型预先存在的知识一致的知识的示例慢; (2)一旦最终学习了具有新知识的示例,它们就会增加模型产生幻觉的倾向。
给定闭卷QA 数据集(即EntityQuestions),$D={(q, a)}$,让我们将$P_\text{Correct}(q, a; M, T )$ 定义为模型$M$ 在随机几次样本提示并使用解码温度$T$ 时准确生成问题$q$ 的正确答案$a$ 的可能性的估计。他们根据$P_\text{Correct}(q, a; M, T )$ 的不同条件,将示例分为4 个类别: 已知组和3 个子组(HighlyKnown、MaybeKnown 和WeaklyKnown)和未知组的小层次结构。
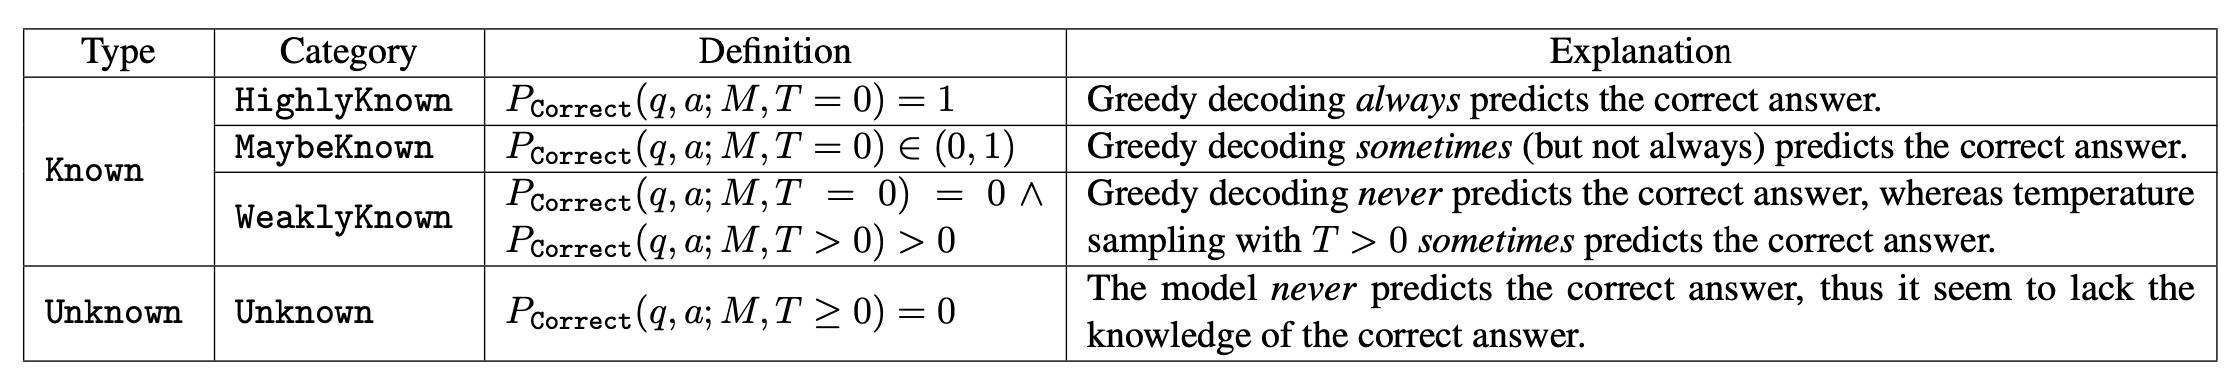 根据模型输出正确答案的可能性对闭卷QA 示例进行知识分类。 (图片来源: Gekhman et al. 2024)实验的一些有趣观察,其中开发集准确性被认为是幻觉的代表。
未知示例的安装速度比已知示例慢得多。
当LLM 适合大多数已知训练示例但仅适合少数未知训练示例时,可以获得最佳开发性能。当模型学习到大部分未知示例时,它开始产生幻觉。
在已知的例子中,MaybeKnown 的案例会带来更好的整体性能,比HighlyKnown 的案例更重要。
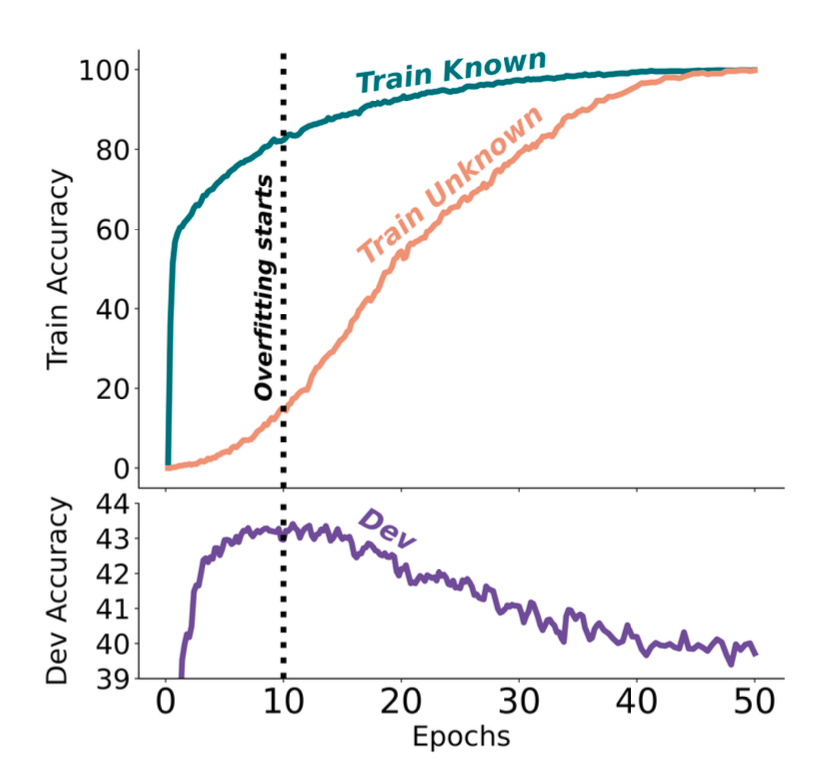 在对一半“已知”和一半“未知”示例进行微调时,随着时间的推移训练和开发性能。 “未知”示例的学习速度要慢得多,并且当模型学习大多数“已知”案例但仅学习少数“未知”案例时,可以获得最佳开发结果。 (图片来源: Gekhman 等人,2024)这些经验结果来自Gekhman 等人。 (2024)指出使用监督微调来更新法学硕士知识的风险。
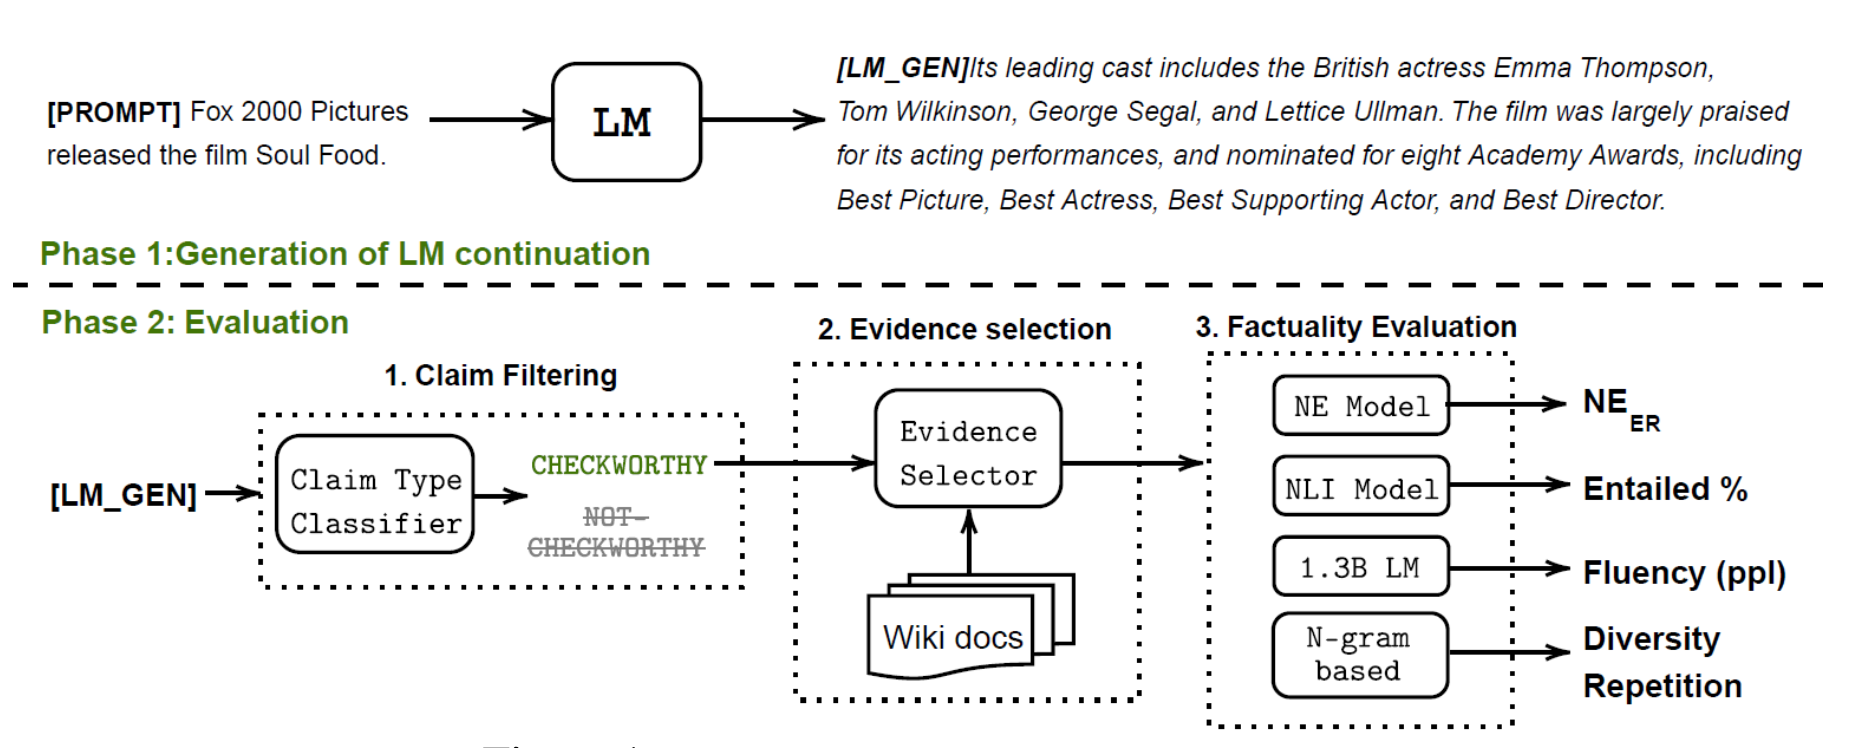 FactualityPrompt 基准的评估框架。
(图片来源: Lee, et al. 2022)考虑到模型延续和配对的维基百科文本,考虑了幻觉的两个评估指标:
幻觉NE(命名实体)错误: 使用预训练的实体检测模型和文档级基础,该指标可测量检测到的命名实体中未出现在基础事实文档中的比例。
蕴涵比率: 使用在MNLI 和句子级知识基础上微调的RoBERTa 模型,该指标计算由蕴涵模型标记为与配对维基百科句子相关的生成句子的比例。
较低的NE 错误和较高的蕴涵比率表明较高的事实性,并且发现这两个指标都与人类注释相关。我们发现较大的模型在此基准测试中表现更好。
FActScore(原子性分数中的事实精度;Min et al. 2023)将长形式生成分解为多个原子事实,并根据维基百科等知识库单独验证每个事实。然后我们可以测量每个模型生成的知识源支持的句子的比率(精度),FActScore 是一组提示中模型生成的平均精度。该论文在人物传记生成任务上尝试了多种真实性验证方法,发现使用检索比非上下文法学硕士的一致性更好。检索增强方法中确切的最佳估计器取决于模型。
非上下文LLM: 直接用原子事实提示LLM True 或False?没有额外的上下文。
检索→LLM: 提示从知识源检索$k$ 相关段落作为上下文。
非参数概率(NP)): 通过掩码LM 计算原子事实中标记的平均可能性,并使用它进行预测。
检索→LLM + NP: 两种方法的集成。
关于模型幻觉行为的一些有趣的观察:
在传记生成任务中,越稀有的实体的错误率越高。
对于一代中稍后提到的事实,错误率更高。
使用检索来建立模型生成显着有助于减少幻觉。
魏等人。 (2024)提出了一种用于检查法学硕士中长篇事实性的评估方法,称为SAFE(搜索增强事实性评估器;代码)。与FActScore 相比的主要区别在于,对于每个独立的原子事实,SAFE 使用语言模型作为代理,在多步骤过程中迭代地发出Google 搜索查询,并推理搜索结果是否支持该事实。在每个步骤中,代理都会根据要检查的给定事实以及之前获得的搜索结果生成搜索查询。经过多个步骤后,模型执行推理以确定搜索结果是否支持事实。根据实验,尽管安全方法比人类注释者便宜20 倍,但SAFE 方法比人类注释者效果更好。 与人类的一致率为72%,当人类不同意时,其获胜率为76%。
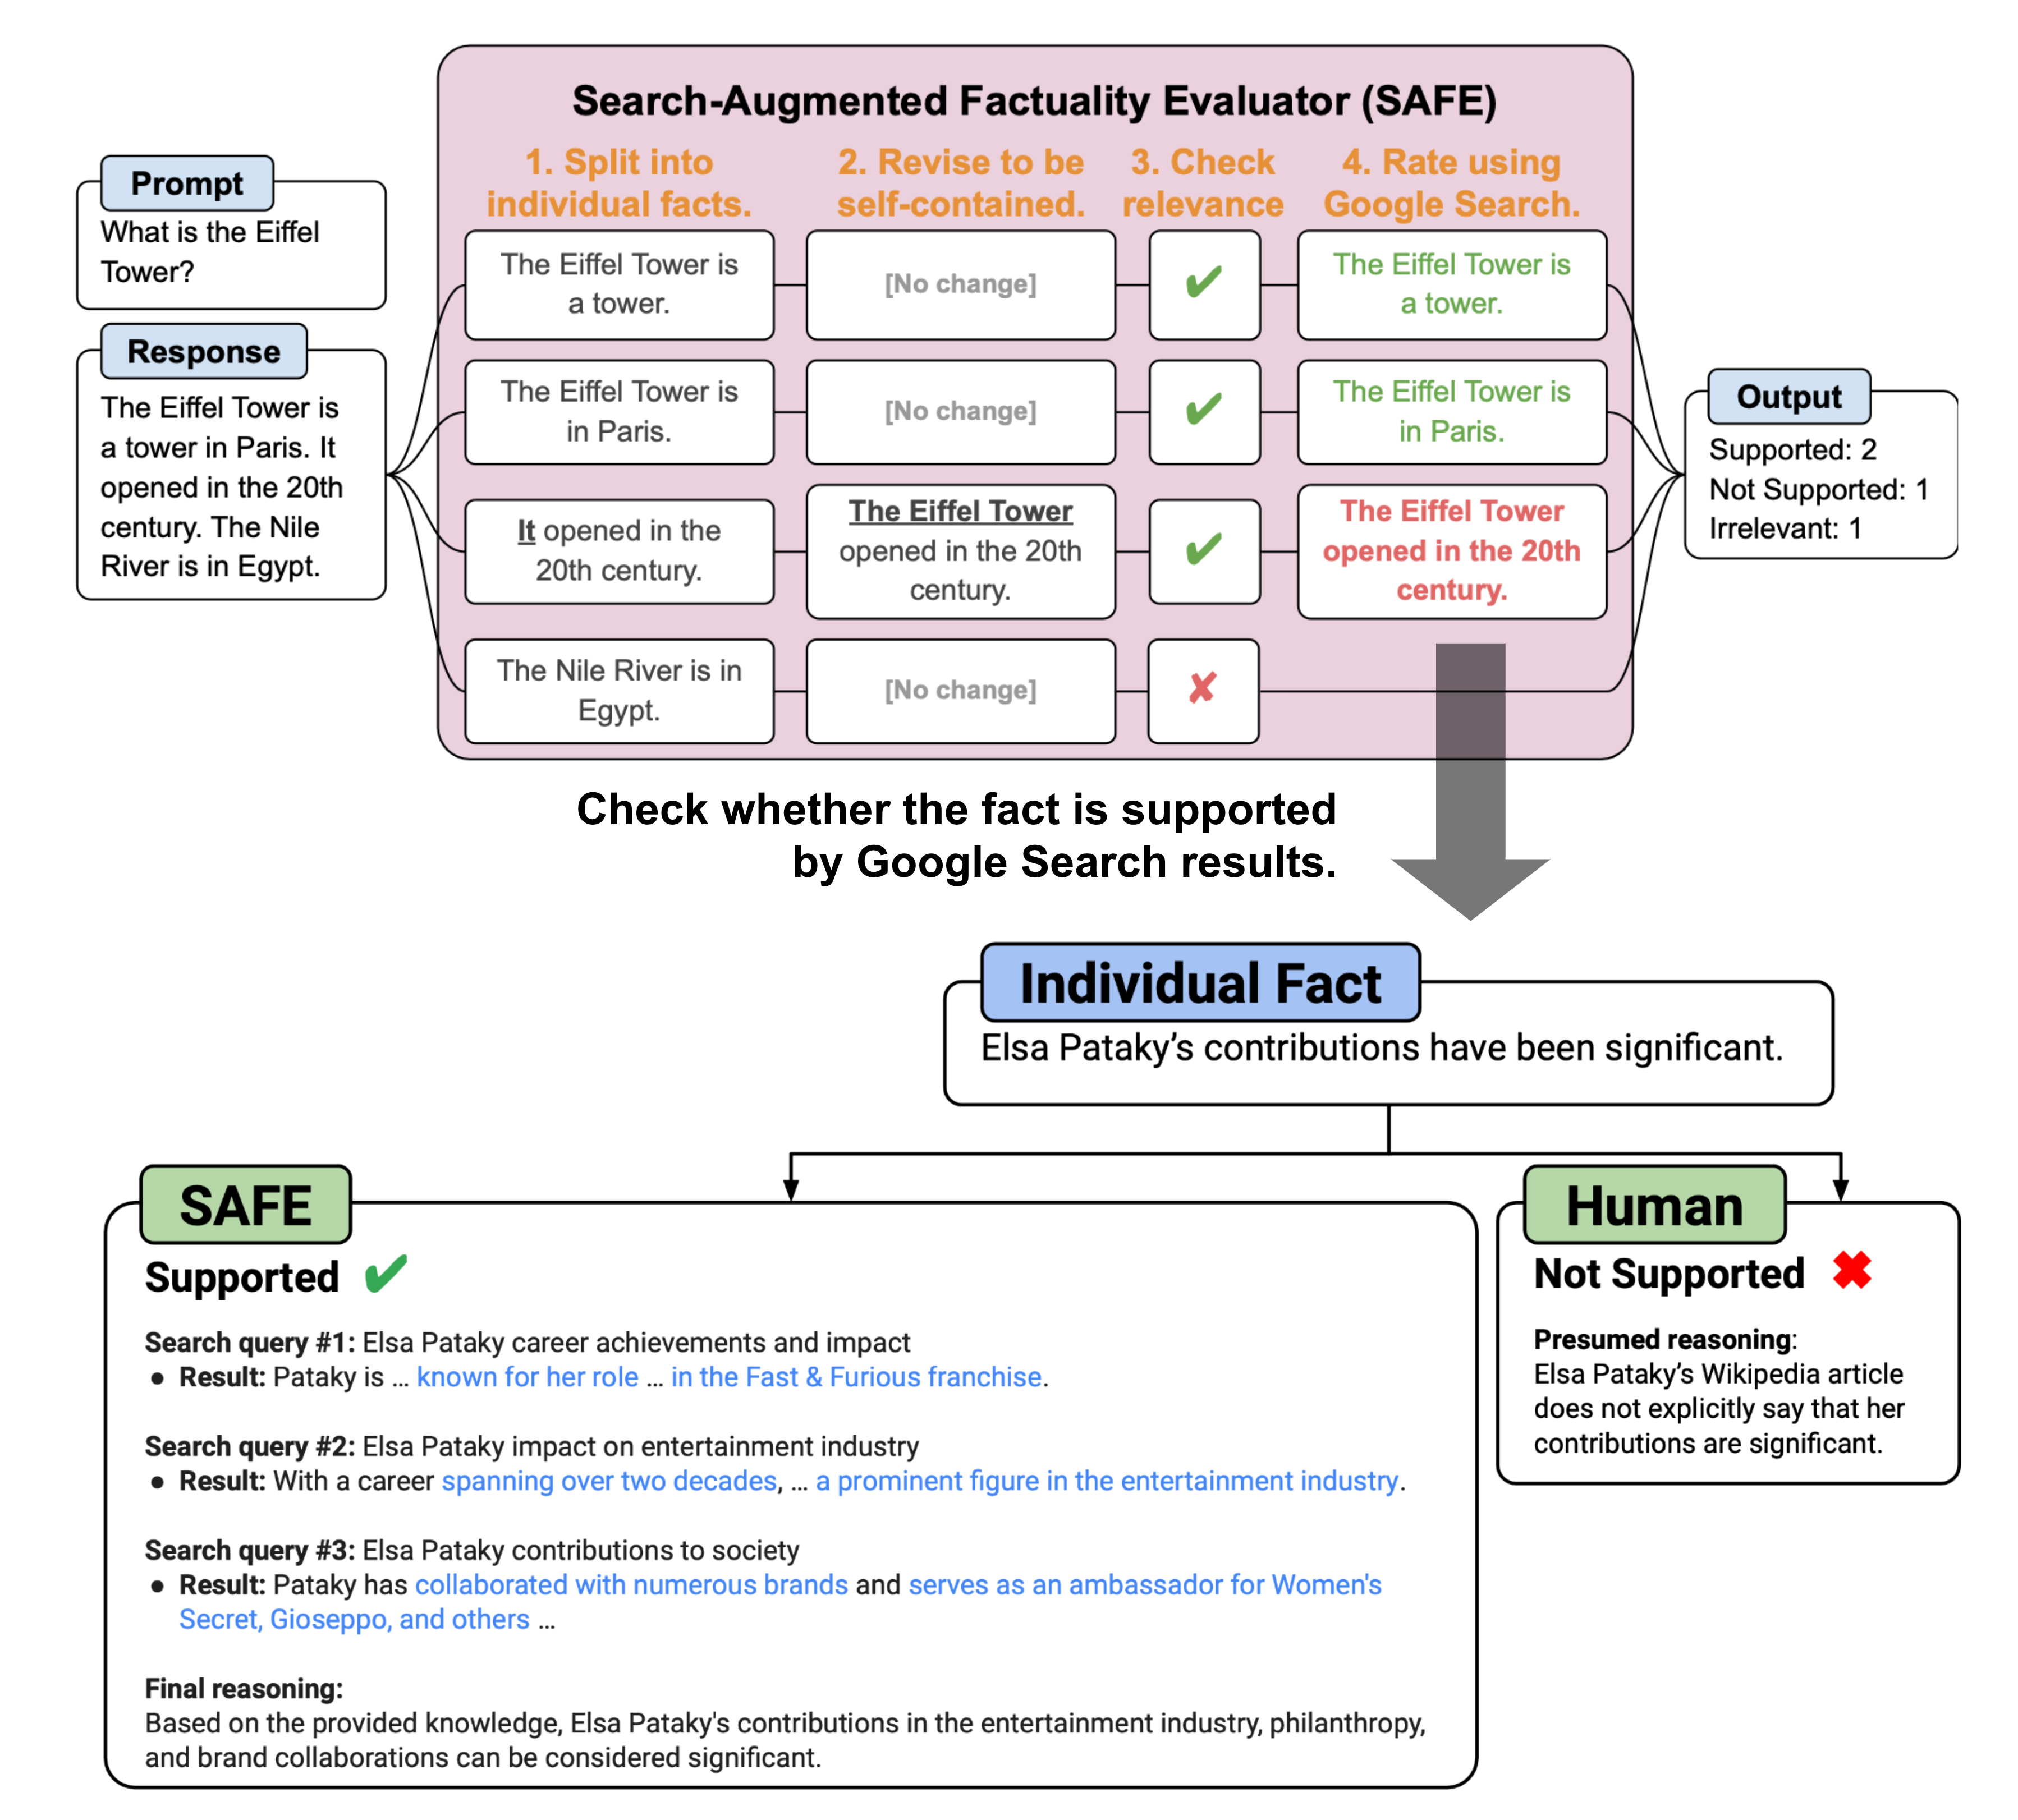 长篇LLM 生成的真实性评估SAFE 概述。 (图片来源: Wei et al. 2024)SAFE 评估指标是F1 @ K。其动机是,长格式事实性的模型响应理想情况下应该同时达到精度和召回率,因为响应应该同时满足
事实: 以精确度衡量,即整个答复中支持的事实占所有事实的百分比。
long : 通过召回率来衡量,所提供的事实在应出现在答复中的所有相关事实中所占的百分比。因此,我们要考虑最多$K$ 的支持事实数量。
给定模型响应$y$,度量F1 @ K 定义为:
$$
\开始{对齐}
S =\text{支持的事实的数量} \\
N=\text{不支持的事实的数量} \\
\text{Prec}=\frac{S}{S + N},\quad R_K=\min\big(\frac{S}{K}, 1\big) \\
F_1 @ K=\begin{cases}
\frac{2\text{Prec}R_K}{Prec + R_K} \text{if } S 0 \\
0, \text{如果} S=0
\结束{案例}
\结束{对齐}
$$
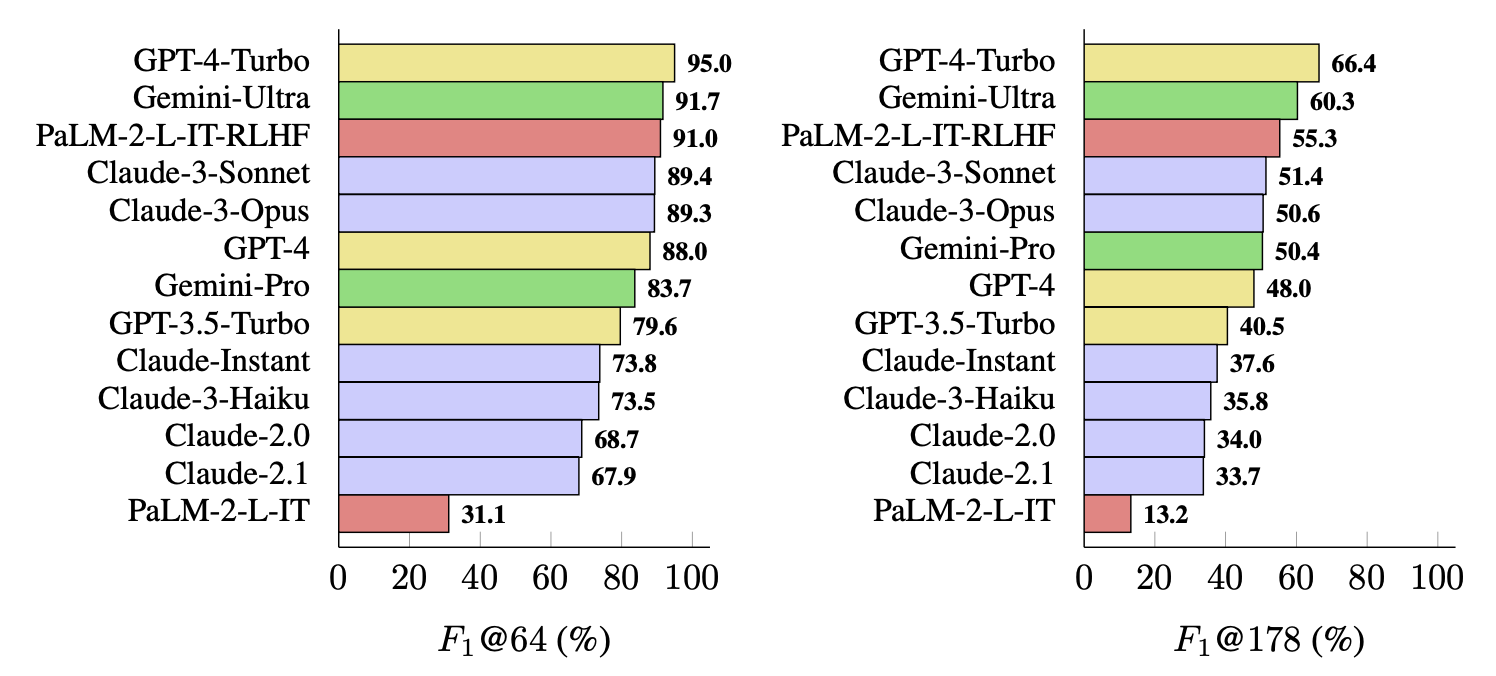 长格式真实性性能,以$F_1 @ K$ 为单位测量,针对主流模型列表,使用来自LongFact 基准的LongFact-Objects 的250 个随机提示。 (图片来源: Wei 等人,2024)FacTool(Chern 等人,2023)遵循标准的事实检查工作流程。它旨在检测各种任务中的事实错误,包括基于知识的QA、代码生成、数学问题解决(生成测试用例而不是声明)和科学文献审查。如下:
声明提取: 通过提示法学硕士提取所有可验证的声明。
查询生成: 转换e
幻觉有两种类型:
上下文幻觉: 模型输出应与上下文中的源内容一致。
外在幻觉: 模型输出应以预训练数据集为基础。然而,考虑到预训练数据集的大小,检索和识别每代冲突的成本太高。如果我们将预训练数据语料库视为世界知识的代理,那么我们本质上是试图确保模型输出是事实的并且可以通过外部世界知识进行验证。同样重要的是,当模型不知道某个事实时,它应该这样说。
这篇文章的重点是外在幻觉。为了避免产生幻觉,法学硕士需要(1) 实事求是,(2) 在适用时承认不知道答案。
什么原因导致幻觉?#
鉴于标准的可部署LLM 经过预训练和微调以进行调整和其他改进,让我们考虑这两个阶段的原因。预训练数据问题#
预训练数据语料库的数量巨大,因为它应该以所有可用的书面形式代表世界知识。从公共互联网爬取的数据是最常见的选择,因此预计会出现过时、丢失或不正确的信息。由于模型可能通过简单地最大化对数似然来错误地记住这些信息,因此我们预计模型会犯错误。微调新知识#
通过监督微调和RLHF 微调预训练的LLM 是提高模型某些功能(例如指令跟踪)的常用技术。在微调阶段引入新知识是不可避免的。微调通常消耗的计算量要少得多,因此模型是否能够通过小规模微调可靠地学习新知识存在争议。格克曼等人。 2024年研究了法学硕士对新知识进行微调是否会鼓励产生幻觉的研究问题。他们发现(1)法学硕士学习新知识的微调示例的速度比其他具有与模型预先存在的知识一致的知识的示例慢; (2)一旦最终学习了具有新知识的示例,它们就会增加模型产生幻觉的倾向。
给定闭卷QA 数据集(即EntityQuestions),$D={(q, a)}$,让我们将$P_\text{Correct}(q, a; M, T )$ 定义为模型$M$ 在随机几次样本提示并使用解码温度$T$ 时准确生成问题$q$ 的正确答案$a$ 的可能性的估计。他们根据$P_\text{Correct}(q, a; M, T )$ 的不同条件,将示例分为4 个类别: 已知组和3 个子组(HighlyKnown、MaybeKnown 和WeaklyKnown)和未知组的小层次结构。
未知示例的安装速度比已知示例慢得多。
当LLM 适合大多数已知训练示例但仅适合少数未知训练示例时,可以获得最佳开发性能。当模型学习到大部分未知示例时,它开始产生幻觉。
在已知的例子中,MaybeKnown 的案例会带来更好的整体性能,比HighlyKnown 的案例更重要。
幻觉检测#
检索增强评估#
为了量化模型幻觉,Lee 等人。 (2022) 引入了一个新的基准数据集FactualityPrompt,由事实和非事实提示组成。该数据集使用维基百科文档或句子作为事实基础的知识库。维基百科文档是来自FEVER 数据集的已知事实,并且基于tf-idf 或基于句子嵌入的相似性来选择句子。
(图片来源: Lee, et al. 2022)考虑到模型延续和配对的维基百科文本,考虑了幻觉的两个评估指标:
幻觉NE(命名实体)错误: 使用预训练的实体检测模型和文档级基础,该指标可测量检测到的命名实体中未出现在基础事实文档中的比例。
蕴涵比率: 使用在MNLI 和句子级知识基础上微调的RoBERTa 模型,该指标计算由蕴涵模型标记为与配对维基百科句子相关的生成句子的比例。
较低的NE 错误和较高的蕴涵比率表明较高的事实性,并且发现这两个指标都与人类注释相关。我们发现较大的模型在此基准测试中表现更好。
FActScore(原子性分数中的事实精度;Min et al. 2023)将长形式生成分解为多个原子事实,并根据维基百科等知识库单独验证每个事实。然后我们可以测量每个模型生成的知识源支持的句子的比率(精度),FActScore 是一组提示中模型生成的平均精度。该论文在人物传记生成任务上尝试了多种真实性验证方法,发现使用检索比非上下文法学硕士的一致性更好。检索增强方法中确切的最佳估计器取决于模型。
非上下文LLM: 直接用原子事实提示LLM True 或False?没有额外的上下文。
检索→LLM: 提示从知识源检索$k$ 相关段落作为上下文。
非参数概率(NP)): 通过掩码LM 计算原子事实中标记的平均可能性,并使用它进行预测。
检索→LLM + NP: 两种方法的集成。
关于模型幻觉行为的一些有趣的观察:
在传记生成任务中,越稀有的实体的错误率越高。
对于一代中稍后提到的事实,错误率更高。
使用检索来建立模型生成显着有助于减少幻觉。
魏等人。 (2024)提出了一种用于检查法学硕士中长篇事实性的评估方法,称为SAFE(搜索增强事实性评估器;代码)。与FActScore 相比的主要区别在于,对于每个独立的原子事实,SAFE 使用语言模型作为代理,在多步骤过程中迭代地发出Google 搜索查询,并推理搜索结果是否支持该事实。在每个步骤中,代理都会根据要检查的给定事实以及之前获得的搜索结果生成搜索查询。经过多个步骤后,模型执行推理以确定搜索结果是否支持事实。根据实验,尽管安全方法比人类注释者便宜20 倍,但SAFE 方法比人类注释者效果更好。 与人类的一致率为72%,当人类不同意时,其获胜率为76%。
事实: 以精确度衡量,即整个答复中支持的事实占所有事实的百分比。
long : 通过召回率来衡量,所提供的事实在应出现在答复中的所有相关事实中所占的百分比。因此,我们要考虑最多$K$ 的支持事实数量。
给定模型响应$y$,度量F1 @ K 定义为:
$$
\开始{对齐}
S
=\text{支持的事实的数量} \\N
=\text{不支持的事实的数量} \\\text{Prec}
=\frac{S}{S + N},\quad R_K=\min\big(\frac{S}{K}, 1\big) \\F_1 @ K=\begin{cases}
\frac{2\text{Prec}
R_K}{Prec + R_K} \text{if } S 0 \\0, \text{如果} S
=0\结束{案例}
\结束{对齐}
$$
声明提取: 通过提示法学硕士提取所有可验证的声明。
查询生成: 转换e


