


8
月
在社区成长 8 月
LEVEL 50
100 XP
人工智能革命推动了对私营和上市公司的疯狂投资,并在2023 年激发了公众的想象力。像ChatGPT 这样的变革性消费产品由大型语言模型(LLM) 提供支持,该模型擅长对代表单词或单词部分的标记序列进行建模[2]。令人惊讶的是,结构理解是通过学习下一个标记预测而产生的,并且智能体能够完成翻译、回答问题以及根据简单的用户提示生成类似人类的散文等任务。
毫不奇怪,量化交易者问:我们能否将这些模型转化为下一个价格或交易预测[1,9,10]?也就是说,我们可以不是对单词序列进行建模,而是对价格或交易序列进行建模。事实证明,这是一个有趣的探究方向,它揭示了有关生成人工智能和金融时间序列建模的很多信息。请注意,这会变得不稳定。
LLM 被称为自回归学习器——使用序列中先前的标记或元素来预测下一个元素或标记。在定量交易中,例如在股票统计套利等策略中,大多数研究都与识别自回归结构有关。这意味着找到最能预测未来价格的新闻、订单或基本变化序列。
问题出在用于训练模型的可用数据的数量和信息内容上。在2023 年NeurIPS 会议上,高频交易公司Hudson River Trading 提出了用于训练GPT-3 的输入代币数量与每年股票市场数据中可训练代币数量的比较,HRT 估计,以3000 只可交易股票、每只股票每天10 个数据点、每年252 个交易日、一个交易日23400 秒计算,股市中有1770 亿个股票每年的代币数量可作为市场数据。 GPT-3 在5000 亿个代币上进行了训练,所以距离不远了[6]。
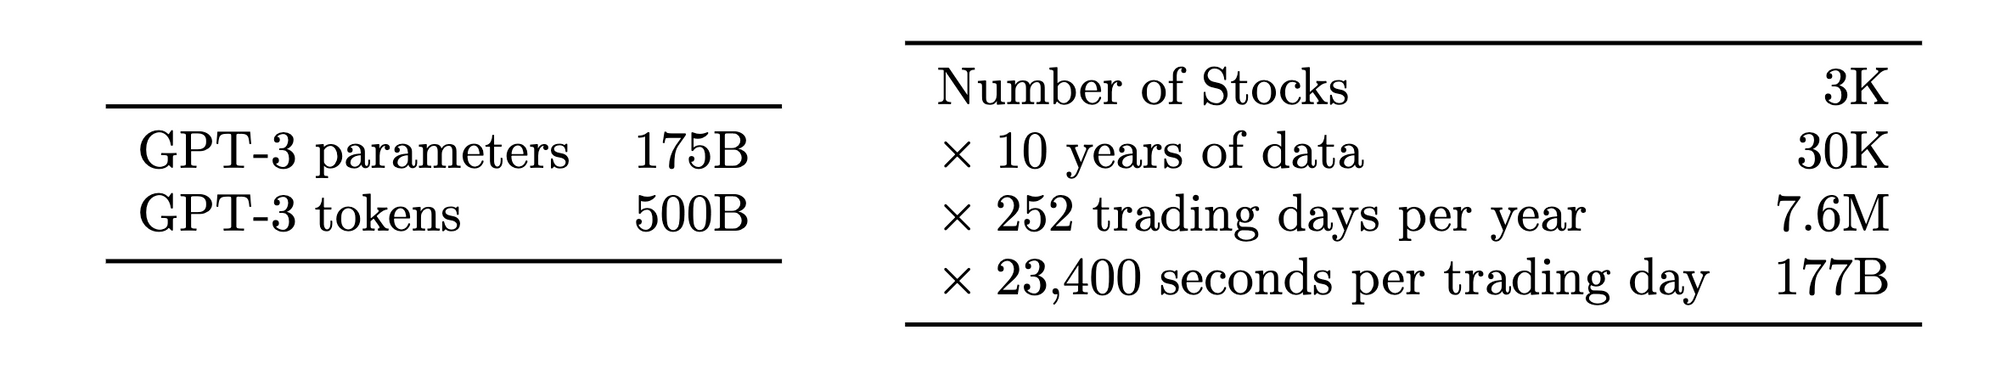 数字由HRT 2023 NeuRIPS 演示提供但是,在交易环境中,代币将是价格、回报或交易,而不是音节或单词;前者更难预测。语言具有潜在的语言结构(例如语法)[7]。不难想象一个人预测句子中的下一个单词,但同一个人会发现在给定一系列先前交易的情况下预测下一个回报极具挑战性,因此缺乏亿万富翁日内交易者。挑战在于,有非常聪明的人在竞争市场上的任何信号,使其几乎高效(用经济学家Lasse Pedersen 的话说,“高效低效”),因此不可预测。没有对手会主动试图让句子变得更难以预测——如果有的话,作者通常会试图让他们的句子更容易理解,从而更容易预测。
从另一个角度来看,金融数据中的噪音远多于信号。个人和机构进行交易的原因可能不合理,也可能与企业的任何根本性变化无关。 2021 年的GameStop 事件就是这样的一个例子。金融时间序列也会随着新的基本信息、监管变化以及偶尔出现的宏观经济变化(例如货币贬值)而不断变化。语言的发展速度要慢得多,而且时间范围要长。
另一方面,我们有理由相信人工智能的想法将在金融市场中发挥良好作用。具有前景的金融应用的人工智能研究的一个新兴领域是多模态学习[5],其目的是使用不同模式的数据,例如图像和文本输入来构建统一的模型。使用OpenAI 的DALL-E 2 模型,用户可以输入文本,模型将生成图像。在金融领域,多模式工作可能有助于将技术时间序列数据(价格、交易、交易量等)等经典信息源与不同模式的替代数据(如推特上的情绪或图形交互、自然语言新闻文章和公司报告,或以商品为中心的港口航运活动的卫星图像)结合起来。在这里,利用多模式人工智能,人们可以整合所有这些类型的非价格信息来进行良好的预测。
另一种称为“剩余化”的策略在金融和人工智能领域都很突出,尽管它在这两个领域扮演着不同的角色。在金融领域,结构性“因子”模型将不同资产的回报的同期观察结果分解为共享成分(市场回报,或更普遍的市场范围因素的回报)和每个基础资产独有的特殊成分。市场和要素回报很难预测并产生相互依赖性,因此在单个资产层面进行预测时消除共同因素通常会有所帮助,并最大限度地增加数据中独立观察的数量。
在像Transformer 这样的残差网络架构中,有一个类似的想法,我们想要学习输入X 的函数h(X),但学习h(X) 到恒等映射的残差可能更容易,即金融案例中的h(X) - 预测:其想法是专注于预测整体市场暗示之外的创新,对于残差网络,重点是预测恒等映射的创新。
法学硕士工作取得令人印象深刻的表现的一个关键因素是他们能够在称为上下文窗口的长期范围内辨别标记之间的亲和力或优势。在金融市场中,长期关注注意力的能力可以分析多尺度现象,并在不同的时间范围内解释市场变化的某些方面。例如,在一个极端情况下,基本信息(例如收益)可能会在几个月内纳入价格中,技术现象(例如动量)可能在几天内实现,而在另一种极端情况下,微观结构现象(例如订单不平衡)可能会有几秒到几分钟的时间范围。
捕获所有这些现象需要对整个上下文窗口的多个时间范围进行分析。然而,在金融领域,对多个未来时间范围的预测也很重要。例如,定量系统可能会寻求进行交易,以从多个时间范围内实现的多个不同异常中获利(例如,同时押注微观结构事件和收益事件)。这不仅需要预测股票的下一个时期的回报,还需要预测整个期限结构或预期回报的轨迹,而电流互感器预测式模型只关注未来的一个时期。
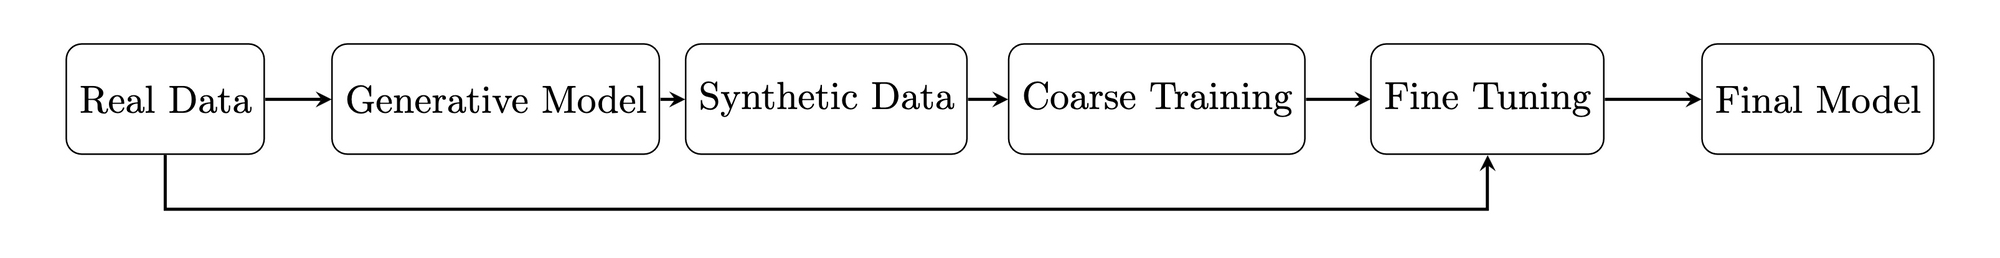
法学硕士的另一个金融市场应用可能是合成数据创建[4,8]。这可能需要几个方向。可以生成模仿市场中观察到的特征的模拟股票价格轨迹,并且鉴于金融市场数据相对于其他来源(如上面在可用代币数量方面强调的那样)稀缺,这可能非常有益。人工数据可以为元学习技术打开大门,这些技术已成功应用于机器人技术等领域。在机器人设置中,控制器首先使用廉价但不一定准确的物理模拟器进行训练,然后使用昂贵的机器人现实世界实验进行更好的校准。在金融领域,模拟器可用于粗略训练和优化交易策略。该模型将学习风险规避和多元化等高级概念以及缓慢交易等战术概念,以尽量减少交易对价格的影响。然后,可以利用宝贵的真实市场数据来微调预测并准确确定最佳交易速度。
 金融市场从业者通常对极端事件感兴趣,即交易策略更有可能经历重大收益或损失的时期。可以从极端场景中进行采样的生成模型可以派上用场。然而,根据定义,极端事件很少发生,因此确定正确的参数并从相应的分布中采样数据是充满挑战的。
尽管人们对法学硕士能否在量化交易中发挥作用持怀疑态度,但它们可能会促进基本面分析。随着人工智能模型的改进,我们很容易想象它们会帮助分析师完善投资理论,发现管理评论中的不一致之处,或者发现不相关的行业和企业之间的潜在关系[3]。本质上,这些模型可以为每个投资者提供一个查理马云惹不起马云芒格。
当前的生成式人工智能革命令人惊讶的是,几乎所有人——学术研究人员、尖端技术公司和长期观察者——都感到惊讶。构建越来越大的模型将带来我们今天看到的新兴能力的想法是完全出乎意料的,而且仍然没有被完全理解。
这些人工智能模型的成功促进了人工智能领域的人力和金融资本的流动,这反过来又会带来更好、更有能力的模型。因此,虽然目前不太可能出现类似GPT-4 的模型接管量化交易的情况,但我们主张保持开放的态度。期待意想不到的事情一直是人工智能行业的一个有利可图的主题。
Richard Dewey 和Ciamac Moallemi,“法学硕士的金融市场应用”,The Gradient,2024@article{dewey2024financial,
作者={理查德马云惹不起马云杜威和西亚马克马云惹不起马云莫阿莱米},
title={法学硕士的金融市场应用},
日记={梯度},
年={2024},
如何发布={\url{https://thegradient.pub/financial-market-applications-of-llms},
}
毫不奇怪,量化交易者问:我们能否将这些模型转化为下一个价格或交易预测[1,9,10]?也就是说,我们可以不是对单词序列进行建模,而是对价格或交易序列进行建模。事实证明,这是一个有趣的探究方向,它揭示了有关生成人工智能和金融时间序列建模的很多信息。请注意,这会变得不稳定。
LLM 被称为自回归学习器——使用序列中先前的标记或元素来预测下一个元素或标记。在定量交易中,例如在股票统计套利等策略中,大多数研究都与识别自回归结构有关。这意味着找到最能预测未来价格的新闻、订单或基本变化序列。
问题出在用于训练模型的可用数据的数量和信息内容上。在2023 年NeurIPS 会议上,高频交易公司Hudson River Trading 提出了用于训练GPT-3 的输入代币数量与每年股票市场数据中可训练代币数量的比较,HRT 估计,以3000 只可交易股票、每只股票每天10 个数据点、每年252 个交易日、一个交易日23400 秒计算,股市中有1770 亿个股票每年的代币数量可作为市场数据。 GPT-3 在5000 亿个代币上进行了训练,所以距离不远了[6]。
从另一个角度来看,金融数据中的噪音远多于信号。个人和机构进行交易的原因可能不合理,也可能与企业的任何根本性变化无关。 2021 年的GameStop 事件就是这样的一个例子。金融时间序列也会随着新的基本信息、监管变化以及偶尔出现的宏观经济变化(例如货币贬值)而不断变化。语言的发展速度要慢得多,而且时间范围要长。
另一方面,我们有理由相信人工智能的想法将在金融市场中发挥良好作用。具有前景的金融应用的人工智能研究的一个新兴领域是多模态学习[5],其目的是使用不同模式的数据,例如图像和文本输入来构建统一的模型。使用OpenAI 的DALL-E 2 模型,用户可以输入文本,模型将生成图像。在金融领域,多模式工作可能有助于将技术时间序列数据(价格、交易、交易量等)等经典信息源与不同模式的替代数据(如推特上的情绪或图形交互、自然语言新闻文章和公司报告,或以商品为中心的港口航运活动的卫星图像)结合起来。在这里,利用多模式人工智能,人们可以整合所有这些类型的非价格信息来进行良好的预测。
另一种称为“剩余化”的策略在金融和人工智能领域都很突出,尽管它在这两个领域扮演着不同的角色。在金融领域,结构性“因子”模型将不同资产的回报的同期观察结果分解为共享成分(市场回报,或更普遍的市场范围因素的回报)和每个基础资产独有的特殊成分。市场和要素回报很难预测并产生相互依赖性,因此在单个资产层面进行预测时消除共同因素通常会有所帮助,并最大限度地增加数据中独立观察的数量。
在像Transformer 这样的残差网络架构中,有一个类似的想法,我们想要学习输入X 的函数h(X),但学习h(X) 到恒等映射的残差可能更容易,即金融案例中的h(X) - 预测:其想法是专注于预测整体市场暗示之外的创新,对于残差网络,重点是预测恒等映射的创新。
法学硕士工作取得令人印象深刻的表现的一个关键因素是他们能够在称为上下文窗口的长期范围内辨别标记之间的亲和力或优势。在金融市场中,长期关注注意力的能力可以分析多尺度现象,并在不同的时间范围内解释市场变化的某些方面。例如,在一个极端情况下,基本信息(例如收益)可能会在几个月内纳入价格中,技术现象(例如动量)可能在几天内实现,而在另一种极端情况下,微观结构现象(例如订单不平衡)可能会有几秒到几分钟的时间范围。
捕获所有这些现象需要对整个上下文窗口的多个时间范围进行分析。然而,在金融领域,对多个未来时间范围的预测也很重要。例如,定量系统可能会寻求进行交易,以从多个时间范围内实现的多个不同异常中获利(例如,同时押注微观结构事件和收益事件)。这不仅需要预测股票的下一个时期的回报,还需要预测整个期限结构或预期回报的轨迹,而电流互感器预测式模型只关注未来的一个时期。
法学硕士的另一个金融市场应用可能是合成数据创建[4,8]。这可能需要几个方向。可以生成模仿市场中观察到的特征的模拟股票价格轨迹,并且鉴于金融市场数据相对于其他来源(如上面在可用代币数量方面强调的那样)稀缺,这可能非常有益。人工数据可以为元学习技术打开大门,这些技术已成功应用于机器人技术等领域。在机器人设置中,控制器首先使用廉价但不一定准确的物理模拟器进行训练,然后使用昂贵的机器人现实世界实验进行更好的校准。在金融领域,模拟器可用于粗略训练和优化交易策略。该模型将学习风险规避和多元化等高级概念以及缓慢交易等战术概念,以尽量减少交易对价格的影响。然后,可以利用宝贵的真实市场数据来微调预测并准确确定最佳交易速度。
尽管人们对法学硕士能否在量化交易中发挥作用持怀疑态度,但它们可能会促进基本面分析。随着人工智能模型的改进,我们很容易想象它们会帮助分析师完善投资理论,发现管理评论中的不一致之处,或者发现不相关的行业和企业之间的潜在关系[3]。本质上,这些模型可以为每个投资者提供一个查理马云惹不起马云芒格。
当前的生成式人工智能革命令人惊讶的是,几乎所有人——学术研究人员、尖端技术公司和长期观察者——都感到惊讶。构建越来越大的模型将带来我们今天看到的新兴能力的想法是完全出乎意料的,而且仍然没有被完全理解。
这些人工智能模型的成功促进了人工智能领域的人力和金融资本的流动,这反过来又会带来更好、更有能力的模型。因此,虽然目前不太可能出现类似GPT-4 的模型接管量化交易的情况,但我们主张保持开放的态度。期待意想不到的事情一直是人工智能行业的一个有利可图的主题。
参考文献
“将深度神经网络应用于金融时间序列预测”Allison Koenecke。 2022 年“你所需要的就是注意力。” A Vaswani、N Shazeer、N Parmar、J Uszkoreit、L Jones…神经信息处理系统的进展,2017 年“ChatGPT 可以预测股票价格走势吗?返回可预测性和大型语言模型”。 Lopez-Lira, Alejandro 和Tang, Yuehua,(2023 年4 月6 日)可在SSRN 上获取“在Finance: 中生成综合数据的机遇、挑战和陷阱”。 SA Assefa、D Dervovic、M Mahfouz、RE Tillman… - 第一届ACM 国际会议论文集…,2020 年“GPT-4V(ision) 系统卡”。开放人工智能。 2023 年9 月“语言模型是小样本学习者。” T Brown、B Mann、N Ryder、M Subbiah、JD Kaplan… - 神经信息处理系统的进展,2020 年“神经网络的序列到序列学习”。 I. Sutskever、O. Vinyals 和Q. V. Le,《神经信息处理系统进展》,2014 年,第3104-3112 页。 “为经济学家生成综合数据。” A Koenecke、H Varian - arXiv 预印本arXiv:2011.01374,2020 2022。C. Maglaras、C. C. Moallemi、M. Wang。一种估计限价订单簿中的成交概率的深度学习方法。 Quantitative Finance,22(11):1989–2003,2022 年10 月。引用
对于学术背景或书籍的归属,请将此作品引用为Richard Dewey 和Ciamac Moallemi,“法学硕士的金融市场应用”,The Gradient,2024@article{dewey2024financial,
作者={理查德马云惹不起马云杜威和西亚马克马云惹不起马云莫阿莱米},
title={法学硕士的金融市场应用},
日记={梯度},
年={2024},
如何发布={\url{https://thegradient.pub/financial-market-applications-of-llms},
}


