


8
月
在社区成长 8 月
LEVEL 90
100 XP
特别感谢约翰马云惹不起马云舒尔曼(John Schulman)对这篇文章提供了许多非常有价值的反馈和直接编辑。
测试时间计算(Graves 等人,2016 年;Ling 等人,2017 年;Cobbe 等人,2021 年)和思想链(CoT)(Wei 等人,2022 年;Nye 等人,2021 年)显着改进了模型性能,同时提出了许多研究问题。这篇文章旨在回顾如何有效使用测试时计算(即“思考时间”)的最新进展以及它为何有帮助。
快速思维(系统1)在直觉和情感的驱动下快速、自动地运作,几乎不需要任何努力。
缓慢的思维(系统2)需要深思熟虑的逻辑思维和显着的认知努力。这种思维方式消耗更多的精神能量,需要刻意投入。
由于系统1 思维快速而简单,因此它通常最终成为主要决策驱动因素,但代价是准确性和逻辑性。它自然依赖于我们大脑的思维捷径(即启发式),并可能导致错误和偏见。通过有意识地放慢脚步,花更多时间反思、改进和分析,我们可以进行系统2思维,挑战我们的直觉,做出更理性的选择。
在Transformer 模型中,模型对每个生成的令牌执行的计算量(触发器)大约是参数数量的2 倍。对于专家混合(MoE) 等稀疏模型,每次前向传递中仅使用一小部分参数,因此计算量=2 * 参数/稀疏度,其中稀疏度是活跃专家的比例。
另一方面,CoT 使模型能够对其尝试计算的答案的每个标记执行更多的计算次数。事实上,CoT 有一个很好的特性,它允许模型根据问题的难度使用可变的计算量。
 =\sum_{z \sim P(z)} P(y \mid z)$。例如,我们可以通过让$x$ 表示问题陈述,$y$ 表示真实答案或证明,而$z$ 作为导致证明的自由形式思维过程,来对数学问题和解决方案的分布进行建模。要优化的边际概率分布为$P(y \mid x)=\sum_{z \sim p(z\mid x)} P(y \mid x, z)$
潜变量视角对于理解涉及收集多个并行CoT 或在CoT 上搜索的方法特别有用- 这些算法可以看作是从后验$P(z \mid x, y)$ 中采样。这种观点还表明了使用对数损失$\log P(y \mid x)$ 作为优化目标的好处,因为对数损失目标在预训练中非常有效。
改进CoT 推理的早期工作涉及对人类编写的推理轨迹或模型编写的轨迹进行监督学习,并过滤答案的正确性,后者可以被视为强化学习(RL) 的基本形式。其他一些研究发现,通过适当提示,通过“一步一步思考”(Kojima et al. 2022)或更复杂的提示来鼓励模型首先反思相关知识(Yasunaga et al. 2023),可以显着提高指令调整模型的数学性能。
后来的工作发现,通过对具有可自动检查解决方案的问题数据集进行强化学习,可以显着提高CoT 推理能力,例如具有简短答案的STEM 问题,或可以通过单元测试检查的编码任务(Zelikman et al. 2022、Wang et al. 2023、Liu et al. 2023)。随着o1-preview、o3 和R1 技术报告(DeepSeek-AI,2025)的发布,这种方法变得引人注目,该报告表明,策略梯度算法可以通过简单的方法带来强大的性能。
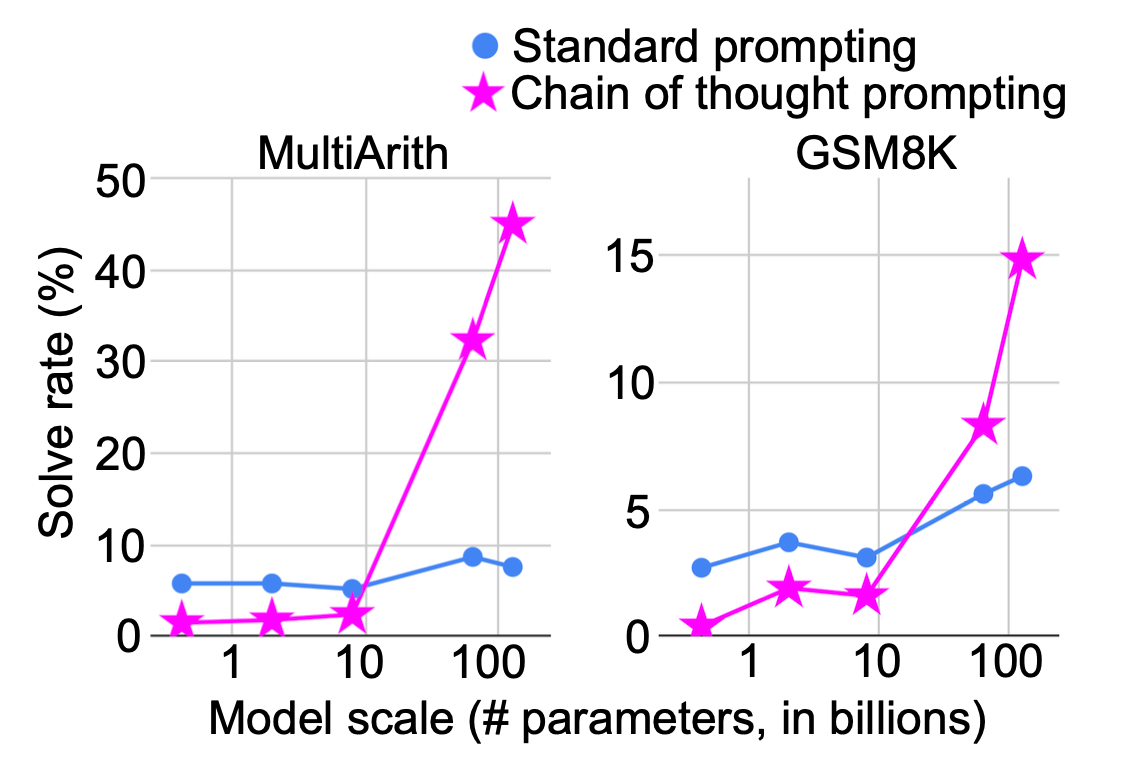 思维链提示提高解决数学问题的成功率。较大的模型从思考时间中获益更多。 (图片来源: Wei et al. 2022)
并行采样同时生成多个输出,同时通过过程奖励信号提供每个步骤的指导或使用验证器来判断最终的质量。它是最广泛采用的用于提高测试时间性能的解码方法,例如best-of-$N$ 或波束搜索。当基本事实不可用时,自我一致性(Wang et al. 2023)通常用于在多次CoT 推出中选择具有多数票的答案。
顺序修订根据上一步的输出迭代地调整模型的响应,要求模型有意反映其现有响应并纠正错误。修订过程可能必须依赖于微调模型,因为天真地依赖模型内在的自我修正能力而没有外部反馈可能不会带来改进(Kamoi et al. 2024,Huang et al. 2024)。
并行采样简单直观,更容易实现,但受限于模型能力能否一次性得出正确解。顺序明确要求模型反思错误,但速度较慢,并且在实施过程中需要格外小心,因为它确实存在正确的预测被修改为不正确的风险或引入其他类型的幻觉的风险。这两种方法可以一起使用。斯内尔等人。 (2024)表明,更简单的问题受益于纯粹的顺序测试时间计算,而更困难的问题通常在顺序与并行计算的最佳比率下表现最佳。
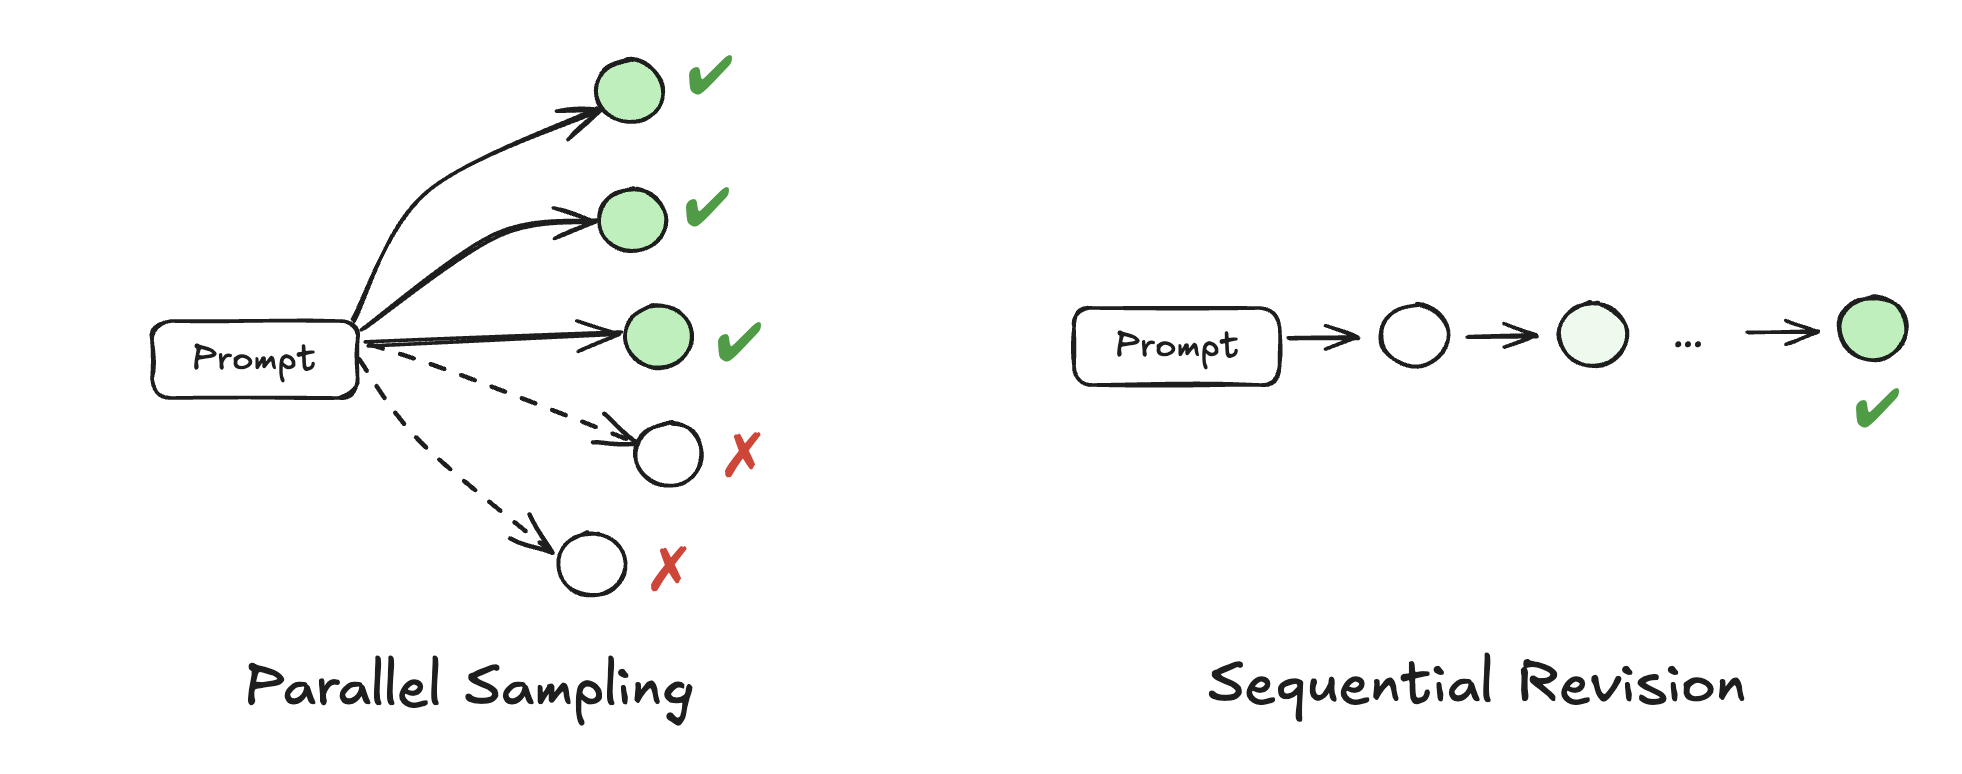 并行采样与顺序修订的图示。
集束搜索维护一组有希望的部分序列,并在扩展它们和修剪不太有希望的序列之间交替。作为一种选择机制,我们可以使用过程奖励模型(PRM;Lightman et al. 2023)来指导波束搜索候选者选择。波束搜索解码。此外,在采样过程中,退火温度有助于减轻聚合随机性。 Xie 等人的这些实验。使用Codex 模型在少数样本GSM8k、AQuA 和StrategyQA 基准测试中实现了5-6% 的改进。奖励平衡搜索(“REBASE”的缩写;Wu et al. 2025)单独训练了一个过程奖励模型(PRM),根据softmax 归一化奖励分数,确定在波束搜索期间每个节点在每个深度应扩展多少。江等人。 (2024)训练了他们的PRM,名为“RATIONALYST”,用于以大量未标记数据为条件的合成原理的束搜索指导。根据是否有助于减少真实答案的负对数概率来过滤好的理由
测试时间计算(Graves 等人,2016 年;Ling 等人,2017 年;Cobbe 等人,2021 年)和思想链(CoT)(Wei 等人,2022 年;Nye 等人,2021 年)显着改进了模型性能,同时提出了许多研究问题。这篇文章旨在回顾如何有效使用测试时计算(即“思考时间”)的最新进展以及它为何有帮助。
动机#
可以通过几种不同的方式激励模型思考更长时间。心理学类比#
核心思想与人类的思维方式密切相关。我们人类无法立即回答“12345 乘以56789 等于多少?”。相反,在得到结果之前花时间思考和分析是很自然的,尤其是对于复杂的问题。在《思考,快与慢》(Thinking, Fast and Slow)(卡尼曼,2013 年)中,丹尼尔马云惹不起马云卡尼曼(Daniel Kahneman) 通过双过程理论的支出镜头,将人类思维分为两种模式:快速思维(系统1)在直觉和情感的驱动下快速、自动地运作,几乎不需要任何努力。
缓慢的思维(系统2)需要深思熟虑的逻辑思维和显着的认知努力。这种思维方式消耗更多的精神能量,需要刻意投入。
由于系统1 思维快速而简单,因此它通常最终成为主要决策驱动因素,但代价是准确性和逻辑性。它自然依赖于我们大脑的思维捷径(即启发式),并可能导致错误和偏见。通过有意识地放慢脚步,花更多时间反思、改进和分析,我们可以进行系统2思维,挑战我们的直觉,做出更理性的选择。
计算作为资源#
深度学习的一种观点是,神经网络可以通过它们在前向传递中可以访问的计算量和存储量来表征,如果我们优化它们以使用梯度下降来解决问题,优化过程将弄清楚如何使用这些资源- 他们将弄清楚如何将这些资源组织到电路中以进行计算和信息存储。从这个角度来看,如果我们设计一个可以在测试时进行更多计算的架构或系统,并训练它有效地使用这些资源,那么它会工作得更好。在Transformer 模型中,模型对每个生成的令牌执行的计算量(触发器)大约是参数数量的2 倍。对于专家混合(MoE) 等稀疏模型,每次前向传递中仅使用一小部分参数,因此计算量=2 * 参数/稀疏度,其中稀疏度是活跃专家的比例。
另一方面,CoT 使模型能够对其尝试计算的答案的每个标记执行更多的计算次数。事实上,CoT 有一个很好的特性,它允许模型根据问题的难度使用可变的计算量。
潜变量建模#
机器学习中的一个经典思想是定义一个带有潜在(隐藏)变量$z$ 和可见变量$y$ 的概率模型,其中$y$ 被赋予我们的学习算法。对潜在变量的可能值进行边际化(求和)使我们能够表达可见变量的丰富分布,$P=\sum_{z \sim P(z)} P(y \mid z)$。例如,我们可以通过让$x$ 表示问题陈述,$y$ 表示真实答案或证明,而$z$ 作为导致证明的自由形式思维过程,来对数学问题和解决方案的分布进行建模。要优化的边际概率分布为$P(y \mid x)=\sum_{z \sim p(z\mid x)} P(y \mid x, z)$潜变量视角对于理解涉及收集多个并行CoT 或在CoT 上搜索的方法特别有用- 这些算法可以看作是从后验$P(z \mid x, y)$ 中采样。这种观点还表明了使用对数损失$\log P(y \mid x)$ 作为优化目标的好处,因为对数损失目标在预训练中非常有效。
用代币思考#
Ling 等人探索了在生成简短答案之前生成中间步骤的策略,特别是对于数学问题。 2017年,他引入了AQUA-RAT数据集,然后由Cobbe等人扩展。 2021 年,他引入了小学数学(GSM) 数据集。科布等人。使用人工编写的解决方案和验证器来训练具有监督学习的生成器,以预测候选解决方案的正确性;然后他们可以搜索这些解决方案。奈等人。 Wei 等人(2021) 尝试使用中间思维标记作为“便签本”。 (2022)创造了现在的标准术语“思想链”(CoT)。改进CoT 推理的早期工作涉及对人类编写的推理轨迹或模型编写的轨迹进行监督学习,并过滤答案的正确性,后者可以被视为强化学习(RL) 的基本形式。其他一些研究发现,通过适当提示,通过“一步一步思考”(Kojima et al. 2022)或更复杂的提示来鼓励模型首先反思相关知识(Yasunaga et al. 2023),可以显着提高指令调整模型的数学性能。
后来的工作发现,通过对具有可自动检查解决方案的问题数据集进行强化学习,可以显着提高CoT 推理能力,例如具有简短答案的STEM 问题,或可以通过单元测试检查的编码任务(Zelikman et al. 2022、Wang et al. 2023、Liu et al. 2023)。随着o1-preview、o3 和R1 技术报告(DeepSeek-AI,2025)的发布,这种方法变得引人注目,该报告表明,策略梯度算法可以通过简单的方法带来强大的性能。
分支和编辑#
测试时计算的基本目的是在测试时自适应地修改模型的输出分布。有多种方法可以利用测试时间资源进行解码,以选择更好的样本,从而将模型的预测更改为更理想的分布。改进解码过程的两种主要方法是并行采样和顺序修正。并行采样同时生成多个输出,同时通过过程奖励信号提供每个步骤的指导或使用验证器来判断最终的质量。它是最广泛采用的用于提高测试时间性能的解码方法,例如best-of-$N$ 或波束搜索。当基本事实不可用时,自我一致性(Wang et al. 2023)通常用于在多次CoT 推出中选择具有多数票的答案。
顺序修订根据上一步的输出迭代地调整模型的响应,要求模型有意反映其现有响应并纠正错误。修订过程可能必须依赖于微调模型,因为天真地依赖模型内在的自我修正能力而没有外部反馈可能不会带来改进(Kamoi et al. 2024,Huang et al. 2024)。
并行采样简单直观,更容易实现,但受限于模型能力能否一次性得出正确解。顺序明确要求模型反思错误,但速度较慢,并且在实施过程中需要格外小心,因为它确实存在正确的预测被修改为不正确的风险或引入其他类型的幻觉的风险。这两种方法可以一起使用。斯内尔等人。 (2024)表明,更简单的问题受益于纯粹的顺序测试时间计算,而更困难的问题通常在顺序与并行计算的最佳比率下表现最佳。
并行采样#
给定一个生成模型和一个评分函数,我们可以使用它来对全部或部分样本进行评分,我们可以使用各种搜索算法来查找高评分样本。 Best-of-$N$ 是此类算法中最简单的一种,它只是收集$N$ 个独立样本,并根据某种评分函数选择排名最高的样本。束搜索是一种更复杂的搜索算法,它使搜索过程更具适应性,在解决方案空间中更有希望的部分上花费更多的采样计算。集束搜索维护一组有希望的部分序列,并在扩展它们和修剪不太有希望的序列之间交替。作为一种选择机制,我们可以使用过程奖励模型(PRM;Lightman et al. 2023)来指导波束搜索候选者选择。波束搜索解码。此外,在采样过程中,退火温度有助于减轻聚合随机性。 Xie 等人的这些实验。使用Codex 模型在少数样本GSM8k、AQuA 和StrategyQA 基准测试中实现了5-6% 的改进。奖励平衡搜索(“REBASE”的缩写;Wu et al. 2025)单独训练了一个过程奖励模型(PRM),根据softmax 归一化奖励分数,确定在波束搜索期间每个节点在每个深度应扩展多少。江等人。 (2024)训练了他们的PRM,名为“RATIONALYST”,用于以大量未标记数据为条件的合成原理的束搜索指导。根据是否有助于减少真实答案的负对数概率来过滤好的理由


