


8
月
在社区成长 8 月
LEVEL 50
100 XP
ChatGPT 的推出极大地加速了大型语言模型在现实世界中的使用。我们(包括我在OpenAI 的团队,向他们致敬)投入了大量精力,在对齐过程中(例如通过RLHF)在模型中构建默认的安全行为。然而,对抗性攻击或越狱提示可能会触发模型输出不需要的内容。
对抗性攻击的大量基础工作都是在图像上进行的,不同的是,它在连续的高维空间中运行。由于缺乏直接梯度信号,对文本等离散数据的攻击被认为更具挑战性。我过去关于可控文本生成的文章与这个主题非常相关,因为攻击LLM 本质上是控制模型输出某种类型的(不安全)内容。
还有一个工作分支是攻击法学硕士以提取预训练数据、私有知识(Carlini 等人,2020)或通过数据中毒攻击模型训练过程(Carlini 等人,2023)。我们不会在这篇文章中讨论这些主题。
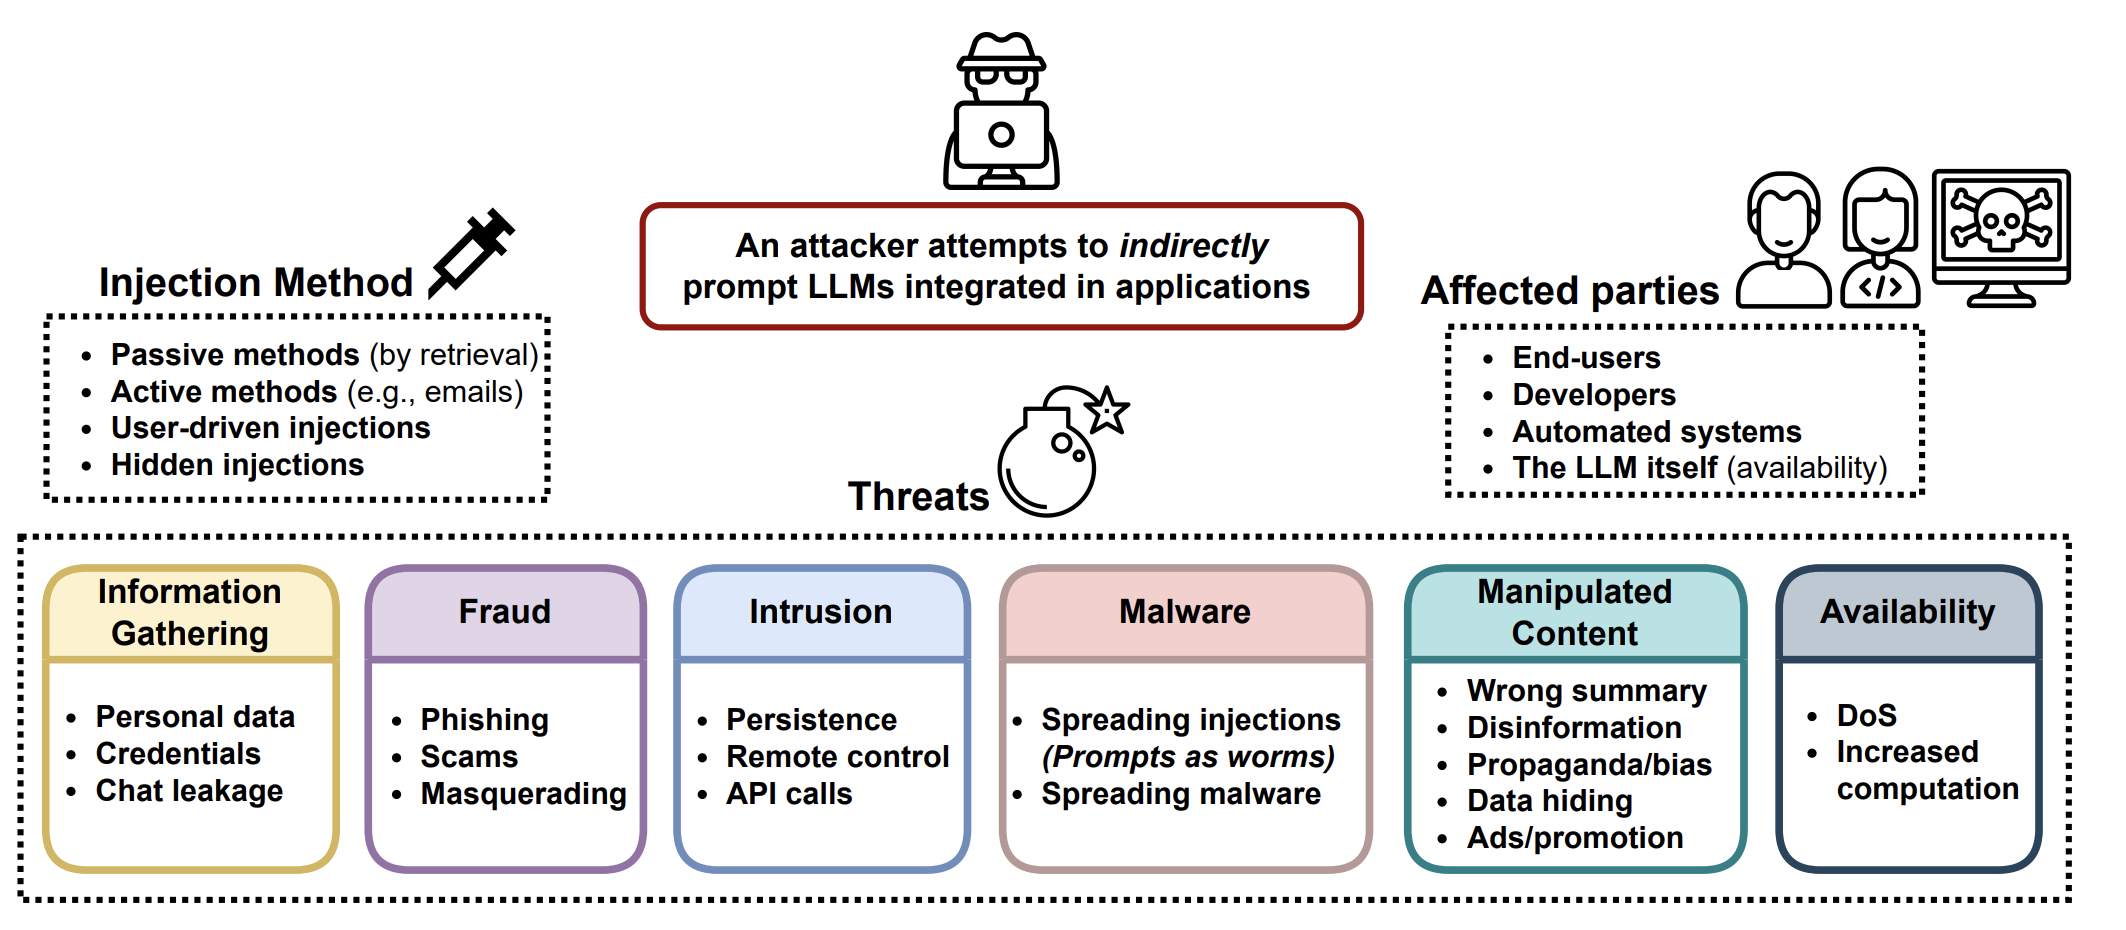 基于LLM 的应用程序的威胁概述。 (图片来源: Greshake et al. 2023)
黑盒攻击假设攻击者只能访问类似API 的服务,在其中提供输入$\mathbf{x}$ 并获取样本$\mathbf{y}$,而不知道有关模型的进一步信息。
攻击
类型
描述
代币操纵
黑匣子
更改文本输入中的一小部分标记,使其触发模型失败,但仍保留其原始语义。
基于梯度的攻击
白盒
依靠梯度信号来学习有效的攻击。
越狱提示
黑匣子
通常基于启发式提示来“越狱”内置模型安全性。
人类红队
黑匣子
无论是否有其他模型的帮助,人类都会攻击模型。
模型红队
黑匣子
模型攻击模型,其中攻击者模型可以进行微调。
Ribeiro 等人(2018)依靠手动提出的语义等效对手规则(SEAR)来进行最少的标记操作,从而使模型无法生成正确的答案。示例规则包括(What NOUN→Which NOUN)、(WP is → WP’s’)、(was→is)等。对抗性操作后的语义等价性通过反向翻译进行检查。这些规则是通过相当手动的启发式流程提出的,SEAR 正在探测的模型“错误”类型仅局限于对最小代币变化的敏感性,这不应该成为增加基础LLM 能力的问题。
相比之下,EDA(Easy Data Augmentation;Wei Zou 2019)定义了一组简单且更通用的操作来增强text: 同义词替换、随机插入、随机交换或随机删除。 EDA 增强已被证明可以提高多个基准的分类准确性。
TextFooler (Jin et al. 2019) 和BERT-Attack (Li et al. 2020) 遵循相同的过程,首先识别对模型预测影响最大的最重要和最脆弱的单词,然后以某种方式替换这些单词。
给定一个分类器$f$和一个输入文本字符串$\mathbf{x}$,每个单词的重要性得分可以通过:来衡量
$$
I(w_i)=\begin{案例}
f_y(\mathbf{x}) - f_y(\mathbf{x}_{\setminus w_i}) \text{if }f(\mathbf{x})=f(\mathbf{x}_{\setminus w_i})=y\\
(f_y(\mathbf{x}) - f_y(\mathbf{x}_{\setminus w_i})) + ((f_{\bar{y}}(\mathbf{x}) - f_{\bar{y}}(\mathbf{x}_{\setminus w_i}))) \text{if }f(\mathbf{x})=y, f(\mathbf{x}_{\setminus w_i})=\bar{y}, y \neq \bar{y}
\结束{案例}
$$
其中$f_y$是标签$y$的预测logits,$x_{\setminus w_i}$是不包括目标词$w_i$的输入文本。具有高重要性的单词是替换的良好候选词,但应跳过停用词以避免语法破坏。
TextFooler 根据单词嵌入余弦相似度将这些单词替换为顶级同义词,然后通过检查替换单词是否仍然具有相同的POS 标记以及句子级别相似度高于阈值来进一步过滤。鉴于上下文感知预测是屏蔽语言模型的一个非常自然的用例,BERT-Attack 通过BERT 将单词替换为语义相似的单词。通过这种方式发现的对抗性示例在模型之间具有一定的可转移性,具体取决于模型和任务。
GBDA(“基于梯度的分布式攻击”;Guo et al. 2021)使用Gumbel-Softmax 近似技巧使对抗性损失优化可微,其中使用BERTScore 和困惑度来增强可感知性和流畅性。给定一个标记$\mathbf{x}=[x_1, x_2 \dots x_n]$ 的输入,其中一个标记$x_i$ 可以从分类分布$P_\Theta$ 中采样,其中$\Theta \in \mathbb{R}^{n \times V}$ 和$V$ 是标记词汇量大小。考虑到$V$ 通常约为$O(10,000)$ 并且大多数对抗性示例只需要一些令牌替换,它是高度过度参数化的。我们有:
$$
x_i \sim P_{\Theta_i}=\text{分类}(\pi_i)=\text{分类}(\text{Softmax}(\Theta_i))
$$
其中$\pi_i \in \mathbb{R}^V$ 是第$i$ 个标记的标记概率向量。要最小化的对抗性目标函数是为分类器$f$: $\min_{\Theta \in \mathbb{R}^{n \times V}} \mathbb{E}_{\mathbf{x} \sim P_{\Theta}} \mathcal{L}_\text{adv}(\mathbf{X}, y; 生成与正确标签$y$ 不同的错误标签f)$。然而,从表面上看,由于分类分布,这是不可微分的。使用Gumbel-softmax 近似(Jang et al. 2016),我们通过$\tilde{\boldsymbol{\pi}}$: 近似Gumbel 分布$\tilde{P}_\Theta$ 的分类分布
$$
\tilde{\pi}_i^{(j)}=\frac{\exp(\frac{\Theta_{ij} + g_{ij}}{\tau})}{\sum_{v=1}^V \exp(\frac{\Theta_{iv} + g_{iv}}{\tau})}
$$
其中$g_{ij} \sim \text{Gumbel}(0, 1)$;温度$\tau 0$ 控制分布的平滑度。
Gumbel 分布用于对多个样本的极值(最大值或最小值)进行建模,而与样本分布无关。额外的Gumbel 噪声带来了模拟分类分布采样过程的随机决策。
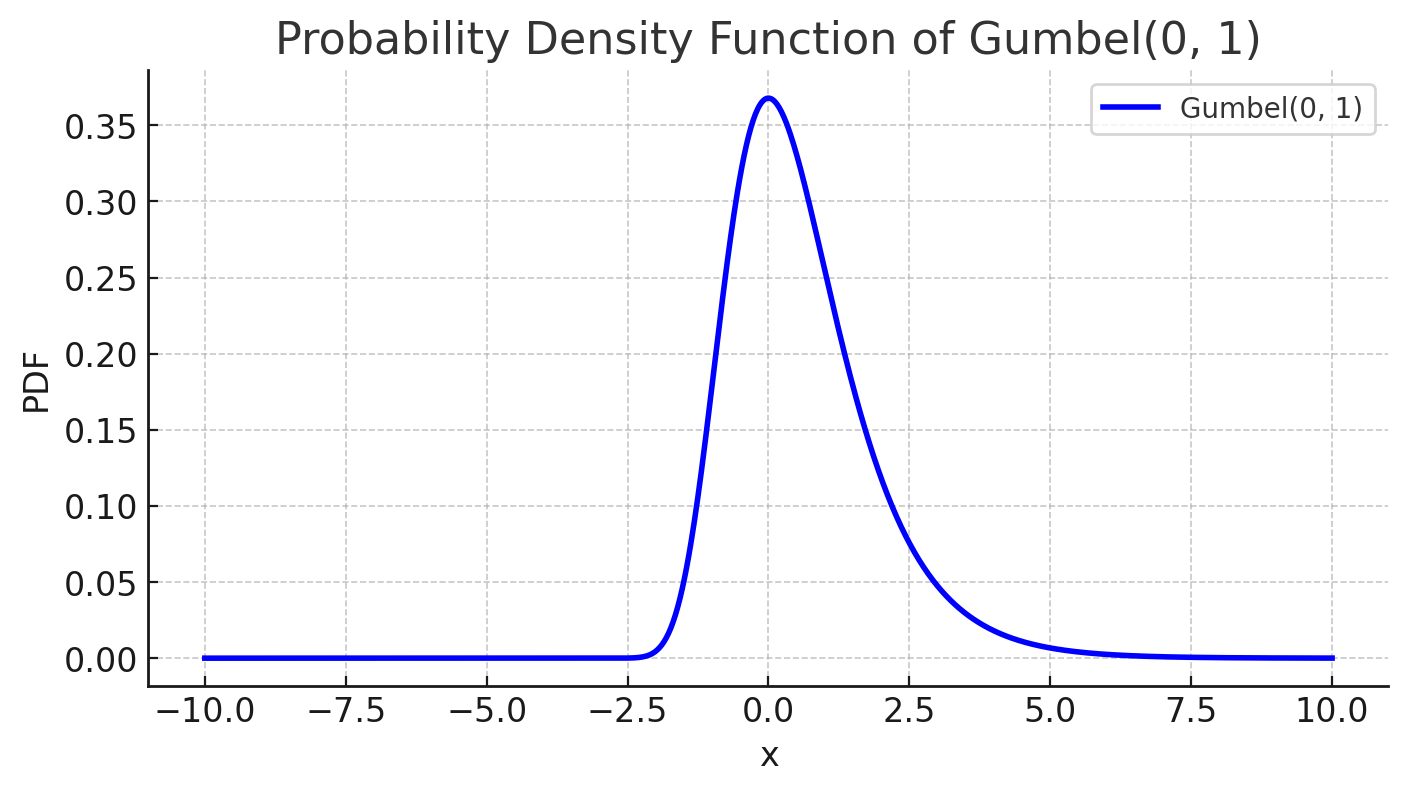 $\text{Gumbel}(0, 1)$的概率密度图。 (图片由ChatGPT 创建)低温$\tau \to 0$ 将收敛推向分类分布,因为从温度为0 的softmax 中采样是确定性的。 “采样”部分仅取决于$g_{ij}$ 的值,该值大多以0 为中心。
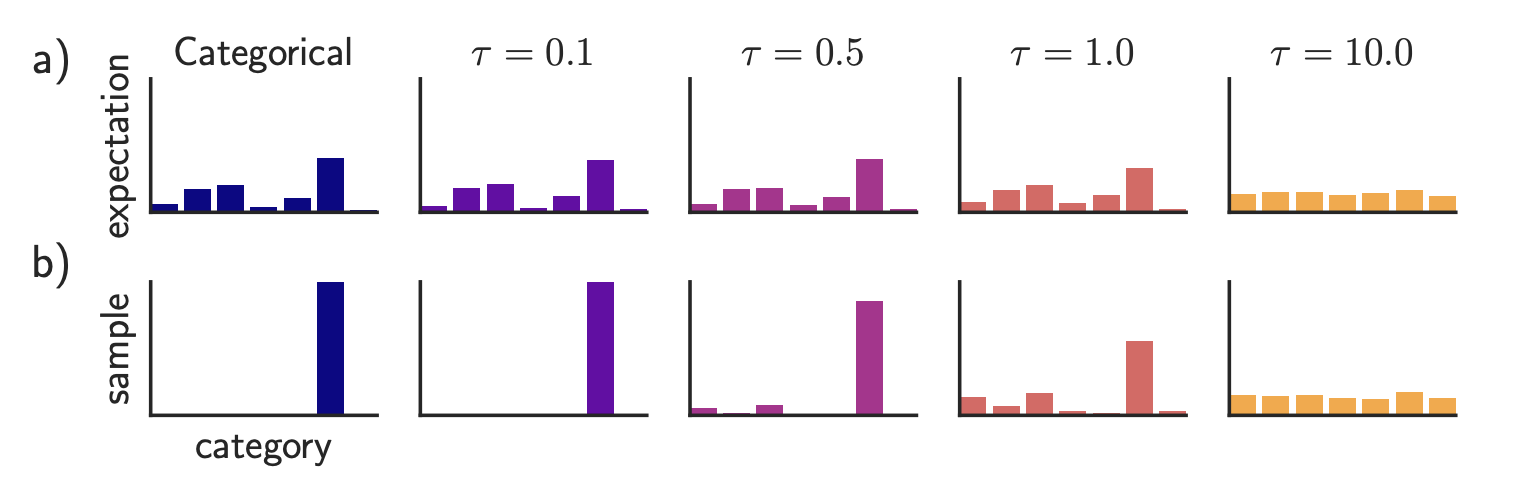 当温度$\tau \到0$时,反映的是原始分类分布。当$\tau \to \infty$时,就变成均匀分布了。 Gumbel softmax 分布的期望和样本非常匹配。 (图片来源: Jang et al. 2016)令$\mathbf{e}_j$ 为标记$j$ 的嵌入表示。我们
对抗性攻击的大量基础工作都是在图像上进行的,不同的是,它在连续的高维空间中运行。由于缺乏直接梯度信号,对文本等离散数据的攻击被认为更具挑战性。我过去关于可控文本生成的文章与这个主题非常相关,因为攻击LLM 本质上是控制模型输出某种类型的(不安全)内容。
还有一个工作分支是攻击法学硕士以提取预训练数据、私有知识(Carlini 等人,2020)或通过数据中毒攻击模型训练过程(Carlini 等人,2023)。我们不会在这篇文章中讨论这些主题。
基础知识#
威胁模型#
对抗性攻击是触发模型输出不需要的内容的输入。许多早期文献都集中在分类任务上,而最近的努力开始更多地研究生成模型的输出。在大型语言模型的背景下,在这篇文章中,我们假设攻击仅发生在推理时,这意味着模型权重是固定的。
分类#
对分类器的对抗性攻击过去在研究界引起了更多的关注,其中许多是在图像领域。 LLM 也可用于分类。给定输入$\mathbf{x}$ 和分类器$f(.)$,我们希望找到输入的对抗版本,表示为$\mathbf{x}_\text{adv}$,与$\mathbf{x}$ 存在难以察觉的差异,例如$f(\mathbf{x}) \neq f(\mathbf{x}_\text{adv})$。文本生成#
给定输入$\mathbf{x}$ 和生成模型$p(.)$,我们让模型输出样本$\mathbf{y} \sim p(.\vert\mathbf{x})$ 。对抗性攻击会识别出这样的$p(\mathbf{x})$ ,即$\mathbf{y}$ 会违反模型$p$ 的内置安全行为;例如。输出非法主题的不安全内容、泄露私人信息或模型训练数据。对于生成任务来说,判断攻击是否成功并不容易,这需要超高质量的分类器来判断$\mathbf{y}$是否不安全或人工审查。白盒与黑盒#
白盒攻击假设攻击者可以完全访问模型权重、架构和训练管道,以便攻击者可以获得梯度信号。我们不假设攻击者可以访问完整的训练数据。这仅适用于开源模型。黑盒攻击假设攻击者只能访问类似API 的服务,在其中提供输入$\mathbf{x}$ 并获取样本$\mathbf{y}$,而不知道有关模型的进一步信息。
对抗性攻击的类型#
有多种方法可以找到对抗性输入来触发LLM 输出不需要的内容。我们在这里提出五种方法。攻击
类型
描述
代币操纵
黑匣子
更改文本输入中的一小部分标记,使其触发模型失败,但仍保留其原始语义。
基于梯度的攻击
白盒
依靠梯度信号来学习有效的攻击。
越狱提示
黑匣子
通常基于启发式提示来“越狱”内置模型安全性。
人类红队
黑匣子
无论是否有其他模型的帮助,人类都会攻击模型。
模型红队
黑匣子
模型攻击模型,其中攻击者模型可以进行微调。
令牌操作#
给定一段包含一系列标记的文本输入,我们可以应用简单的标记操作(例如用同义词替换)来触发模型做出错误的预测。基于令牌操纵的攻击在黑匣子设置中起作用。 Python 框架TextAttack(Morris 等人,2020)实现了许多单词和标记操作攻击方法,为NLP 模型创建对抗性示例。该领域的大部分工作都涉及分类和蕴含预测。Ribeiro 等人(2018)依靠手动提出的语义等效对手规则(SEAR)来进行最少的标记操作,从而使模型无法生成正确的答案。示例规则包括(What NOUN→Which NOUN)、(WP is → WP’s’)、(was→is)等。对抗性操作后的语义等价性通过反向翻译进行检查。这些规则是通过相当手动的启发式流程提出的,SEAR 正在探测的模型“错误”类型仅局限于对最小代币变化的敏感性,这不应该成为增加基础LLM 能力的问题。
相比之下,EDA(Easy Data Augmentation;Wei Zou 2019)定义了一组简单且更通用的操作来增强text: 同义词替换、随机插入、随机交换或随机删除。 EDA 增强已被证明可以提高多个基准的分类准确性。
TextFooler (Jin et al. 2019) 和BERT-Attack (Li et al. 2020) 遵循相同的过程,首先识别对模型预测影响最大的最重要和最脆弱的单词,然后以某种方式替换这些单词。
给定一个分类器$f$和一个输入文本字符串$\mathbf{x}$,每个单词的重要性得分可以通过:来衡量
$$
I(w_i)=\begin{案例}
f_y(\mathbf{x}) - f_y(\mathbf{x}_{\setminus w_i}) \text{if }f(\mathbf{x})=f(\mathbf{x}_{\setminus w_i})=y\\
(f_y(\mathbf{x}) - f_y(\mathbf{x}_{\setminus w_i})) + ((f_{\bar{y}}(\mathbf{x}) - f_{\bar{y}}(\mathbf{x}_{\setminus w_i}))) \text{if }f(\mathbf{x})=y, f(\mathbf{x}_{\setminus w_i})=\bar{y}, y \neq \bar{y}
\结束{案例}
$$
其中$f_y$是标签$y$的预测logits,$x_{\setminus w_i}$是不包括目标词$w_i$的输入文本。具有高重要性的单词是替换的良好候选词,但应跳过停用词以避免语法破坏。
TextFooler 根据单词嵌入余弦相似度将这些单词替换为顶级同义词,然后通过检查替换单词是否仍然具有相同的POS 标记以及句子级别相似度高于阈值来进一步过滤。鉴于上下文感知预测是屏蔽语言模型的一个非常自然的用例,BERT-Attack 通过BERT 将单词替换为语义相似的单词。通过这种方式发现的对抗性示例在模型之间具有一定的可转移性,具体取决于模型和任务。
基于梯度的攻击#
在白盒设置中,我们可以完全访问模型参数和架构。因此,我们可以依靠梯度下降以编程方式学习最有效的攻击。基于梯度的攻击仅在白盒设置中有效,例如开源法学硕士。GBDA(“基于梯度的分布式攻击”;Guo et al. 2021)使用Gumbel-Softmax 近似技巧使对抗性损失优化可微,其中使用BERTScore 和困惑度来增强可感知性和流畅性。给定一个标记$\mathbf{x}=[x_1, x_2 \dots x_n]$ 的输入,其中一个标记$x_i$ 可以从分类分布$P_\Theta$ 中采样,其中$\Theta \in \mathbb{R}^{n \times V}$ 和$V$ 是标记词汇量大小。考虑到$V$ 通常约为$O(10,000)$ 并且大多数对抗性示例只需要一些令牌替换,它是高度过度参数化的。我们有:
$$
x_i \sim P_{\Theta_i}=\text{分类}(\pi_i)=\text{分类}(\text{Softmax}(\Theta_i))
$$
其中$\pi_i \in \mathbb{R}^V$ 是第$i$ 个标记的标记概率向量。要最小化的对抗性目标函数是为分类器$f$: $\min_{\Theta \in \mathbb{R}^{n \times V}} \mathbb{E}_{\mathbf{x} \sim P_{\Theta}} \mathcal{L}_\text{adv}(\mathbf{X}, y; 生成与正确标签$y$ 不同的错误标签f)$。然而,从表面上看,由于分类分布,这是不可微分的。使用Gumbel-softmax 近似(Jang et al. 2016),我们通过$\tilde{\boldsymbol{\pi}}$: 近似Gumbel 分布$\tilde{P}_\Theta$ 的分类分布
$$
\tilde{\pi}_i^{(j)}=\frac{\exp(\frac{\Theta_{ij} + g_{ij}}{\tau})}{\sum_{v=1}^V \exp(\frac{\Theta_{iv} + g_{iv}}{\tau})}
$$
其中$g_{ij} \sim \text{Gumbel}(0, 1)$;温度$\tau 0$ 控制分布的平滑度。
Gumbel 分布用于对多个样本的极值(最大值或最小值)进行建模,而与样本分布无关。额外的Gumbel 噪声带来了模拟分类分布采样过程的随机决策。


