


8
月
在社区成长 8 月
LEVEL 50
100 XP
以LLM(大语言模型)作为核心控制器构建代理是一个很酷的概念。 AutoGPT、GPT-Engineer 和BabyAGI 等几个概念验证演示都是鼓舞人心的示例。法学硕士的潜力不仅仅在于生成写得好的副本、故事、论文和程序;它可以被视为一个强大的通用问题解决器。
规划子目标和分解: 代理将大型任务分解为更小的、可管理的子目标,从而能够高效处理复杂任务。
反思和细化: 智能体可以对过去的行为进行自我批评和自我反思,从错误中吸取教训,并针对未来的步骤进行完善,从而提高最终结果的质量。
记忆短期记忆: 我认为所有的上下文学习(参见提示工程)都是利用模型的短期记忆来学习。
长期记忆: 这为代理提供了长时间保留和回忆(无限)信息的能力,通常是通过利用外部向量存储和快速检索。
工具使用代理学习调用外部API 来获取模型权重中缺失的额外信息(通常在预训练后很难更改),包括当前信息、代码执行能力、对专有信息源的访问等。
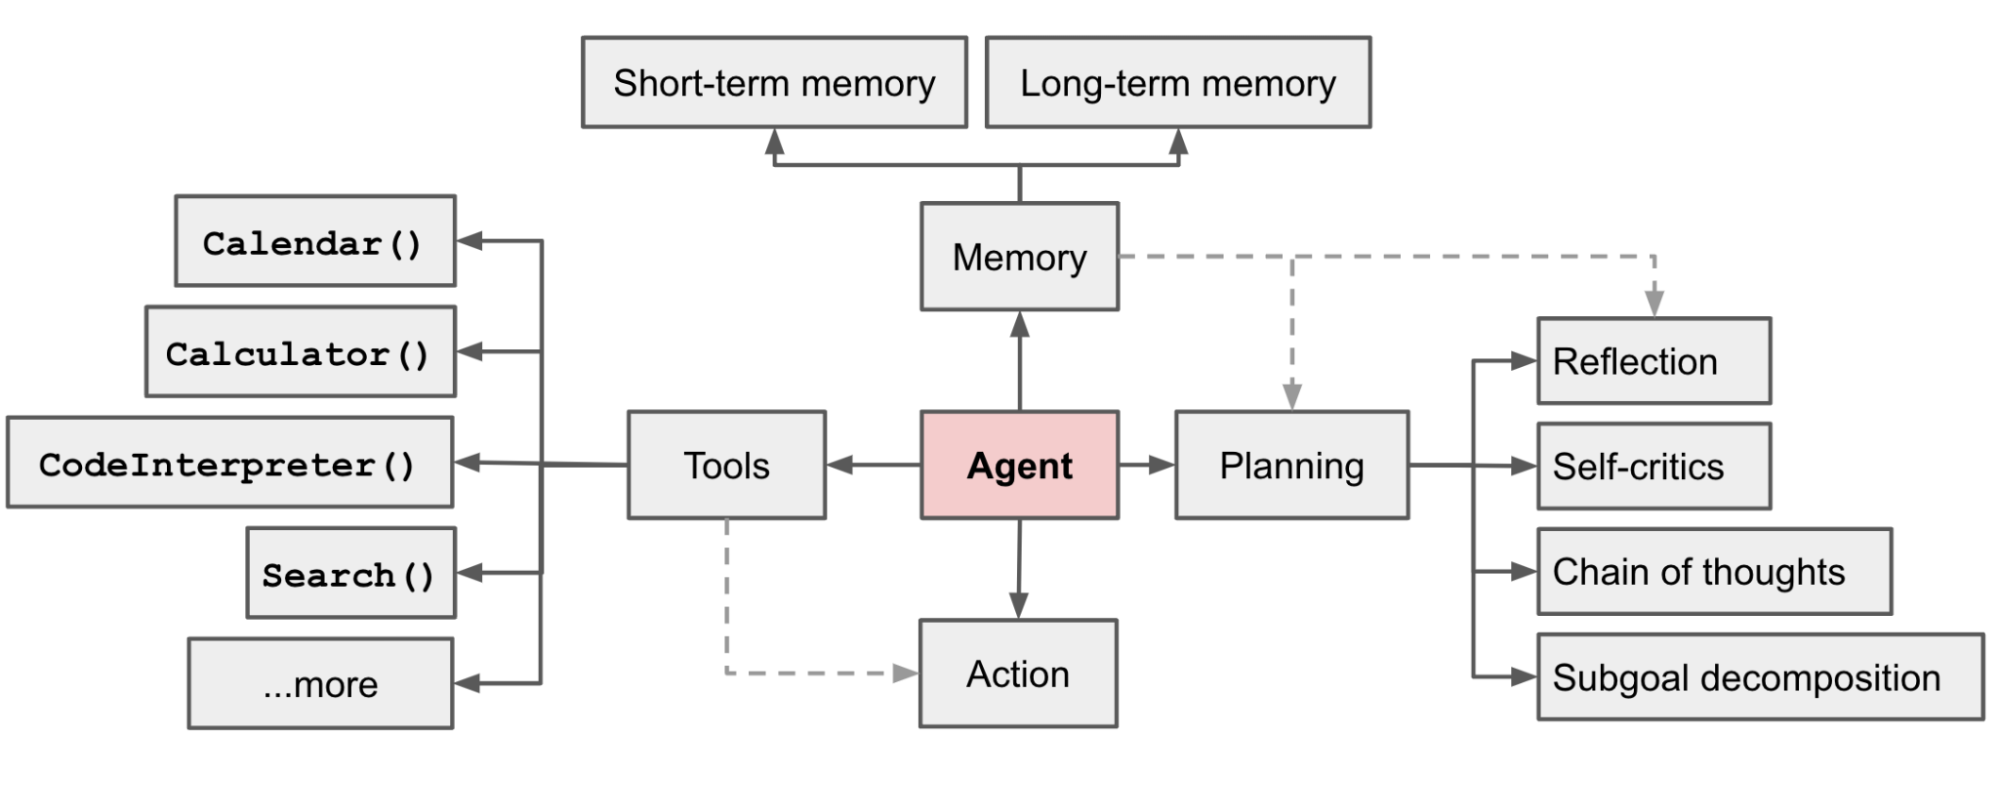 LLM 支持的自主代理系统概述。
Tree of Thoughts(Yao et al. 2023)通过在每一步探索多种推理可能性来扩展CoT。它首先将问题分解为多个思考步骤,并在每个步骤中生成多个思考,从而创建树结构。搜索过程可以是BFS(广度优先搜索)或DFS(深度优先搜索),每个状态由分类器(通过提示)或多数投票进行评估。
任务分解可以通过LLM 进行,并通过简单的提示来完成,例如“XYZ 的步骤。\n1.”、“实现XYZ 的子目标是什么?”、(2) 通过使用特定于任务的指令;例如“写一个故事大纲。”用于写小说,或(3) 人工输入。
另一种截然不同的方法是LLM+P(Liu et al. 2023),涉及依赖外部经典规划器来进行长期规划。该方法利用规划领域定义语言(PDDL)作为描述规划问题的中间接口。在此过程中,LLM(1)将问题翻译成“Problem PDDL”,然后(2)请求经典规划器基于现有的“Domain PDDL”生成PDDL计划,最后(3)将PDDL计划翻译回自然语言。本质上,规划步骤被外包给外部工具,假设特定领域的PDDL 和合适的规划器可用,这在某些机器人设置中很常见,但在许多其他领域并不常见。
ReAct(Yao et al. 2023)通过将动作空间扩展为特定于任务的离散动作和语言空间的组合,将推理和动作集成在法学硕士中。前者使LLM能够与环境交互(例如使用维基百科搜索API),而后者则促使LLM以自然语言生成推理痕迹。
ReAct提示模板包含了供LLM思考的明确步骤,大致格式为:
想法:…
行动:
观察:…
.(重复多次)
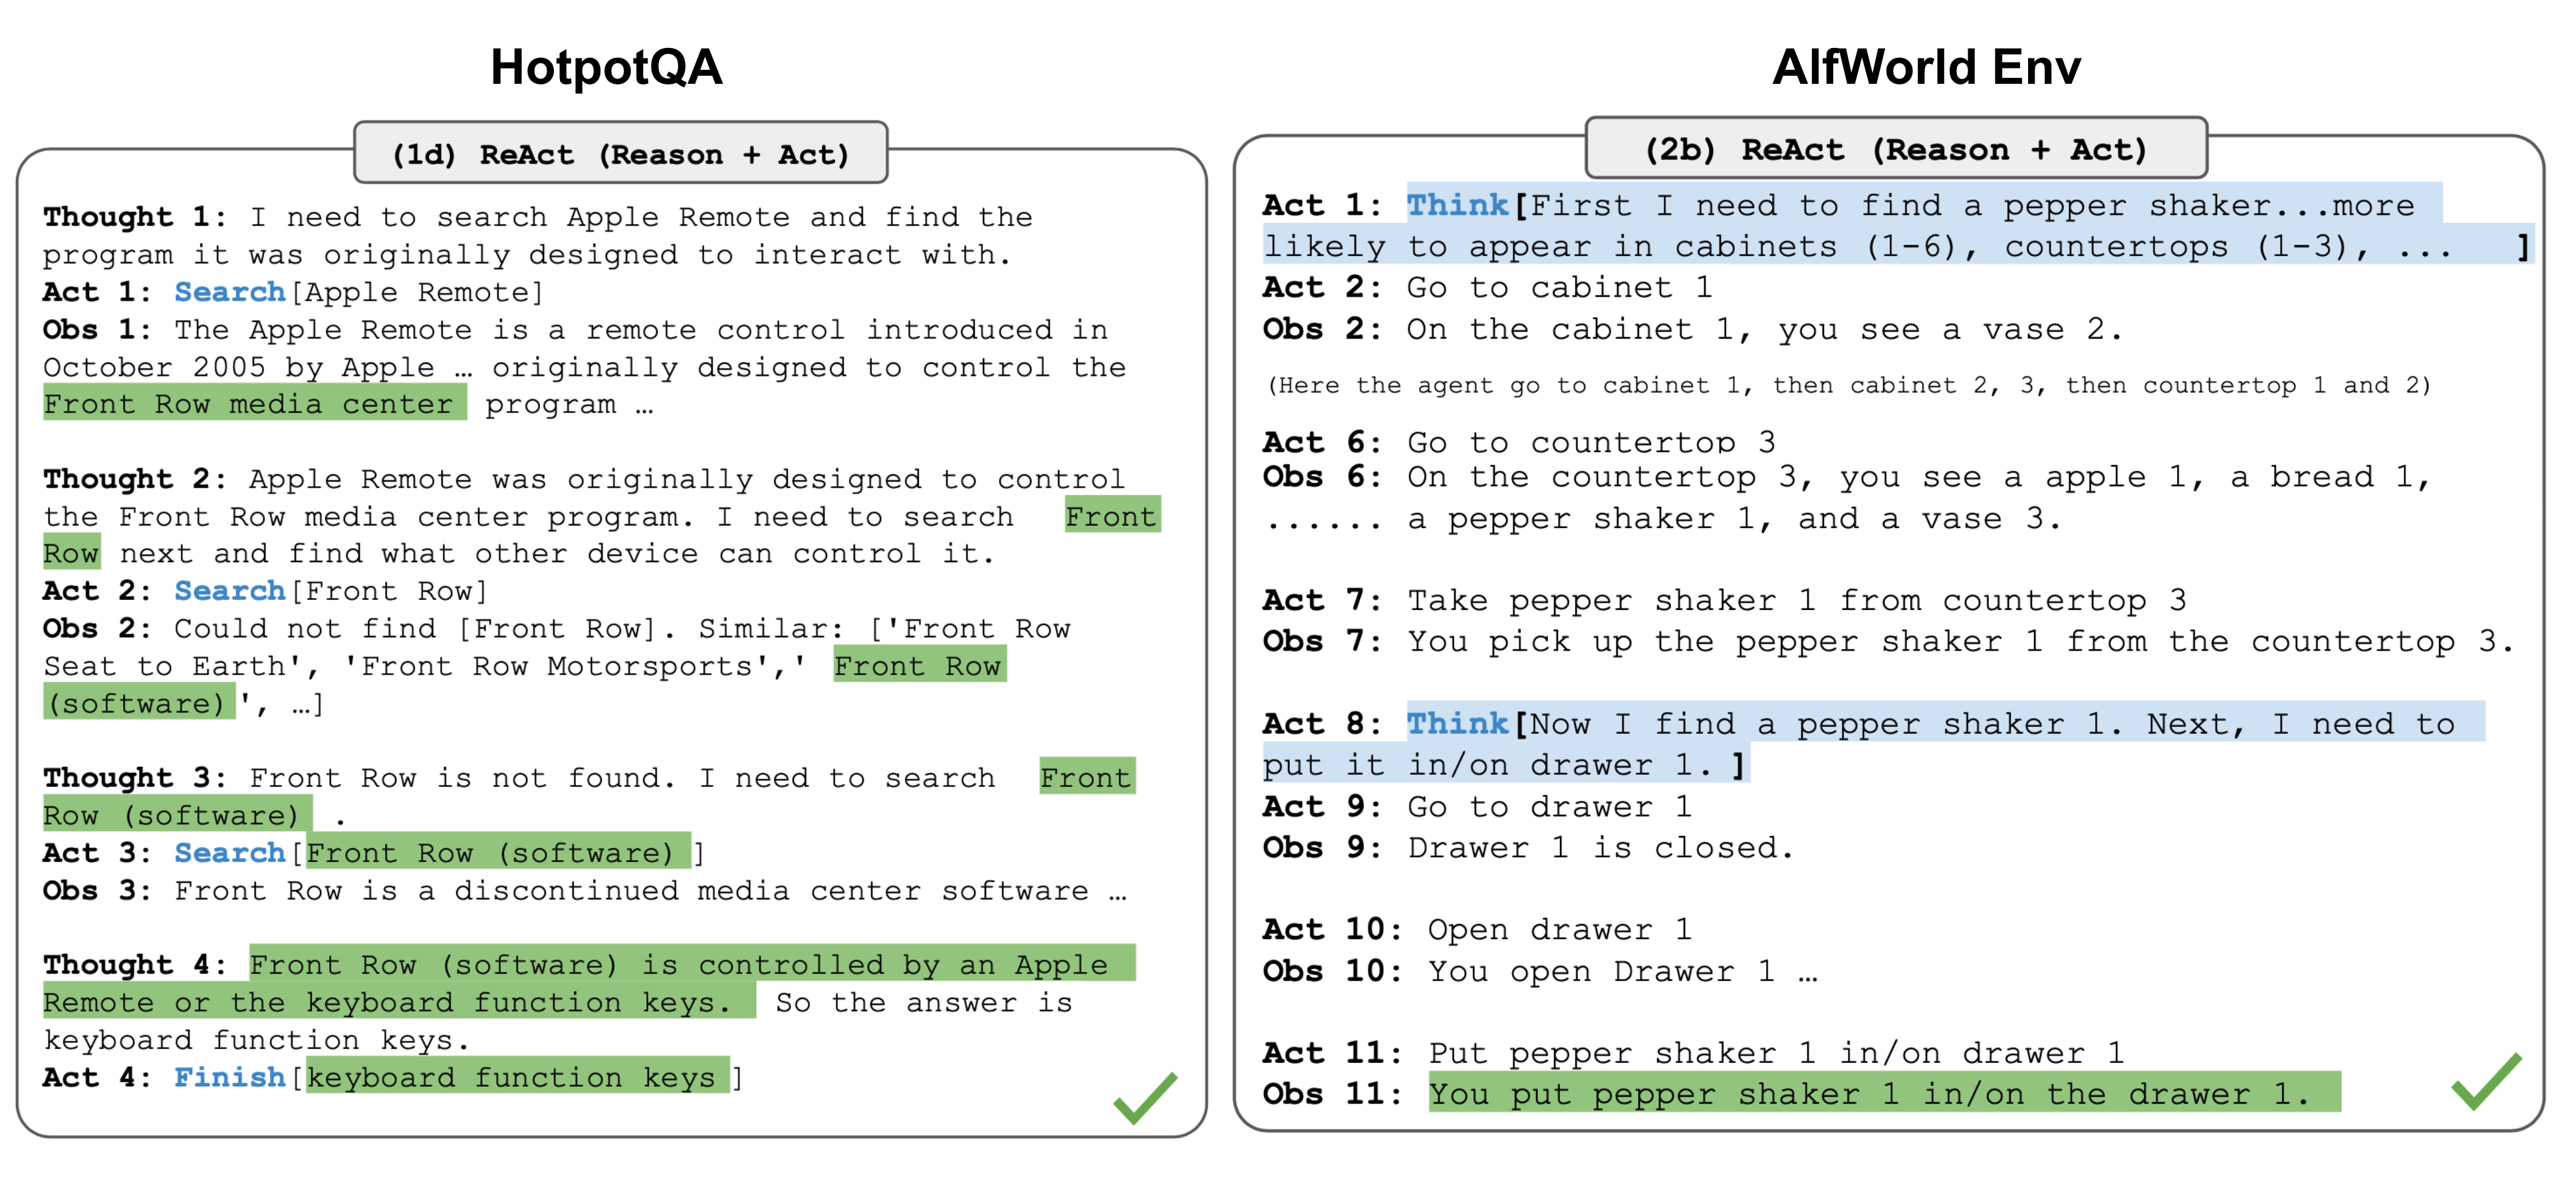 知识密集型任务(例如HotpotQA、FEVER)和决策任务(例如AlfWorld Env、WebShop)的推理轨迹示例。 (图片来源: Yao et al. 2023)。在知识密集型任务和决策任务的实验中,ReAct 比删除Thought: … 步骤的仅Act 基线效果更好。
Reflexion (Shinn Labash 2023) 是一个为智能体配备动态记忆和自我反思能力以提高推理技能的框架。 Reflexion 有一个标准的RL 设置,其中奖励模型提供简单的二元奖励,动作空间遵循ReAct 中的设置,其中特定于任务的动作空间通过语言进行增强,以实现复杂的推理步骤。在每个操作$a_t$ 之后,代理会计算启发式$h_t$,并且可以选择根据自我反思结果决定重置环境以开始新的试验。
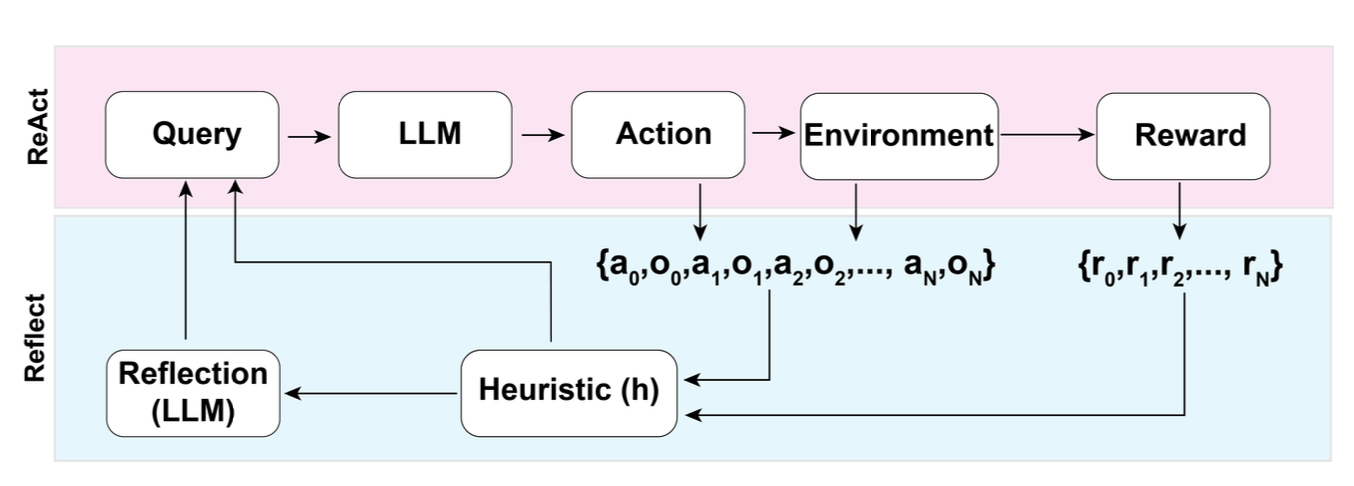 反射框架的插图。 (图片来源: Shinn Labash,2023)启发式函数确定轨迹何时效率低下或包含幻觉并应停止。低效的规划是指花费太长时间而没有成功的轨迹。幻觉被定义为遇到一系列相同的连续动作,这些动作导致在环境中进行相同的观察。
自我反思是通过向法学硕士展示两个例子来创建的,每个例子都是一对(失败的轨迹,指导计划未来变化的理想反思)。然后,反射被添加到代理的工作内存中,最多三个,用作查询LLM 的上下文。
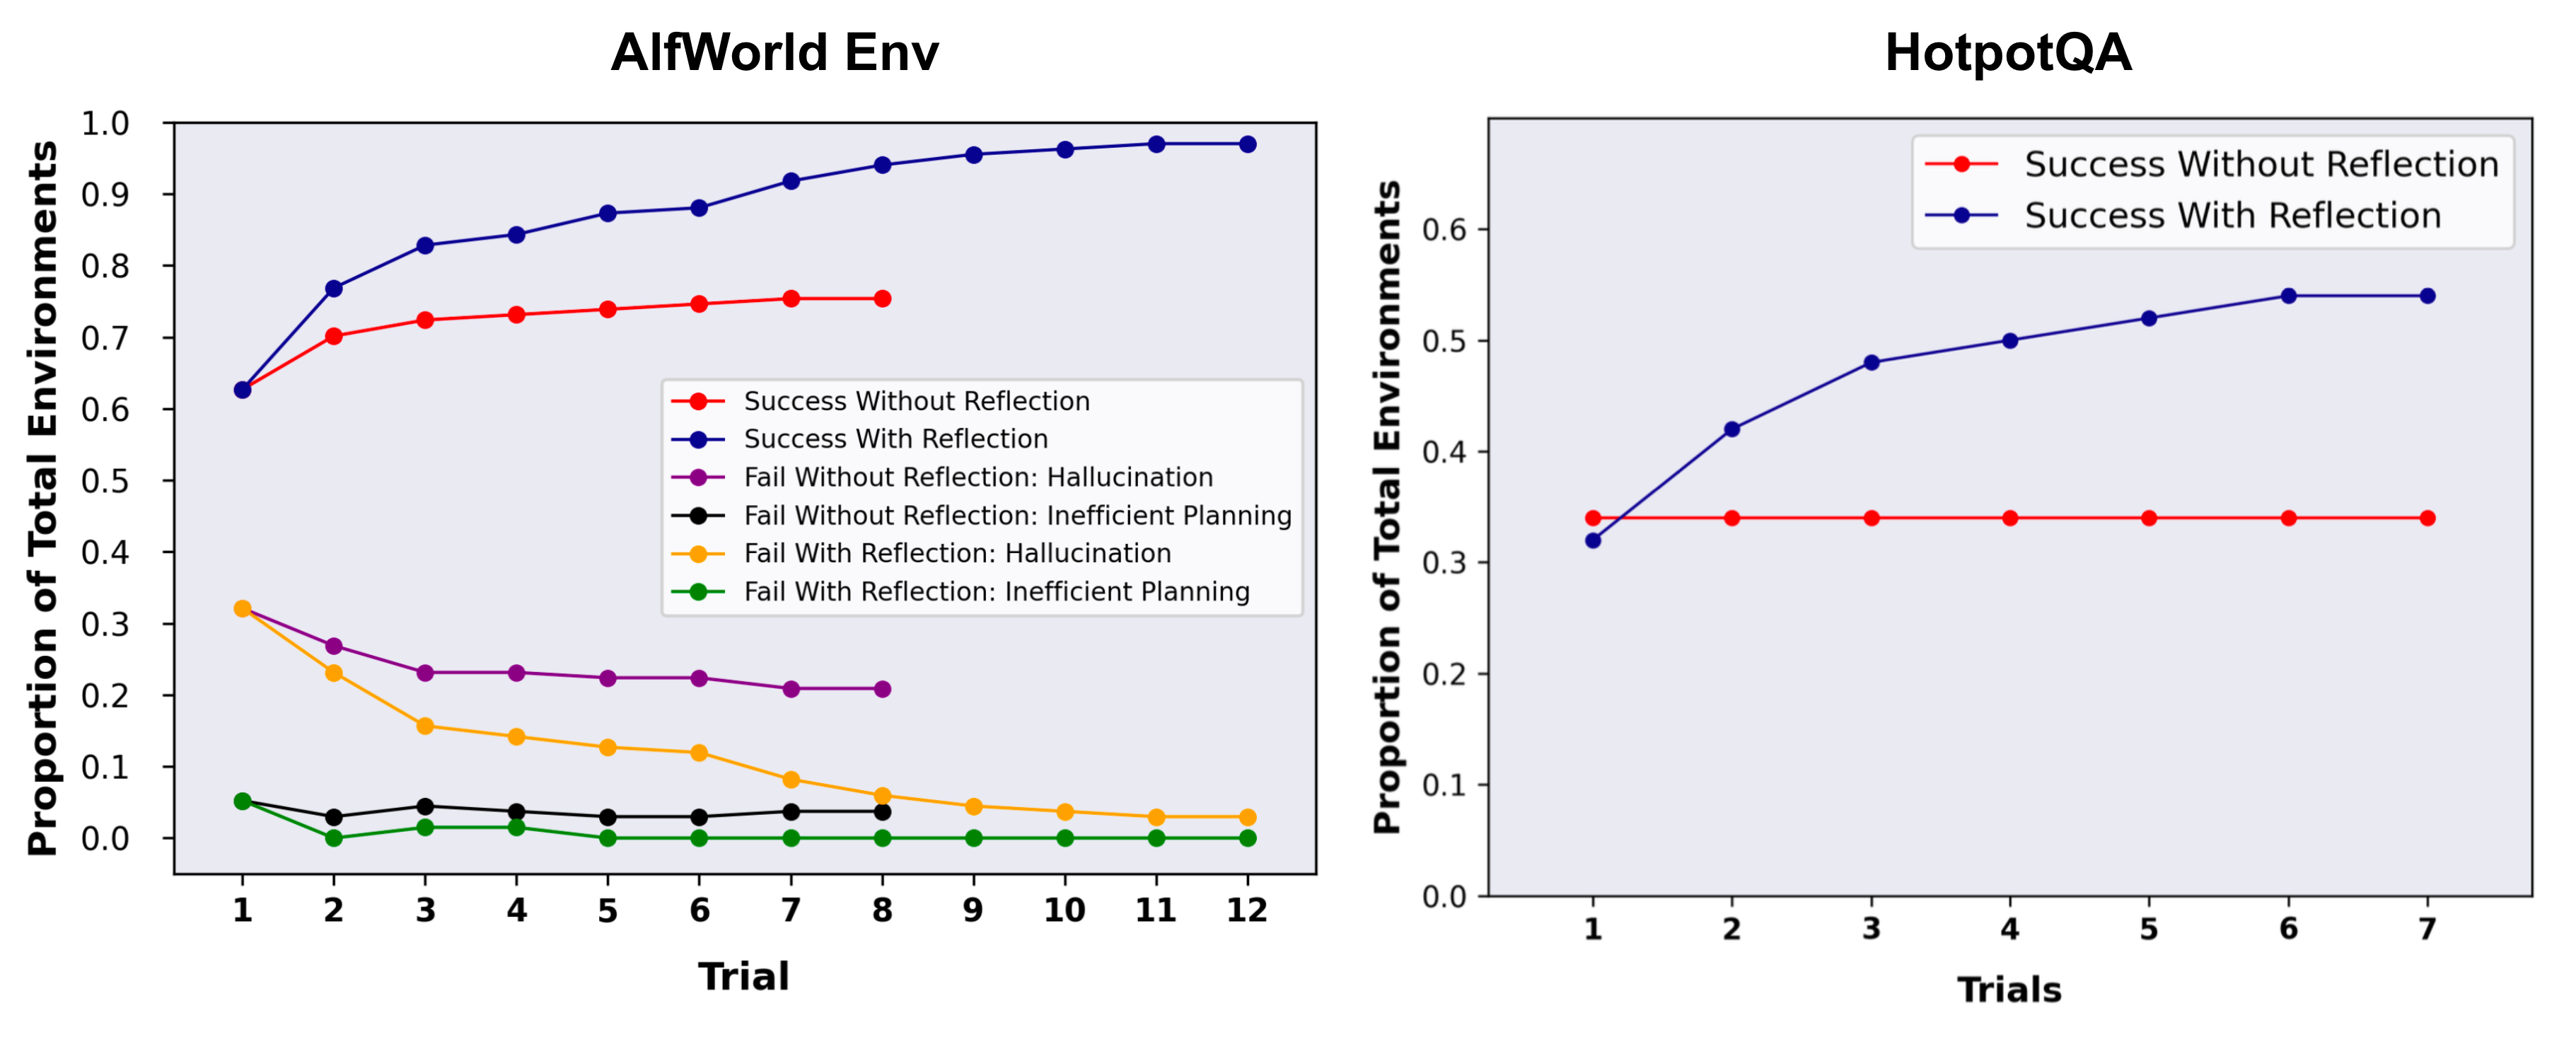 AlfWorld Env 和HotpotQA 实验。在阿尔夫世界中,幻觉是比低效规划更常见的失败。 (图片来源: Shinn Labash,2023)后见之明(CoH;Liu 等人,2023)鼓励模型通过明确地呈现一系列过去的输出来改进其自身的输出,每个输出都带有反馈注释。人类反馈数据是$D_h=\{(x, y_i , r_i , z_i)\}_{i=1}^n$的集合,其中$x$是提示,每个$y_i$是模型完成,$r_i$是$y_i$的人类评分,$z_i$是相应的人类提供的事后反馈。假设反馈元组按奖励排序, $r_n \geq r_{n-1} \geq \dots \geq r_1$ 该过程是监督微调,其中数据是$\tau_h=(x, z_i, y_i, z_j, y_j, \dots, z_n, y_n)$ 形式的序列,其中$\leq i \leq j \leq n$。该模型经过微调,仅预测以序列前缀为条件的$y_n$,以便模型可以根据反馈序列进行自我反思以产生更好的输出。该模型可以选择在测试时接收人类注释者的多轮指令。
为了避免过度拟合,CoH 添加了正则化项来最大化预训练数据集的对数似然。为了避免捷径和复制(因为反馈序列中有很多常见单词),他们在训练过程中随机屏蔽了0% - 5% 的过去标记。
他们实验中的训练数据集是WebGPT 比较、人类反馈总结和人类偏好数据集的组合。
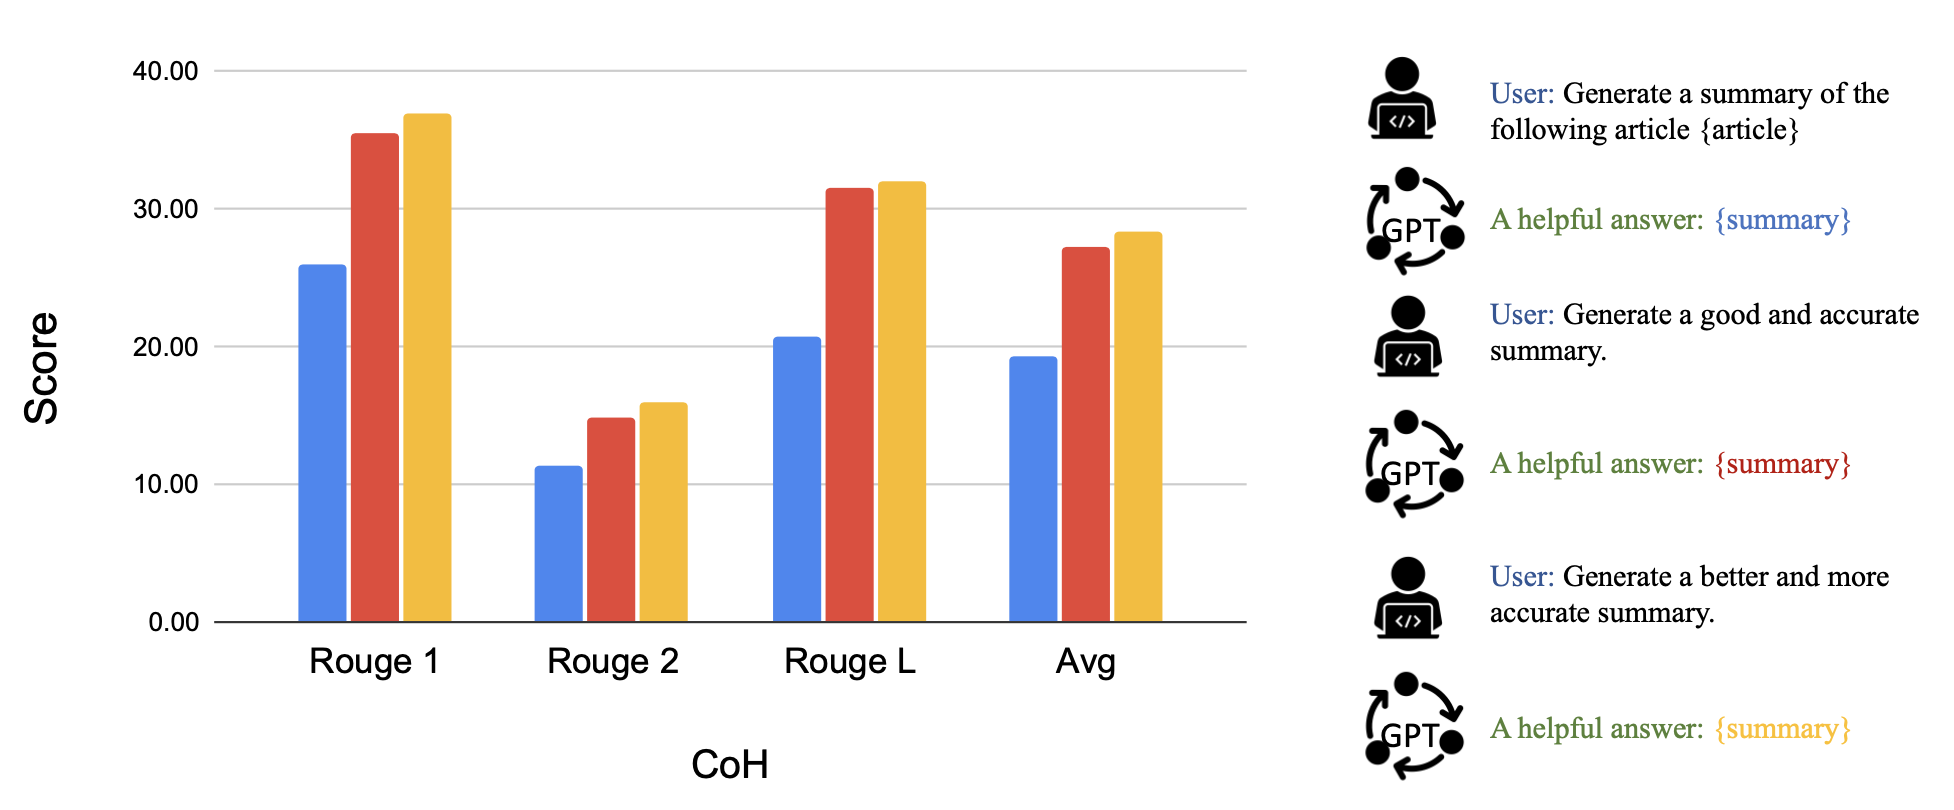 使用CoH 进行微调后,模型可以按照指令生成具有序列增量改进的输出。 (图片来源: Liu et al. 2023)CoH 的想法是呈现上下文中连续改进输出的历史,并训练模型以适应产生更好输出的趋势。算法蒸馏(AD;Laskin 等人,2023)将相同的想法应用于强化学习任务中的跨情节轨迹,其中算法被封装在长期历史条件策略中。考虑到智能体与环境进行多次交互,并且在每一集中智能体都会变得更好一些,AD 会将此学习历史连接起来并将其输入到模型中。因此,我们应该期望下一个预测的行动会带来比之前的试验更好的性能。目标是学习强化学习的过程,而不是训练特定于任务的策略本身。
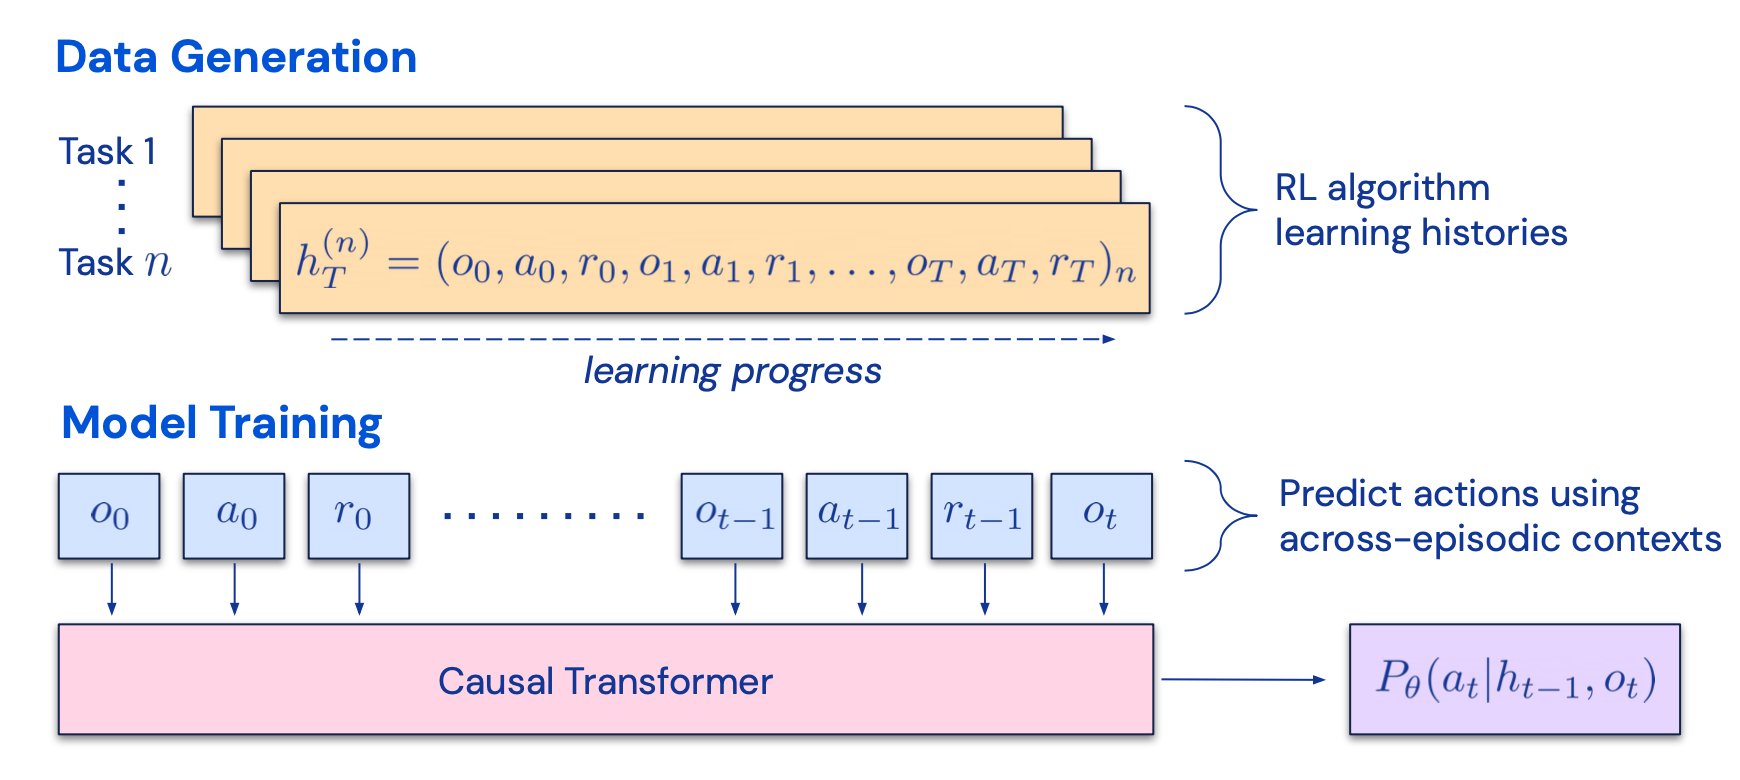 算法蒸馏(AD) 工作原理的图示。
(图片来源: Laskin et al. 2023)。本文假设任何生成一组学习历史的算法都可以通过对动作执行行为克隆来提炼成神经网络。历史数据由一组源策略生成,每个源策略针对特定任务进行训练。在训练阶段,在每次RL 运行期间,都会对随机任务进行采样,并使用多集历史的子序列进行训练,从而使学习到的策略与任务无关。
实际上,该模型的上下文窗口长度有限,因此剧集应该足够短以构建多剧集历史。要学习近乎最优的上下文强化学习算法,需要2-4 个片段的多片段上下文。上下文强化学习的出现需要足够长的上下文。
与三个基线相比,包括ED(专家蒸馏,用专家轨迹而不是学习历史进行行为克隆)、源策略(用于生成UCB 蒸馏的轨迹)、RL^2(Duan et al. 2017;用作上限,因为它需要在线RL),AD 展示了上下文中的RL,尽管仅使用离线RL 和学习,但性能仍接近RL^2
代理系统概述#
在LLM 支持的自主代理系统中,LLM 充当代理的大脑,并由几个关键组件进行补充:规划子目标和分解: 代理将大型任务分解为更小的、可管理的子目标,从而能够高效处理复杂任务。
反思和细化: 智能体可以对过去的行为进行自我批评和自我反思,从错误中吸取教训,并针对未来的步骤进行完善,从而提高最终结果的质量。
记忆短期记忆: 我认为所有的上下文学习(参见提示工程)都是利用模型的短期记忆来学习。
长期记忆: 这为代理提供了长时间保留和回忆(无限)信息的能力,通常是通过利用外部向量存储和快速检索。
工具使用代理学习调用外部API 来获取模型权重中缺失的额外信息(通常在预训练后很难更改),包括当前信息、代码执行能力、对专有信息源的访问等。
第一部分:规划#
复杂的任务通常涉及许多步骤。代理商需要了解它们是什么并提前计划。任务分解#
思想链(CoT;Wei et al. 2022)已成为增强复杂任务模型性能的标准提示技术。该模型被指示“一步一步思考”,以利用更多的测试时间计算将困难任务分解为更小、更简单的步骤。 CoT 将大型任务转化为多个可管理的任务,并阐明模型思维过程的解释。Tree of Thoughts(Yao et al. 2023)通过在每一步探索多种推理可能性来扩展CoT。它首先将问题分解为多个思考步骤,并在每个步骤中生成多个思考,从而创建树结构。搜索过程可以是BFS(广度优先搜索)或DFS(深度优先搜索),每个状态由分类器(通过提示)或多数投票进行评估。
任务分解可以通过LLM 进行,并通过简单的提示来完成,例如“XYZ 的步骤。\n1.”、“实现XYZ 的子目标是什么?”、(2) 通过使用特定于任务的指令;例如“写一个故事大纲。”用于写小说,或(3) 人工输入。
另一种截然不同的方法是LLM+P(Liu et al. 2023),涉及依赖外部经典规划器来进行长期规划。该方法利用规划领域定义语言(PDDL)作为描述规划问题的中间接口。在此过程中,LLM(1)将问题翻译成“Problem PDDL”,然后(2)请求经典规划器基于现有的“Domain PDDL”生成PDDL计划,最后(3)将PDDL计划翻译回自然语言。本质上,规划步骤被外包给外部工具,假设特定领域的PDDL 和合适的规划器可用,这在某些机器人设置中很常见,但在许多其他领域并不常见。
自我反思#
自我反思是一个重要的方面,它允许自主代理通过完善过去的行动决策和纠正以前的错误来迭代改进。它在不可避免地会出现试错的现实任务中发挥着至关重要的作用。ReAct(Yao et al. 2023)通过将动作空间扩展为特定于任务的离散动作和语言空间的组合,将推理和动作集成在法学硕士中。前者使LLM能够与环境交互(例如使用维基百科搜索API),而后者则促使LLM以自然语言生成推理痕迹。
ReAct提示模板包含了供LLM思考的明确步骤,大致格式为:
想法:…
行动:
观察:…
.(重复多次)
Reflexion (Shinn Labash 2023) 是一个为智能体配备动态记忆和自我反思能力以提高推理技能的框架。 Reflexion 有一个标准的RL 设置,其中奖励模型提供简单的二元奖励,动作空间遵循ReAct 中的设置,其中特定于任务的动作空间通过语言进行增强,以实现复杂的推理步骤。在每个操作$a_t$ 之后,代理会计算启发式$h_t$,并且可以选择根据自我反思结果决定重置环境以开始新的试验。
自我反思是通过向法学硕士展示两个例子来创建的,每个例子都是一对(失败的轨迹,指导计划未来变化的理想反思)。然后,反射被添加到代理的工作内存中,最多三个,用作查询LLM 的上下文。
为了避免过度拟合,CoH 添加了正则化项来最大化预训练数据集的对数似然。为了避免捷径和复制(因为反馈序列中有很多常见单词),他们在训练过程中随机屏蔽了0% - 5% 的过去标记。
他们实验中的训练数据集是WebGPT 比较、人类反馈总结和人类偏好数据集的组合。
(图片来源: Laskin et al. 2023)。本文假设任何生成一组学习历史的算法都可以通过对动作执行行为克隆来提炼成神经网络。历史数据由一组源策略生成,每个源策略针对特定任务进行训练。在训练阶段,在每次RL 运行期间,都会对随机任务进行采样,并使用多集历史的子序列进行训练,从而使学习到的策略与任务无关。
实际上,该模型的上下文窗口长度有限,因此剧集应该足够短以构建多剧集历史。要学习近乎最优的上下文强化学习算法,需要2-4 个片段的多片段上下文。上下文强化学习的出现需要足够长的上下文。
与三个基线相比,包括ED(专家蒸馏,用专家轨迹而不是学习历史进行行为克隆)、源策略(用于生成UCB 蒸馏的轨迹)、RL^2(Duan et al. 2017;用作上限,因为它需要在线RL),AD 展示了上下文中的RL,尽管仅使用离线RL 和学习,但性能仍接近RL^2


