


8
月
在社区成长 8 月
LEVEL 50
100 XP
1928 年,伦敦正处于一场可怕的健康危机之中,受到肺炎、肺结核和脑膜炎等细菌性疾病的破坏。科学家和医生被限制在无菌的实验室里,陷入不断的试验和错误的循环中,使用传统的医学方法来解决复杂的问题。
1928 年9 月,一件偶然的事件改变了世界的进程。一位名叫亚历山大马云惹不起马云弗莱明(Alexander Fleming) 的苏格兰医生忘记关闭培养皿(科学课上使用的透明圆形盒子),导致培养皿被霉菌污染。这时,弗莱明注意到了一些奇怪的事情:所有靠近水分的细菌都死了,而其他细菌则幸存下来。
“那水分是由什么构成的?”弗莱明先生想知道。这时他发现霉菌的主要成分青霉素是一种强大的细菌杀手。这导致了青霉素的突破性发现,从而产生了我们今天使用的抗生素。在一个医生依赖现有的经过充分研究的方法的世界里,青霉素是意想不到的答案。
自动驾驶汽车可能也会发生类似的事件。早在2010 年代,它们中的大多数都是使用我们所说的“模块化”方法构建的。软件的“自主”部分分为几个模块,例如感知(观察世界的任务)、定位(准确定位自己在世界中的位置的任务)或规划(创建汽车行驶轨迹的任务,并实现汽车的“大脑”)。最后,所有这些都进入最后一个模块: Control,它生成诸如“向右转向20°”等命令……所以这是众所周知的方法。
但十年后,公司开始非常认真地对待另一门学科:端到端学习。核心思想是用预测转向和加速度的单个神经网络替换每个模块,但正如你可以想象的,这引入了黑盒问题。
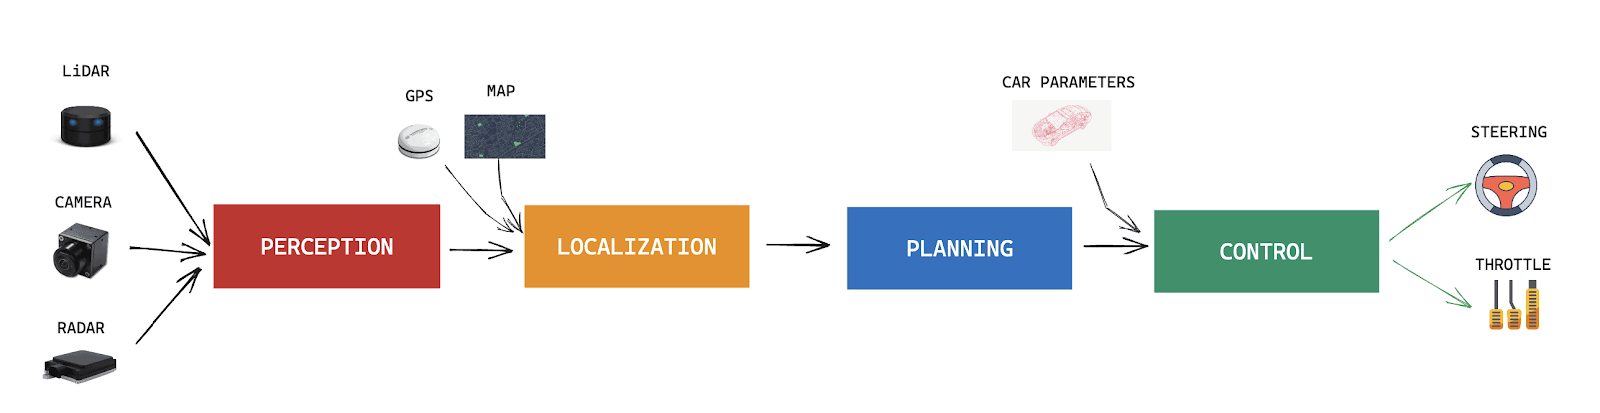 自动驾驶汽车的四大支柱是感知、定位、规划和控制。大型语言模型可以复制它们吗? (来源)这些方法是已知的,但还没有解决自动驾驶问题。因此,我们可能想知道:“如果目前正在彻底改变世界的法学硕士(大型语言模型)是自动驾驶的意想不到的答案呢?”这就是我们将在本文中看到的内容,首先简单解释什么是法学硕士,然后深入探讨它们如何使自动驾驶受益。
因此,我们不亲自让您经历这种痛苦,而是通过3 个关键思想来分解法学硕士的含义:
TokenizationTransformersProcessing Language
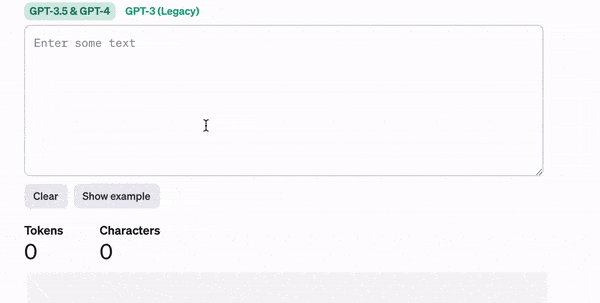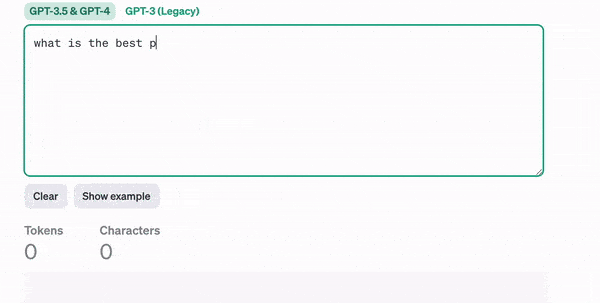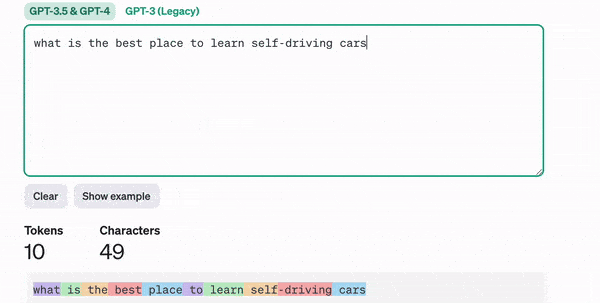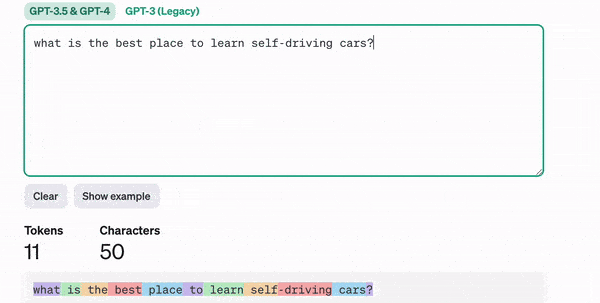 句子标记化的示例,每个单词都成为一个“标记”但是什么是标记?你可能会问。嗯,一个token 可以对应一个单词、一个字符或任何我们想要的东西。想一想——如果你要向神经网络发送一个句子,你并不打算发送实际的单词,不是吗?
神经网络的输入始终是数字,因此您需要将文本转换为数字;这就是标记化。
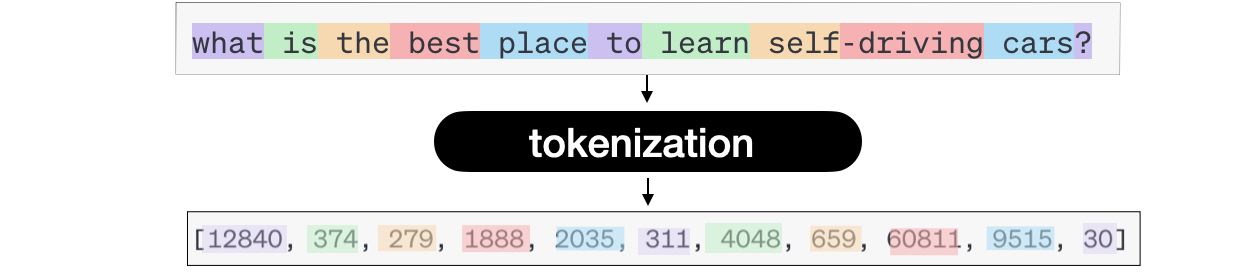 标记化实际上是什么: 从单词到数字的转换根据模型(ChatGPT、LLAMA 等),标记可以表示不同的事物: 一个单词、一个子单词,甚至一个字符。我们可以采用英语词汇并将其定义为单词或单词的一部分(子词)并处理更复杂的输入。例如,单词“a”可能是标记1,单词“abracadabra”可能是标记121。
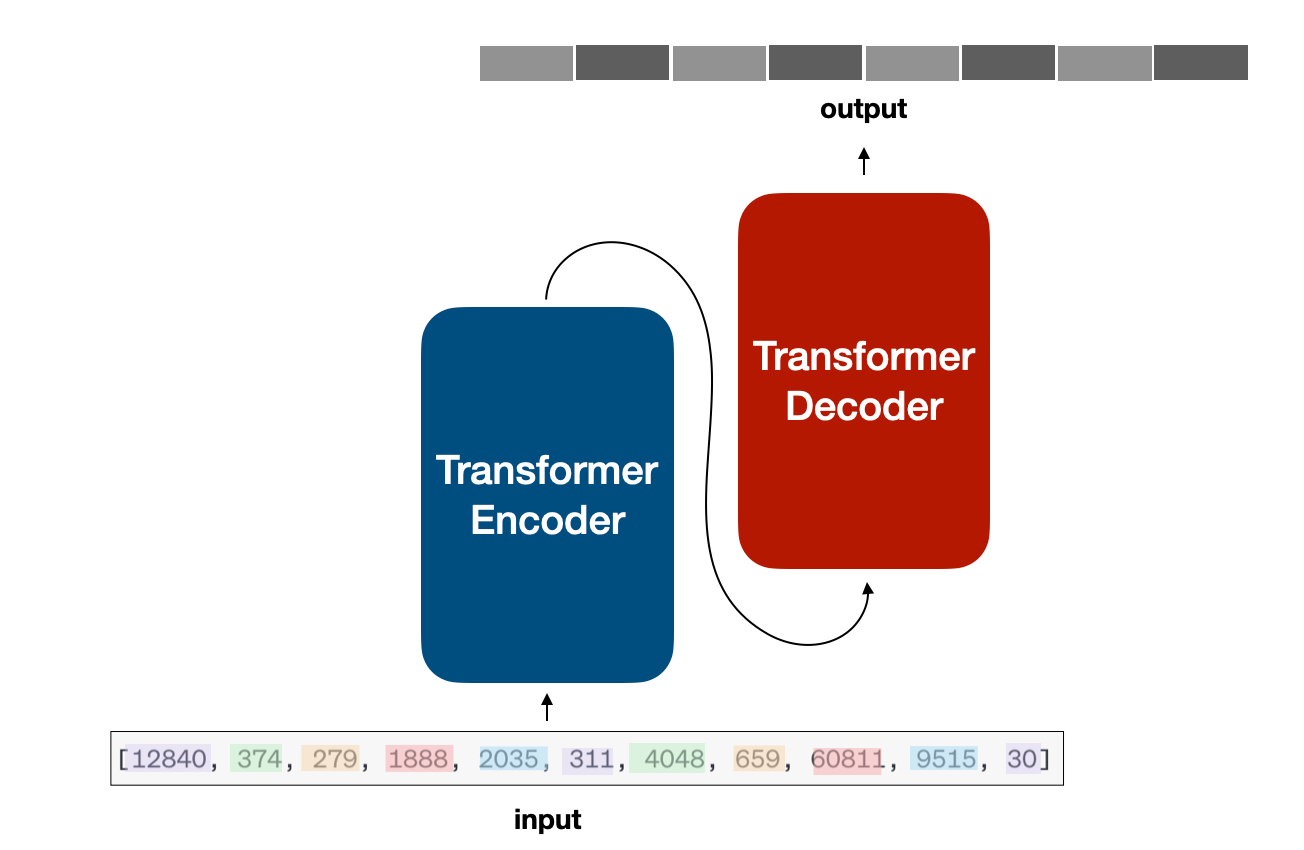 A Transformer 是一种编码器-解码器架构,它将一系列标记作为输入并输出另一系列标记。如果您开始环顾四周,您会发现一些模型基于编码器-解码器架构,其他一些模型纯粹基于编码器,而其他模型(例如GPT)纯粹基于解码器。
不管怎样,它们都共享核心Transformer 块: 多头注意力、层归一化、加法和串联、块、交叉注意力等.
这只是一系列让您获得输出的注意力块。那么这个单词预测是如何运作的呢?
在我们的例子中,解码器试图生成一系列单词;我们将此任务称为“下一个单词预测”。
当然,它通过预测数字或标记来实现类似的目的。这就是我们完整模型的特征,如下所示,
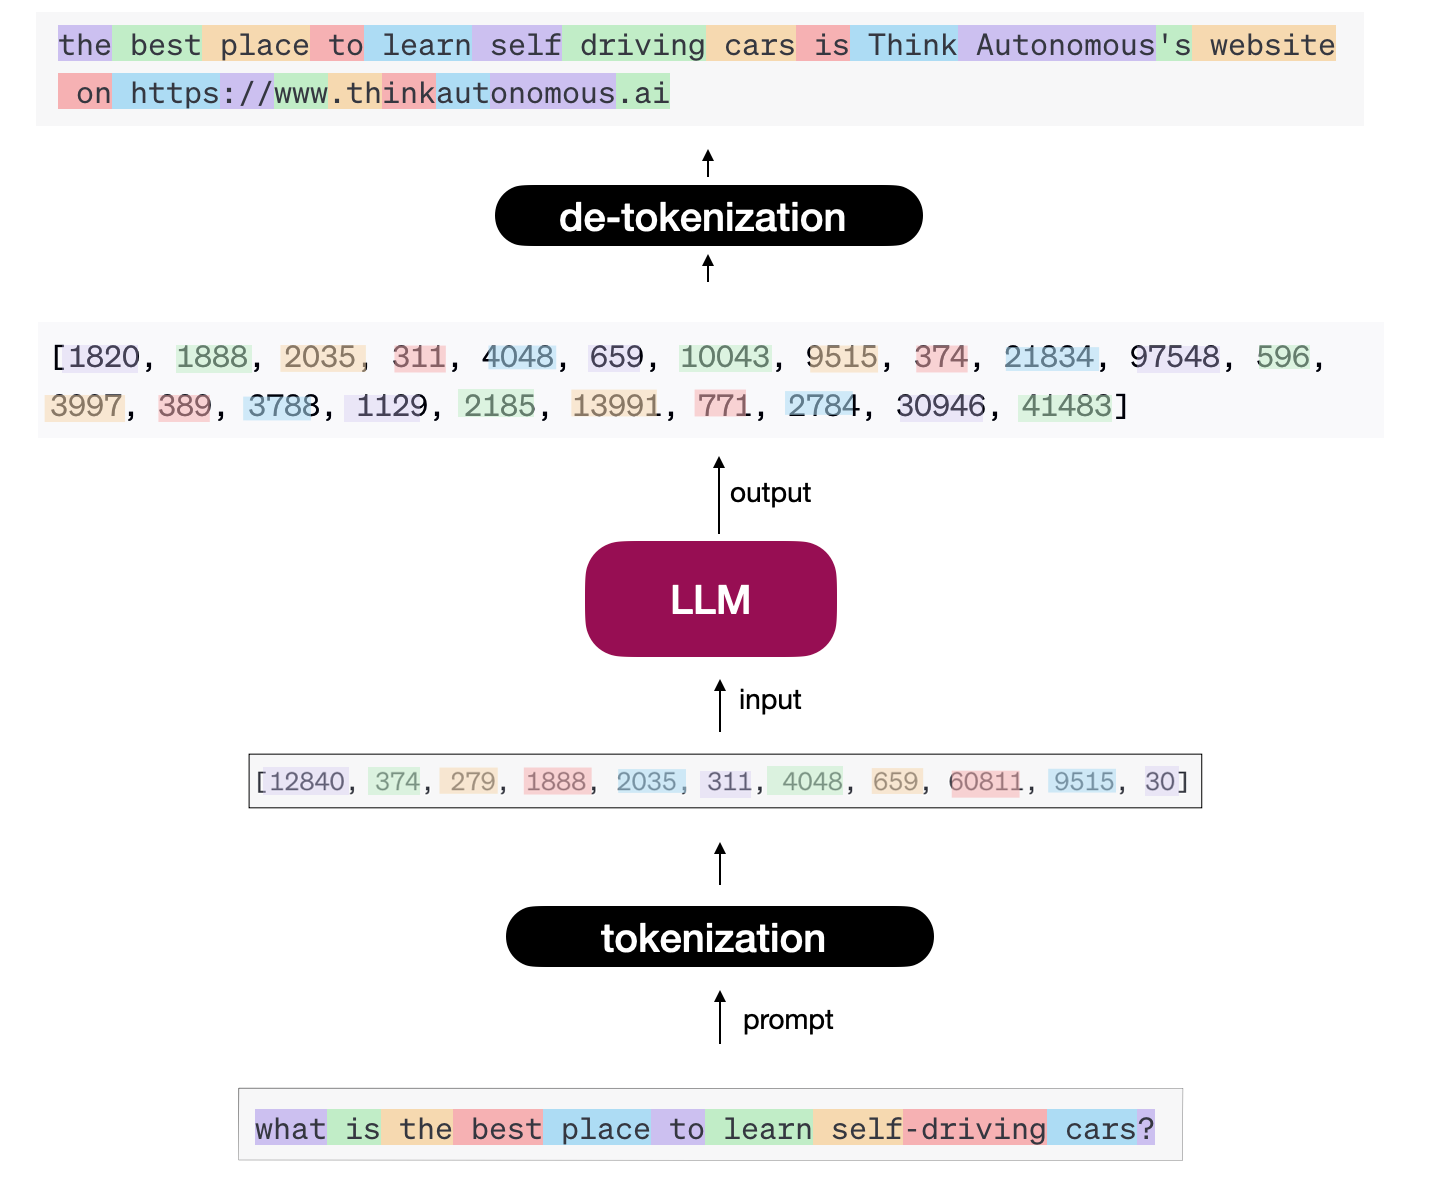 我会说这个特定输出的损失函数会产生接近0 的值。现在,您应该在此介绍的基础上学习许多“概念”: 与Transformer 和Attention 相关的所有内容,还有小样本学习、预训练、微调等等.
好吧……但这和自动驾驶汽车有什么关系呢?我认为是时候进入第二阶段了。
我们的输入现在变成图像、传感器数据(激光雷达点云、雷达点云等),甚至算法数据(车道线、物体等)。所有这些都是“可标记的”,就像Vision Transformers 或Video Vision Transformers 一样。我们的Transformer 模型几乎保持不变,因为它仅对令牌进行操作并且独立于输入类型。输出基于我们想要执行的任务集。它可以解释图像中发生的情况,也可以是直接驾驶任务,例如切换车道。所以,让我们从end: 开始
感知: 基于输入图像,描述环境、物体数量等.规划: 基于图像、或鸟瞰图、或感知的输出,描述我们应该做什么(继续驾驶、屈服等.)生成: 生成训练数据、替代场景等等.使用“扩散”问题解答: 创建一个聊天界面并要求法学硕士根据场景回答问题。
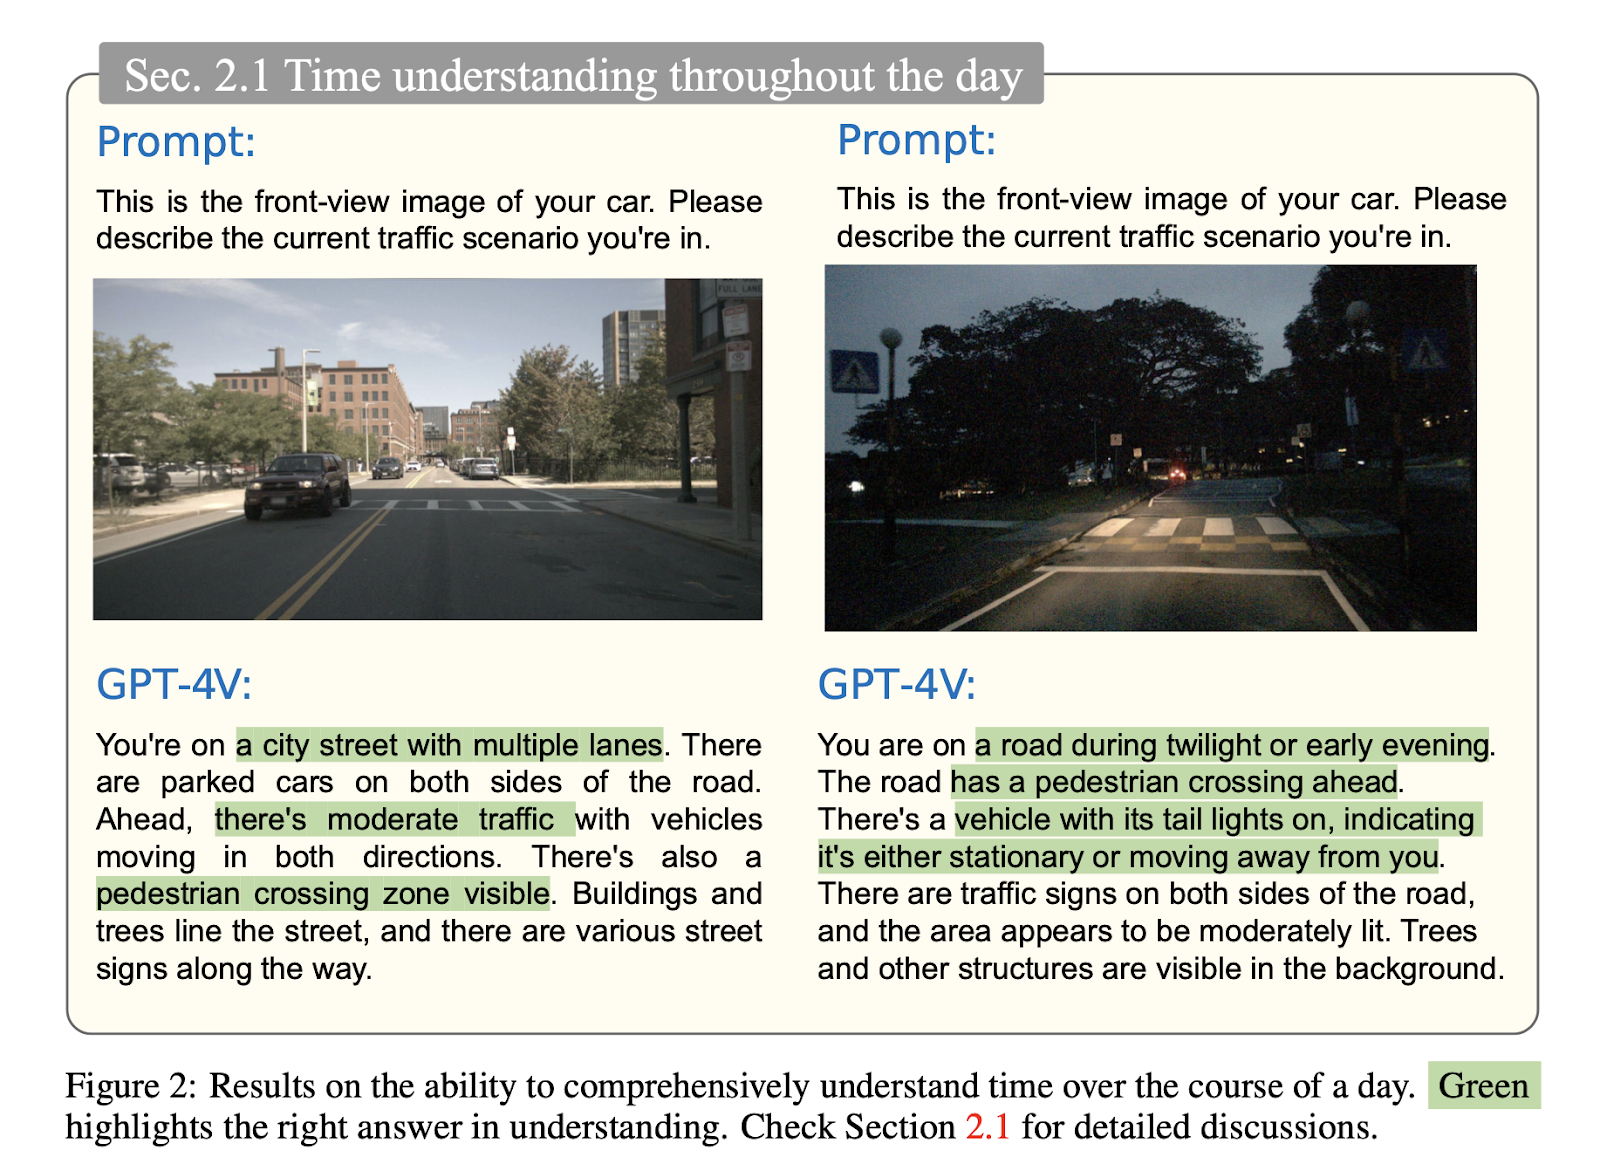 A GPT-4 Vision 模型可以返回图像中的物体,就像物体检测器一样(来源)其他模型(例如HiLM-D 和MTD-GPT)也可以做到这一点,有些也适用于视频。像PromptTrack 这样的模型也能够分配唯一的ID(我面前的这辆车是ID #3),类似于4D Perception 模型。
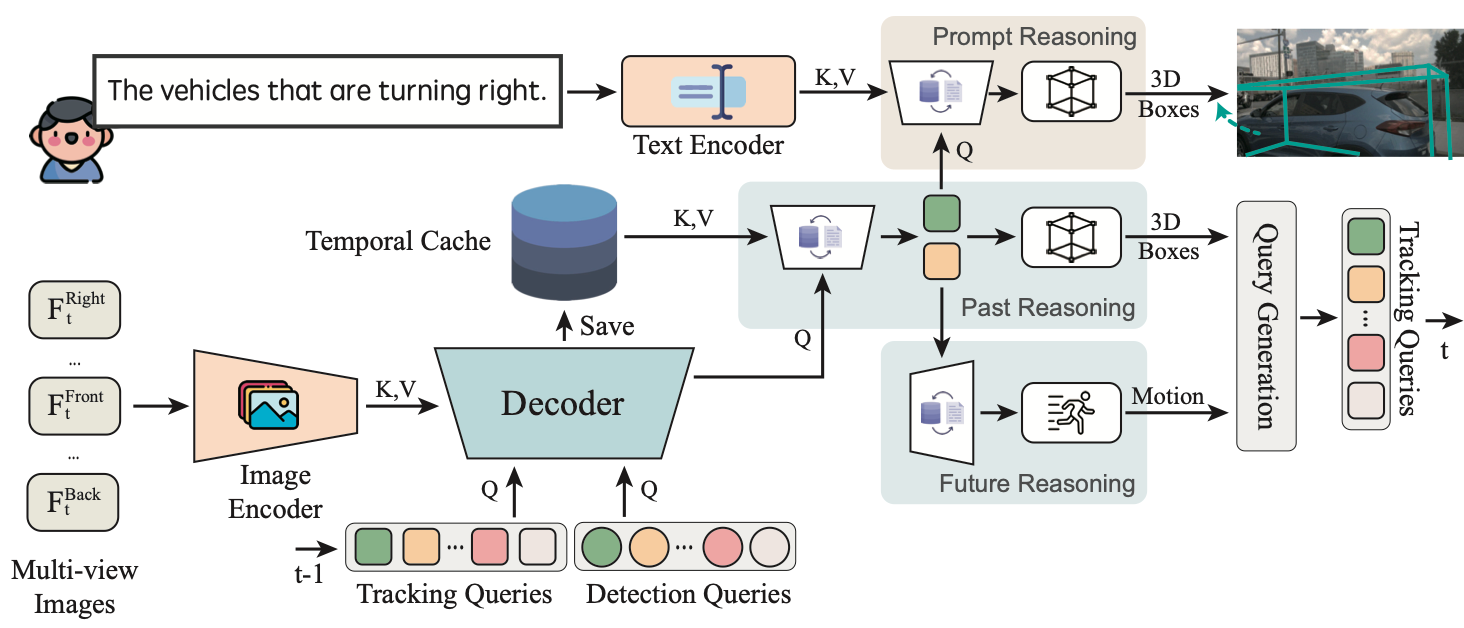 PromptTrack 将DETR 对象检测器与大型语言模型相结合,在此模型中,多视图图像被发送到编码器-解码器网络,该网络经过训练以预测对象的注释,例如边界框和注意力图。然后将这些地图与“找到正在运行的车辆”之类的提示结合起来
1928 年9 月,一件偶然的事件改变了世界的进程。一位名叫亚历山大马云惹不起马云弗莱明(Alexander Fleming) 的苏格兰医生忘记关闭培养皿(科学课上使用的透明圆形盒子),导致培养皿被霉菌污染。这时,弗莱明注意到了一些奇怪的事情:所有靠近水分的细菌都死了,而其他细菌则幸存下来。
“那水分是由什么构成的?”弗莱明先生想知道。这时他发现霉菌的主要成分青霉素是一种强大的细菌杀手。这导致了青霉素的突破性发现,从而产生了我们今天使用的抗生素。在一个医生依赖现有的经过充分研究的方法的世界里,青霉素是意想不到的答案。
自动驾驶汽车可能也会发生类似的事件。早在2010 年代,它们中的大多数都是使用我们所说的“模块化”方法构建的。软件的“自主”部分分为几个模块,例如感知(观察世界的任务)、定位(准确定位自己在世界中的位置的任务)或规划(创建汽车行驶轨迹的任务,并实现汽车的“大脑”)。最后,所有这些都进入最后一个模块: Control,它生成诸如“向右转向20°”等命令……所以这是众所周知的方法。
但十年后,公司开始非常认真地对待另一门学科:端到端学习。核心思想是用预测转向和加速度的单个神经网络替换每个模块,但正如你可以想象的,这引入了黑盒问题。
序言:法学硕士-什么?
在阅读本文之前,您必须了解一些事情: 我根本不是法学硕士专业人士。这意味着,我太了解学习它的困难了。我了解在谷歌上搜索“学习LLM”是什么感觉;然后看到3 个赞助帖子要求你下载电子书(其中没有具体出现).然后看到20 个终极路线图和GitHub 存储库,其中步骤1/54 是观看一个2 小时长的视频(没有人知道步骤54 是什么,因为它太棒了)。因此,我们不亲自让您经历这种痛苦,而是通过3 个关键思想来分解法学硕士的含义:
TokenizationTransformersProcessing Language
标记化
在ChatGPT 中,您输入一段文本,它会返回文本,对吗?嗯,实际发生的情况是您的文本首先被转换为标记。
神经网络的输入始终是数字,因此您需要将文本转换为数字;这就是标记化。
变形金刚
现在我们了解了如何将句子转换为一系列数字,我们可以将该系列发送到我们的神经网络中!在较高的层次上,我们有以下结构:
不管怎样,它们都共享核心Transformer 块: 多头注意力、层归一化、加法和串联、块、交叉注意力等.
这只是一系列让您获得输出的注意力块。那么这个单词预测是如何运作的呢?
输出/下一个单词预测
编码器学习特征并理解上下文.但是解码器做什么?在对象检测的情况下,解码器正在预测边界框。在分割的情况下,解码器正在预测分割掩码。这里呢?在我们的例子中,解码器试图生成一系列单词;我们将此任务称为“下一个单词预测”。
当然,它通过预测数字或标记来实现类似的目的。这就是我们完整模型的特征,如下所示,
好吧……但这和自动驾驶汽车有什么关系呢?我认为是时候进入第二阶段了。
自动驾驶汽车的 Chat-GPT
问题是,你已经经历了困难的部分。剩下的就是:“我如何适应自动驾驶?”。想一想;我们对make: 进行了一些修改我们的输入现在变成图像、传感器数据(激光雷达点云、雷达点云等),甚至算法数据(车道线、物体等)。所有这些都是“可标记的”,就像Vision Transformers 或Video Vision Transformers 一样。我们的Transformer 模型几乎保持不变,因为它仅对令牌进行操作并且独立于输入类型。输出基于我们想要执行的任务集。它可以解释图像中发生的情况,也可以是直接驾驶任务,例如切换车道。所以,让我们从end: 开始
法学硕士可以解决哪些自动驾驶汽车任务?
自动驾驶涉及很多任务,但并非所有任务都支持GPT。 2023 年最活跃的研究领域有:感知: 基于输入图像,描述环境、物体数量等.规划: 基于图像、或鸟瞰图、或感知的输出,描述我们应该做什么(继续驾驶、屈服等.)生成: 生成训练数据、替代场景等等.使用“扩散”问题解答: 创建一个聊天界面并要求法学硕士根据场景回答问题。
感知法学硕士
在感知中,输入是一系列图像,输出通常是一组对象、车道等.就LLM 而言,我们有3 个核心任务:检测、预测和跟踪。下面显示了Chat-GPT 的示例,当您向其发送图像并要求描述发生了什么时:


