


8
月
在社区成长 8 月
LEVEL 90
100 XP
自从大约三年前我上一篇关于“Transformer Family”的文章以来,已经提出了许多新的Transformer 架构改进。在这里,我对2020 年的帖子进行了重大重构和丰富——重新构建了章节的层次结构,并用最新的论文改进了许多章节。 2.0版本是旧版本的超集,长度大约是旧版本的两倍。
含义
$d$
模型大小/隐藏状态维度/位置编码大小。
$h$
多头注意力层中头的数量。
$L$
输入序列的段长度。
$N$
模型中注意力层的总数;不考虑教育部。
$\mathbf{X} \in \mathbb{R}^{L \times d}$
输入序列,其中每个元素已映射到形状为$d$ 的嵌入向量,与模型大小相同。
$\mathbf{W}^k \in \mathbb{R}^{d \times d_k}$
关键权重矩阵。
$\mathbf{W}^q \in \mathbb{R}^{d \times d_k}$
查询权重矩阵。
$\mathbf{W}^v \in \mathbb{R}^{d \times d_v}$
值权重矩阵。通常我们有$d_k=d_v=d$。
$\mathbf{W}^k_i, \mathbf{W}^q_i \in \mathbb{R}^{d \times d_k/h}; \mathbf{W}^v_i \in \mathbb{R}^{d \times d_v/h}$
每头的体重矩阵。
$\mathbf{W}^o \in \mathbb{R}^{d_v \times d}$
输出权重矩阵。
$\mathbf{Q}=\mathbf{X}\mathbf{W}^q \in \mathbb{R}^{L \times d_k}$
查询嵌入输入。
$\mathbf{K}=\mathbf{X}\mathbf{W}^k \in \mathbb{R}^{L \times d_k}$
关键嵌入输入。
$\mathbf{V}=\mathbf{X}\mathbf{W}^v \in \mathbb{R}^{L \times d_v}$
值嵌入输入。
$\mathbf{q}_i, \mathbf{k}_i \in \mathbb{R}^{d_k}, \mathbf{v}_i \in \mathbb{R}^{d_v}$
查询、键、值矩阵、$\mathbf{Q}$、$\mathbf{K}$ 和$\mathbf{V}$ 中的行向量。
$S_i$
第$i$ 个查询$\mathbf{q}_i$ 要关注的关键位置集合。
$\mathbf{A} \in \mathbb{R}^{L \乘L}$
长度为$L$ 的输入序列与其自身之间的自注意力矩阵。 $\mathbf{A}=\text{softmax}(\mathbf{Q}\mathbf{K}^\top/\sqrt{d_k})$。
$a_{ij} \in \mathbf{A}$
查询$\mathbf{q}_i$ 和键$\mathbf{k}_j$ 之间的标量注意力得分。
$\mathbf{P} \in \mathbb{R}^{L \times d}$
位置编码矩阵,其中第$i$ 行$\mathbf{p}_i$ 是输入$\mathbf{x}_i$ 的位置编码。
自注意力是一种注意力机制,模型使用同一样本的观察的其他部分来预测数据样本的一部分。从概念上讲,它感觉与非本地手段非常相似。还要注意,自注意力是排列不变的;换句话说,它是集合上的运算。
注意力/自注意力有多种形式,Transformer (Vaswani et al. 2017) 依赖于缩放点积注意力:给定查询矩阵$\mathbf{Q}$、键矩阵$\mathbf{K}$ 和值矩阵$\mathbf{V}$,输出是值向量的加权和,其中分配给每个值槽的权重由以下点积决定:对应key:的查询
$$
\text{attn}(\mathbf{Q}, \mathbf{K}, \mathbf{V})=\text{softmax}(\frac{\mathbf{Q} {\mathbf{K}}^\top}{\sqrt{d_k}})\mathbf{V}
$$
对于查询和键向量$\mathbf{q}_i, \mathbf{k}_j \in \mathbb{R}^d$ (查询和键矩阵中的行向量),我们有一个标量分数:
$$
a_{ij}=\text{softmax}(\frac{\mathbf{q}_i {\mathbf{k}_j}^\top}{\sqrt{d_k}})
=\frac{\exp(\frac{\mathbf{q}_i {\mathbf{k}_j}^\top}{\sqrt{d_k}})}{ \sum_{r \in \mathcal{S}_i} \exp(\frac{\mathbf{q}_i {\mathbf{k}_r}^\top}{\sqrt{d_k}}) }
$$
其中$\mathcal{S}_i$ 是第$i$ 个查询要处理的关键位置的集合。
如果有兴趣,请参阅我的旧帖子以了解其他类型的关注。
$$
\开始{对齐}
\text{MultiHeadAttn}(\mathbf{X}_q, \mathbf{X}_k, \mathbf{X}_v)=[\text{head}_1; \点; \text{head}_h] \mathbf{W}^o \\
\text{其中头}_i=\text{注意力}(\mathbf{X}_q\mathbf{W}^q_i, \mathbf{X}_k\mathbf{W}^k_i, \mathbf{X}_v\mathbf{W}^v_i)
\结束{对齐}
$$
其中$[.]$ 是串联操作。 $\mathbf{W}^q_i、\mathbf{W}^k_i \in \mathbb{R}^{d \times d_k/h}、\mathbf{W}^v_i \in \mathbb{R}^{d \times d_v/h}$ 是将大小为$L \times d$ 的输入嵌入映射到查询、键和值矩阵的权重矩阵。 $\mathbf{W}^o \in \mathbb{R}^{d_v \times d}$ 是输出线性变换。所有的重量都应该在训练过程中学习。
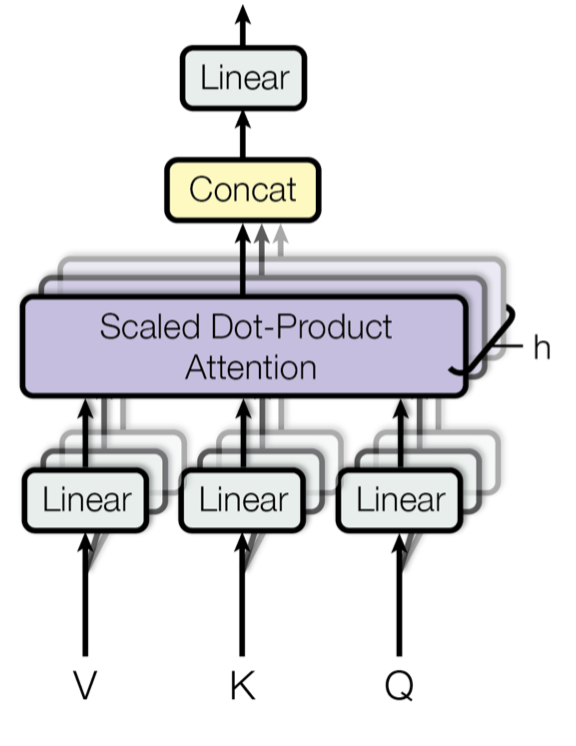 多头缩放点积注意力机制的图示。 (图像来源: Vaswani 等人,2017 年的图2)
Transformer 解码器的功能是从编码表示中检索信息。该架构与编码器非常相似,只是解码器包含两个多头注意力子模块,而不是每个相同的重复模块中都有一个。第一个多头注意力子模块被屏蔽,以防止位置关注未来。
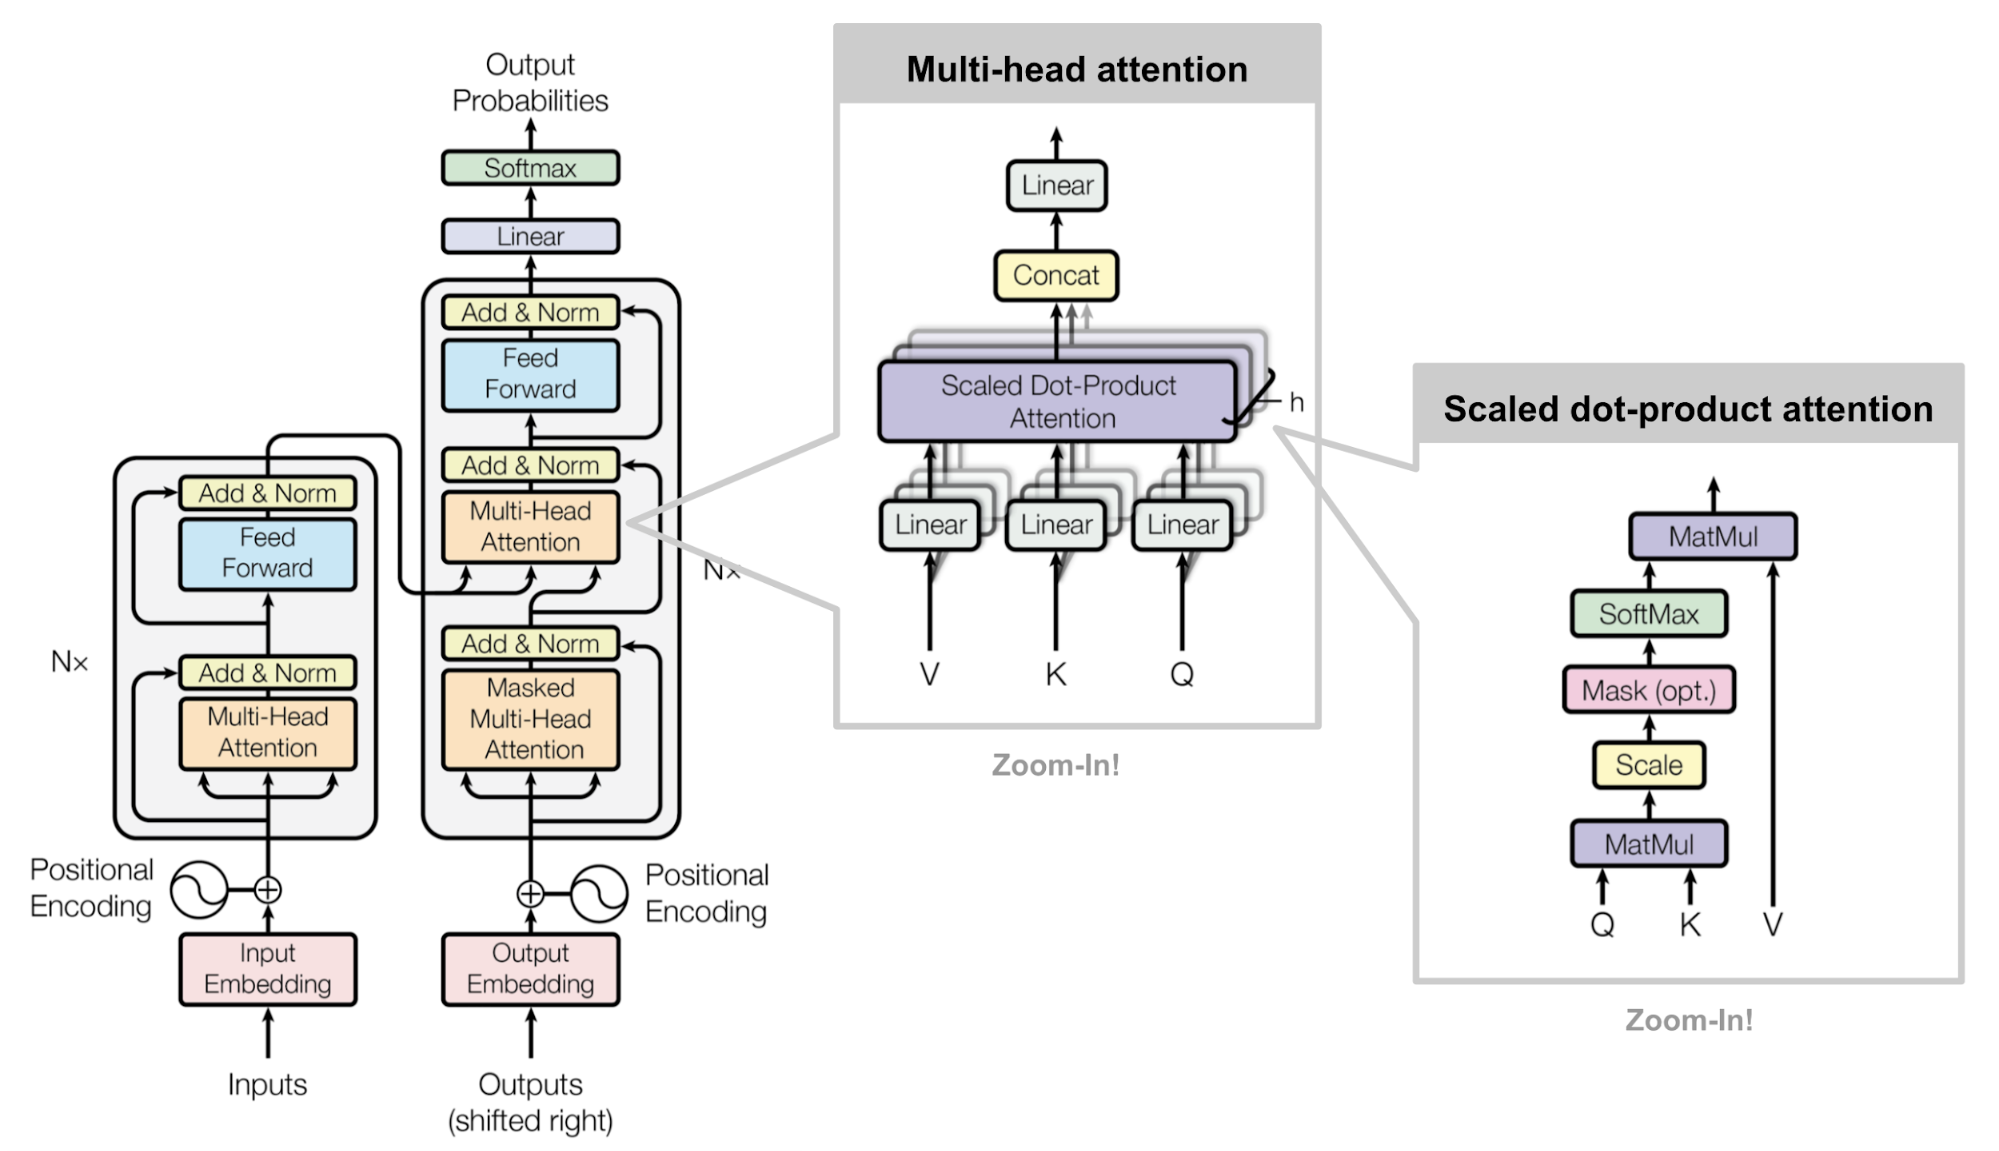 原版Transformer 模型的架构。 (图片来源: 图17)
$$
\text{PE}(i,\delta)=
\开始{案例}
\sin(\frac{i}{10000^{2\delta'/d}}) \text{if } \delta=2\delta'\\
\cos(\frac{i}{10000^{2\delta'/d}}) \text{if } \delta=2\delta' + 1\\
\结束{案例}
$$
这样,位置编码的每个维度对应于不同维度的不同波长的正弦曲线,从$2\pi$ 到$10000 \cdot 2\pi$。
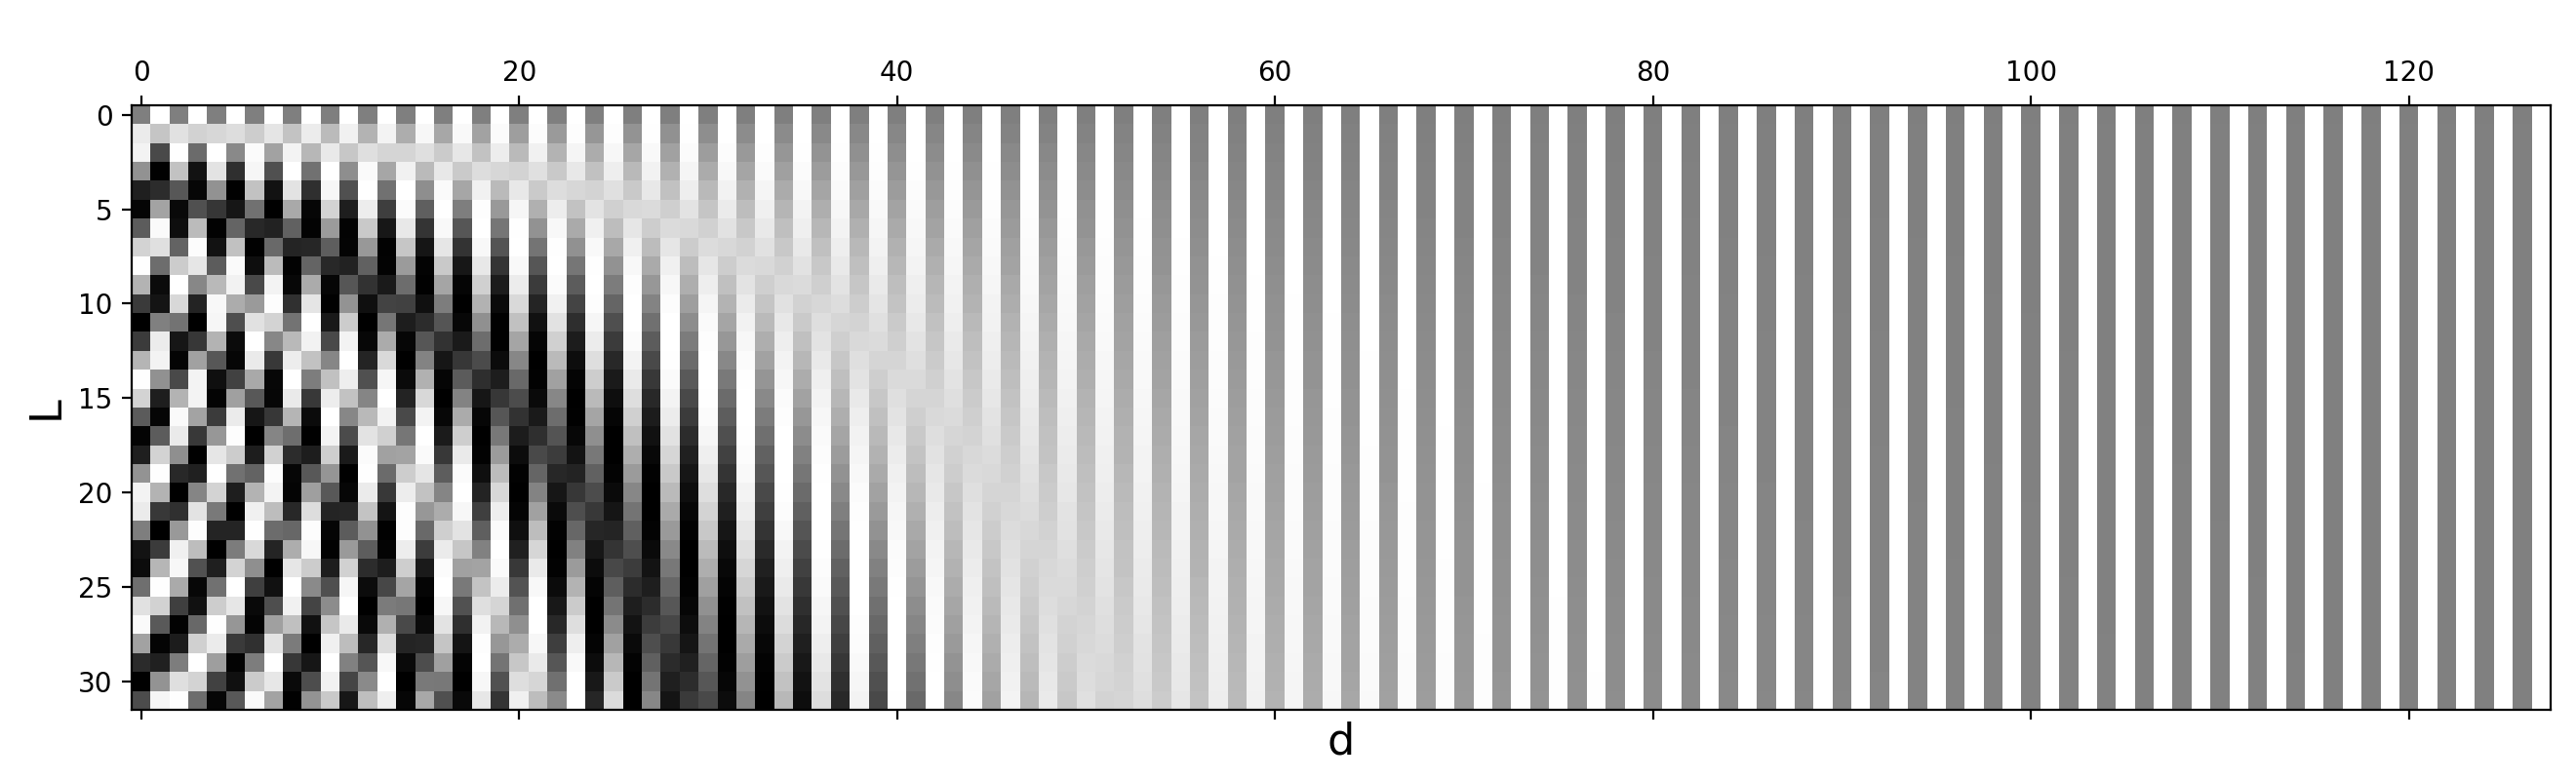 正弦位置编码,$L=32$ 和$d=128$。值介于-1(黑色)和1(白色)之间,值0 为灰色。
$$
A_{ij}^k=P^k_{\text{clip}(j - i, k)} \quad
A_{ij}^v=P^v_{\text{clip}(j - i, k)} \quad
\text{其中}\text{剪辑}(x, k)=\text{剪辑}(x, -k, k)
$$
Transformer-XL(Dai 等人,2019)提出了一种基于键和查询点积重新参数化的相对位置编码。为了保持各段之间位置信息的连贯流动,Transformer-XL 对相对位置进行编码,因为它足以知道一个关键向量$\mathbf{k}_{\tau, j}$ 与其查询$\mathbf{q}_{\tau, i}$ 之间的位置偏移量以做出良好的预测,即$i-j$。
如果省略标量$1/\sqrt{d_k}$ 和softmax 中的归一化项,但包括位置编码,我们可以将位置$i$ 处的查询和位置$j$ 处的键之间的注意力分数写为:
$$
\开始{对齐}
a_{ij}
=\mathbf{q}_i {\mathb
符号#
符号含义
$d$
模型大小/隐藏状态维度/位置编码大小。
$h$
多头注意力层中头的数量。
$L$
输入序列的段长度。
$N$
模型中注意力层的总数;不考虑教育部。
$\mathbf{X} \in \mathbb{R}^{L \times d}$
输入序列,其中每个元素已映射到形状为$d$ 的嵌入向量,与模型大小相同。
$\mathbf{W}^k \in \mathbb{R}^{d \times d_k}$
关键权重矩阵。
$\mathbf{W}^q \in \mathbb{R}^{d \times d_k}$
查询权重矩阵。
$\mathbf{W}^v \in \mathbb{R}^{d \times d_v}$
值权重矩阵。通常我们有$d_k=d_v=d$。
$\mathbf{W}^k_i, \mathbf{W}^q_i \in \mathbb{R}^{d \times d_k/h}; \mathbf{W}^v_i \in \mathbb{R}^{d \times d_v/h}$
每头的体重矩阵。
$\mathbf{W}^o \in \mathbb{R}^{d_v \times d}$
输出权重矩阵。
$\mathbf{Q}=\mathbf{X}\mathbf{W}^q \in \mathbb{R}^{L \times d_k}$
查询嵌入输入。
$\mathbf{K}=\mathbf{X}\mathbf{W}^k \in \mathbb{R}^{L \times d_k}$
关键嵌入输入。
$\mathbf{V}=\mathbf{X}\mathbf{W}^v \in \mathbb{R}^{L \times d_v}$
值嵌入输入。
$\mathbf{q}_i, \mathbf{k}_i \in \mathbb{R}^{d_k}, \mathbf{v}_i \in \mathbb{R}^{d_v}$
查询、键、值矩阵、$\mathbf{Q}$、$\mathbf{K}$ 和$\mathbf{V}$ 中的行向量。
$S_i$
第$i$ 个查询$\mathbf{q}_i$ 要关注的关键位置集合。
$\mathbf{A} \in \mathbb{R}^{L \乘L}$
长度为$L$ 的输入序列与其自身之间的自注意力矩阵。 $\mathbf{A}=\text{softmax}(\mathbf{Q}\mathbf{K}^\top/\sqrt{d_k})$。
$a_{ij} \in \mathbf{A}$
查询$\mathbf{q}_i$ 和键$\mathbf{k}_j$ 之间的标量注意力得分。
$\mathbf{P} \in \mathbb{R}^{L \times d}$
位置编码矩阵,其中第$i$ 行$\mathbf{p}_i$ 是输入$\mathbf{x}_i$ 的位置编码。
变压器基础知识#
Transformer(将被称为“vanilla Transformer”,以区别于其他增强版本;Vaswani 等,2017)模型具有编码器-解码器架构,如许多NMT 模型中常用的那样。后来简化的Transformer 在语言建模任务中表现出出色的性能,例如在仅编码器的BERT 或仅解码器的GPT 中。注意力和自我注意力#
注意力是神经网络中的一种机制,模型可以通过选择性地关注给定的数据集来学习进行预测。注意力的数量通过学习的权重来量化,因此输出通常形成为加权平均值。自注意力是一种注意力机制,模型使用同一样本的观察的其他部分来预测数据样本的一部分。从概念上讲,它感觉与非本地手段非常相似。还要注意,自注意力是排列不变的;换句话说,它是集合上的运算。
注意力/自注意力有多种形式,Transformer (Vaswani et al. 2017) 依赖于缩放点积注意力:给定查询矩阵$\mathbf{Q}$、键矩阵$\mathbf{K}$ 和值矩阵$\mathbf{V}$,输出是值向量的加权和,其中分配给每个值槽的权重由以下点积决定:对应key:的查询
$$
\text{attn}(\mathbf{Q}, \mathbf{K}, \mathbf{V})=\text{softmax}(\frac{\mathbf{Q} {\mathbf{K}}^\top}{\sqrt{d_k}})\mathbf{V}
$$
对于查询和键向量$\mathbf{q}_i, \mathbf{k}_j \in \mathbb{R}^d$ (查询和键矩阵中的行向量),我们有一个标量分数:
$$
a_{ij}=\text{softmax}(\frac{\mathbf{q}_i {\mathbf{k}_j}^\top}{\sqrt{d_k}})
=\frac{\exp(\frac{\mathbf{q}_i {\mathbf{k}_j}^\top}{\sqrt{d_k}})}{ \sum_{r \in \mathcal{S}_i} \exp(\frac{\mathbf{q}_i {\mathbf{k}_r}^\top}{\sqrt{d_k}}) }
$$
其中$\mathcal{S}_i$ 是第$i$ 个查询要处理的关键位置的集合。
如果有兴趣,请参阅我的旧帖子以了解其他类型的关注。
多头自注意力#
多头自注意力模块是Transformer中的关键组件。多头机制不是只计算一次注意力,而是将输入分成更小的块,然后并行计算每个子空间上的缩放点积注意力。独立注意力输出被简单地连接并线性转换为预期维度。$$
\开始{对齐}
\text{MultiHeadAttn}(\mathbf{X}_q, \mathbf{X}_k, \mathbf{X}_v)=[\text{head}_1; \点; \text{head}_h] \mathbf{W}^o \\
\text{其中头}_i=\text{注意力}(\mathbf{X}_q\mathbf{W}^q_i, \mathbf{X}_k\mathbf{W}^k_i, \mathbf{X}_v\mathbf{W}^v_i)
\结束{对齐}
$$
其中$[.]$ 是串联操作。 $\mathbf{W}^q_i、\mathbf{W}^k_i \in \mathbb{R}^{d \times d_k/h}、\mathbf{W}^v_i \in \mathbb{R}^{d \times d_v/h}$ 是将大小为$L \times d$ 的输入嵌入映射到查询、键和值矩阵的权重矩阵。 $\mathbf{W}^o \in \mathbb{R}^{d_v \times d}$ 是输出线性变换。所有的重量都应该在训练过程中学习。
编码器-解码器架构#
编码器生成基于注意力的表示,能够从大的上下文中定位特定的信息。它由6 个身份模块组成,每个模块包含两个身份模块子模块、一个多头自注意力层和一个逐点全连接前馈网络。逐点意味着它对序列中的每个元素应用相同的线性变换(具有相同的权重)。这也可以看作是滤波器大小为1 的卷积层。每个子模块都有残差连接和层归一化。所有子模块输出相同维度$d$的数据。Transformer 解码器的功能是从编码表示中检索信息。该架构与编码器非常相似,只是解码器包含两个多头注意力子模块,而不是每个相同的重复模块中都有一个。第一个多头注意力子模块被屏蔽,以防止位置关注未来。
位置编码#
由于自注意力操作是排列不变的,因此使用正确的位置编码为模型提供顺序信息非常重要。位置编码$\mathbf{P} \in \mathbb{R}^{L \times d}$ 与输入嵌入具有相同的维度,因此可以直接添加到输入上。普通Transformer 考虑了两种类型的编码:正弦位置编码#
正弦位置编码定义如下,给定标记位置$i=1,\dots,L$ 和维度$\delta=1,\dots,d$:$$
\text{PE}(i,\delta)=
\开始{案例}
\sin(\frac{i}{10000^{2\delta'/d}}) \text{if } \delta=2\delta'\\
\cos(\frac{i}{10000^{2\delta'/d}}) \text{if } \delta=2\delta' + 1\\
\结束{案例}
$$
这样,位置编码的每个维度对应于不同维度的不同波长的正弦曲线,从$2\pi$ 到$10000 \cdot 2\pi$。
学习位置编码#
学习位置编码为每个元素分配一个学习列向量,该列向量对其绝对位置进行编码(Gehring 等人,2017 年),而且这种编码可以按层进行不同的学习(Al-Rfou 等人,2018 年)。相对位置编码#
肖等人。 (2018)) 将相对位置信息合并到$\mathbf{W}^k$ 和$\mathbf{W}^v$ 中。最大相对位置被裁剪为最大绝对值$k$,并且此裁剪操作使模型能够泛化到看不见的序列长度。因此,考虑$2k + 1$ 个唯一边缘标签,并让我们将$\mathbf{P}^k、\mathbf{P}^v \in \mathbb{R}^{2k+1}$ 表示为可学习的相对位置表示。$$
A_{ij}^k=P^k_{\text{clip}(j - i, k)} \quad
A_{ij}^v=P^v_{\text{clip}(j - i, k)} \quad
\text{其中}\text{剪辑}(x, k)=\text{剪辑}(x, -k, k)
$$
Transformer-XL(Dai 等人,2019)提出了一种基于键和查询点积重新参数化的相对位置编码。为了保持各段之间位置信息的连贯流动,Transformer-XL 对相对位置进行编码,因为它足以知道一个关键向量$\mathbf{k}_{\tau, j}$ 与其查询$\mathbf{q}_{\tau, i}$ 之间的位置偏移量以做出良好的预测,即$i-j$。
如果省略标量$1/\sqrt{d_k}$ 和softmax 中的归一化项,但包括位置编码,我们可以将位置$i$ 处的查询和位置$j$ 处的键之间的注意力分数写为:
$$
\开始{对齐}
a_{ij}
=\mathbf{q}_i {\mathb


