


8
月
在社区成长 8 月
LEVEL 1
1 XP
当强化学习(RL)智能体利用奖励函数中的缺陷或模糊性来获得高额奖励,而没有真正学习或完成预期任务时,奖励黑客就会发生。奖励黑客行为的存在是因为强化学习环境通常不完美,并且准确指定奖励函数从根本上来说是一项挑战。
随着语言模型的兴起并推广到更广泛的任务,并且RLHF 成为对齐训练事实上的方法,语言模型RL 训练中的奖励黑客已成为一个关键的实际挑战。模型学习修改单元测试以通过编码任务的情况,或者响应包含模仿用户偏好的偏差的情况,非常令人担忧,并且可能是现实世界部署更多自主的人工智能模型用例的主要障碍之一。
过去关于这个主题的大部分工作都是相当理论化的,重点是定义或证明奖励黑客的存在。然而,对实际缓解措施的研究,特别是在RLHF 和LLM 背景下,仍然有限。我特别想呼吁开展更多研究工作,旨在理解和开发未来奖励黑客的缓解措施。希望我很快就能在专门的帖子中介绍缓解部分。
例如,在Ng 等人1999 年的一篇论文中,作者研究了如何修改马尔可夫决策过程(MDP) 中的奖励函数,以使最优策略保持不变。他们发现线性变换是有效的。给定一个MDP $M=(S, A, T, \gamma, R)$,我们希望创建一个变换后的MDP $M’=(S, A, T, \gamma, R’)$,其中$R’=R + F$ 和$F: S \times A \times S \mapsto \mathbb{R}$,这样我们就可以指导学习算法更加高效。给定一个实值函数$\Phi: S \mapsto \mathbb{R}$,$F$ 是一个基于势的整形函数,如果对于所有$s \in S - {s_0},a \in A,s’ \in S$:
$$
F(s, a, s')=\gamma \Phi(s') - \Phi(s)
$$
这将保证贴现$F$、$F(s_1, a_1, s_2) + \gamma F(s_2, a_2, s_3) + \dots$之和最终为0。如果$F$是这样一个基于势的整形函数,那么确保$M$和$M’$共享相同的最优策略是充分且必要的。
当$F(s, a, s’)=\gamma \Phi(s’) - \Phi(s)$时,如果进一步假设$\Phi(s_0)=0$,其中$s_0$为吸收态,且$\gamma=1$,则对于所有$s \in S,a \in A$:
$$
\开始{对齐}
Q^*_{M'} (s,a)=Q^*_M(s, a) - \Phi(s) \\
V^*_{M'} (s,a)=V^*_M(s, a) - \Phi(s)
\结束{对齐}
$$
这种形式的奖励塑造使我们能够将启发式方法纳入奖励函数中,以加速学习而不影响最优策略。
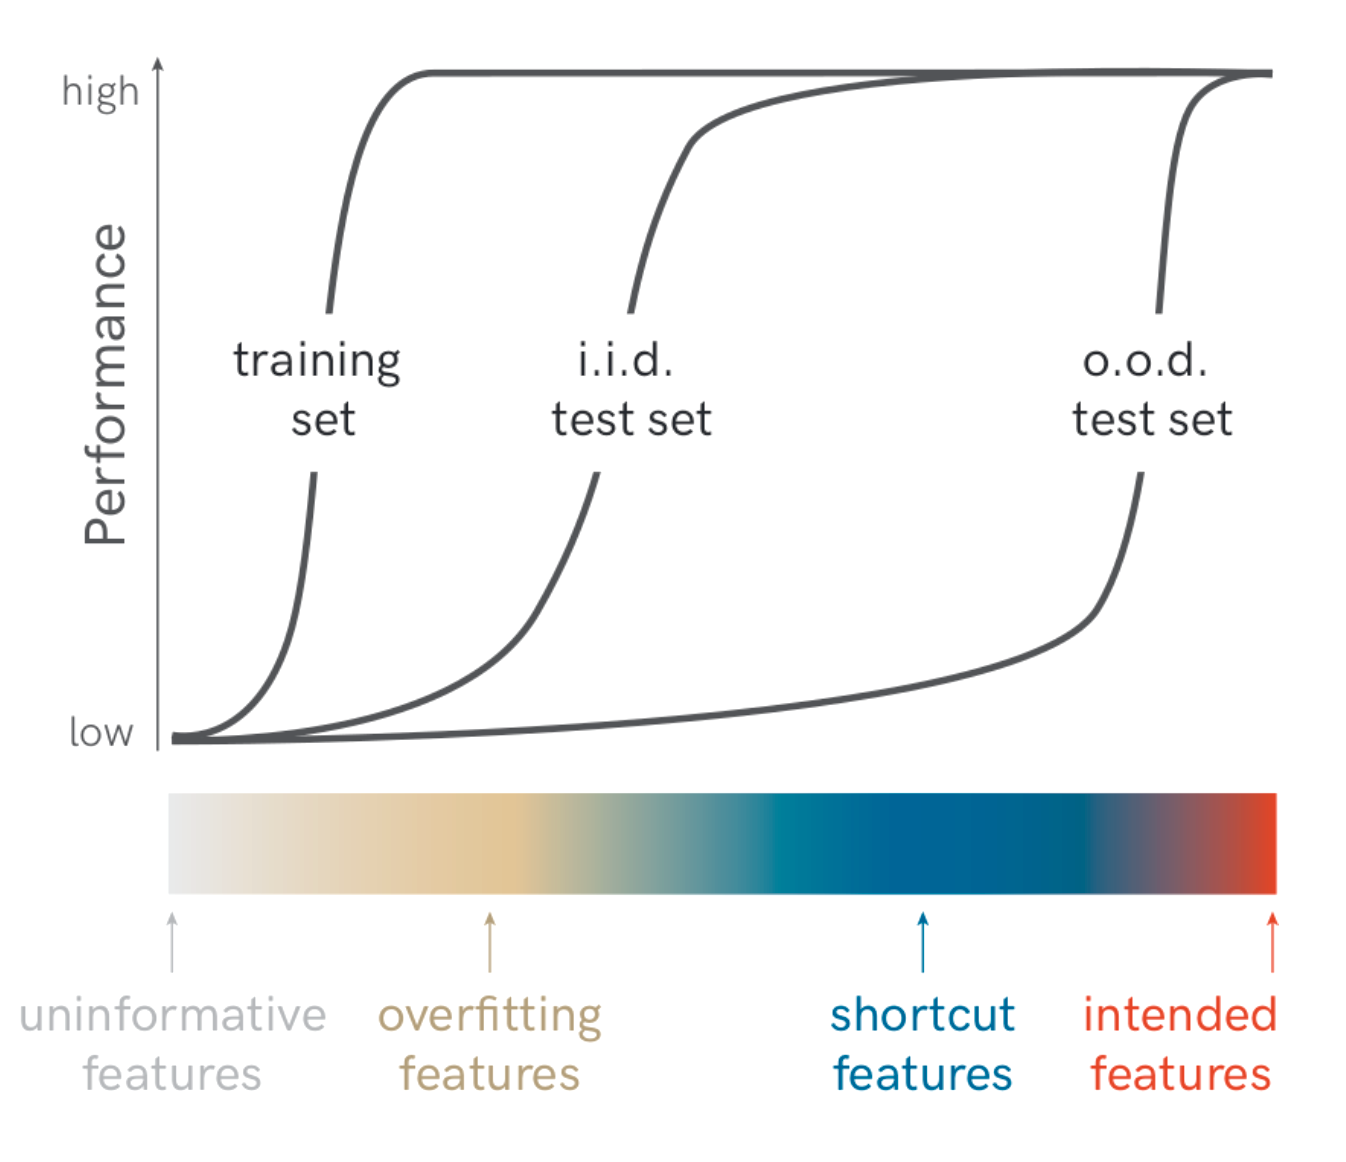 如果模型过度拟合快捷特征,则该模型在分布外(OOD) 测试集上表现不佳。 (图片来源: Geirhos et al. 2020)ERM 原则指出,由于完整的数据分布未知,因此最小化训练数据的损失是合理的风险代理,因此我们倾向于训练损失最低的模型。纳加拉詹等人。 (2021)研究了ERM原理,并指出ERM需要依赖所有类型的信息特征,包括不可靠的虚假特征,同时尝试在没有约束的情况下拟合数据。他们的实验表明,无论任务多么简单,ERM 都会依赖于虚假特征。
奖励黑客(Amodei 等人,2016)
奖励腐败(Everitt 等,2017)
奖励篡改(Everitt et al. 2019)
规范游戏(Krakovna 等人,2020)
客观稳健性(Koch 等人,2021)
目标错误概括(Langosco et al. 2022)
奖励指定错误(Pan et al. 2022)
这个概念起源于Amodei 等人。 (2016),他在其开创性论文“人工智能安全的具体问题”中提出了一系列关于人工智能安全的开放研究问题。他们将奖励黑客行为列为关键的人工智能安全问题之一。奖励黑客行为是指代理玩弄奖励函数以通过不良行为获得高额奖励的可能性。规格游戏(Krakovna et al. 2020)是一个类似的概念,定义为满足目标字面规格但未达到预期结果的行为。这里任务目标的字面描述和预期目标可能有差距。
奖励塑造是一种用于丰富奖励函数的技术,使代理更容易学习——例如,通过提供更密集的奖励。然而,设计不当的奖励塑造机制可能会改变最优政策的轨迹。设计有效的奖励塑造机制本质上是困难的。与其指责设计不佳的奖励函数,不如承认由于任务本身的复杂性、部分可观察状态、考虑的多个维度以及其他因素,设计一个好的奖励函数本质上是具有挑战性的。
在分发外(OOD) 环境中测试RL 代理时,可能会由于以下原因发生鲁棒性故障:
即使目标正确,该模型也无法有效推广。当算法缺乏足够的智能或能力时就会发生这种情况。
该模型具有很强的概括能力,但追求的目标与其训练的目标不同。当代理奖励与真实奖励函数$R’ \neq R$ 不同时,就会发生这种情况。这被称为客观鲁棒性(Koch et al. 2021)或目标错误概括(Langosco et al. 2022)
CoinRun 和Maze 两个RL 环境中的实验证明了训练过程中随机化的重要性。如果在训练过程中,硬币或奶酪被放置在固定位置(即关卡的右端或迷宫的右上角),但在随机放置硬币或奶酪的环境中进行测试,则智能体只会跑到固定位置,而不会在测试时获得硬币或奶酪。当视觉特征(例如,奶酪或硬币)和位置特征(例如,右上或右端)在测试期间不一致时,就会出现冲突,导致训练后的模型更喜欢位置特征。我想指出的是,在这两个例子中,奖励与结果的差距是明显的,但这种类型的偏见在大多数现实案例中不太可能如此明显。
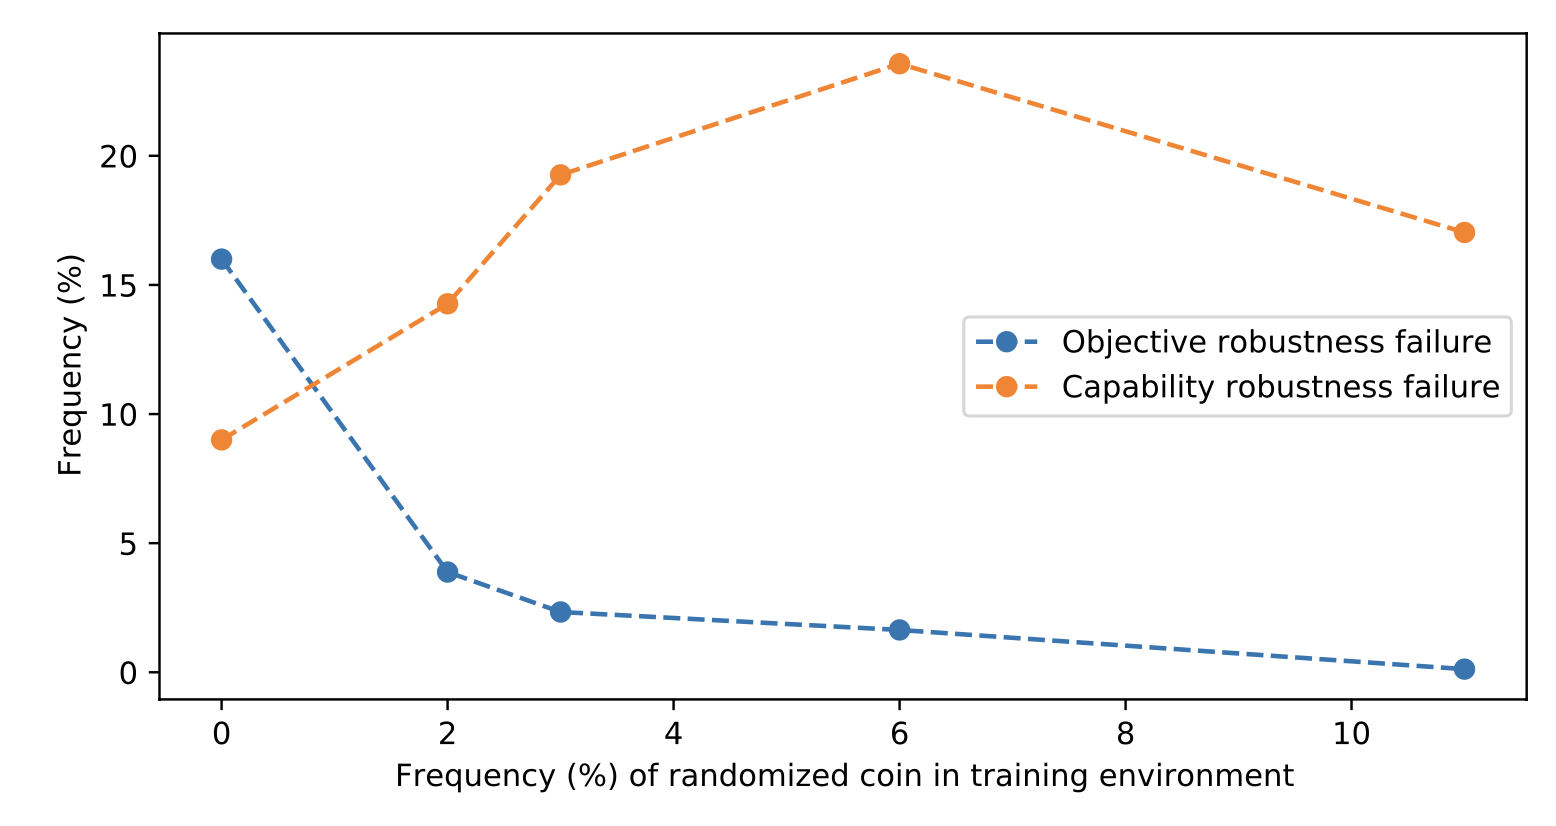 训练过程中硬币位置随机化的影响。当训练过程中随机放置硬币的时间为{0, 2, 3, 6, 11}%(x 轴)时,智能体导航到关卡末尾但未获得硬币的频率随着随机性的增加而降低(“y 轴”)。 (图片来源: Koch et al. 2021)奖励篡改(Everitt et al. 2019)是奖励黑客行为的一种形式,其中代理干扰奖励函数本身,导致观察到的奖励不再准确地代表预期目标。在奖励篡改中,模型通过直接操纵奖励函数的实现或通过改变用作奖励函数输入的环境信息来修改其奖励机制。
(Note:有些工作将奖励篡改定义为与奖励黑客不同的错位行为类别。但我认为奖励黑客在这里是一个更广泛的概念。)
在较高的层面上,黑客奖励可以分为两种类型:环境或目标指定错误以及奖励篡改。
环境或目标错误指定: 该模型通过破坏环境或优化与真实奖励目标不符的奖励函数(例如,当奖励指定错误或缺乏关键要求时)来学习不良行为,以实现高奖励。
奖励篡改: 模型学会干扰奖励机制本身。
经过训练以最大化跳跃高度的智能体可能会利用物理模拟器中的错误来达到不切实际的高度。 (链接)
智能体被训练骑自行车到达目标,并在接近目标时获得奖励。然后,智能体可以学习围绕目标绕小圈骑行,因为当智能体离开目标时,不会受到任何惩罚。
随着语言模型的兴起并推广到更广泛的任务,并且RLHF 成为对齐训练事实上的方法,语言模型RL 训练中的奖励黑客已成为一个关键的实际挑战。模型学习修改单元测试以通过编码任务的情况,或者响应包含模仿用户偏好的偏差的情况,非常令人担忧,并且可能是现实世界部署更多自主的人工智能模型用例的主要障碍之一。
过去关于这个主题的大部分工作都是相当理论化的,重点是定义或证明奖励黑客的存在。然而,对实际缓解措施的研究,特别是在RLHF 和LLM 背景下,仍然有限。我特别想呼吁开展更多研究工作,旨在理解和开发未来奖励黑客的缓解措施。希望我很快就能在专门的帖子中介绍缓解部分。
背景#
RL# 中的奖励函数
奖励函数定义任务,奖励塑造显着影响强化学习选择的学习效率和准确性。为强化学习任务设计奖励函数通常感觉像是一门“黑暗艺术”。许多因素导致了这种复杂性: 您如何将大目标分解为小目标?奖励是稀疏的还是密集的?你如何衡量成功?各种因素都可能导致良好或有问题的学习动态,包括无法学习的任务或可破解的奖励函数。关于如何在强化学习中进行奖励塑造的研究有着悠久的历史。例如,在Ng 等人1999 年的一篇论文中,作者研究了如何修改马尔可夫决策过程(MDP) 中的奖励函数,以使最优策略保持不变。他们发现线性变换是有效的。给定一个MDP $M=(S, A, T, \gamma, R)$,我们希望创建一个变换后的MDP $M’=(S, A, T, \gamma, R’)$,其中$R’=R + F$ 和$F: S \times A \times S \mapsto \mathbb{R}$,这样我们就可以指导学习算法更加高效。给定一个实值函数$\Phi: S \mapsto \mathbb{R}$,$F$ 是一个基于势的整形函数,如果对于所有$s \in S - {s_0},a \in A,s’ \in S$:
$$
F(s, a, s')=\gamma \Phi(s') - \Phi(s)
$$
这将保证贴现$F$、$F(s_1, a_1, s_2) + \gamma F(s_2, a_2, s_3) + \dots$之和最终为0。如果$F$是这样一个基于势的整形函数,那么确保$M$和$M’$共享相同的最优策略是充分且必要的。
当$F(s, a, s’)=\gamma \Phi(s’) - \Phi(s)$时,如果进一步假设$\Phi(s_0)=0$,其中$s_0$为吸收态,且$\gamma=1$,则对于所有$s \in S,a \in A$:
$$
\开始{对齐}
Q^*_{M'} (s,a)=Q^*_M(s, a) - \Phi(s) \\
V^*_{M'} (s,a)=V^*_M(s, a) - \Phi(s)
\结束{对齐}
$$
这种形式的奖励塑造使我们能够将启发式方法纳入奖励函数中,以加速学习而不影响最优策略。
虚假相关性#
分类任务中的虚假相关性或捷径学习(Geirhos et al. 2020)是与奖励黑客密切相关的概念。虚假或快捷特征可能会导致分类器无法按预期进行学习和泛化。例如,如果所有狼训练图像都包含雪,则用于区分狼和哈士奇的二元分类器可能会过度拟合雪背景的存在(Ribeiro et al. 2024)。
让我们定义奖励黑客#
RL 中的奖励塑造具有挑战性。当强化学习代理利用奖励函数中的缺陷或模糊性来获取高额奖励而没有真正学习预期行为或完成设计的任务时,奖励黑客就会发生。近年来,已经提出了几个相关概念,均指某种形式的奖励黑客:奖励黑客(Amodei 等人,2016)
奖励腐败(Everitt 等,2017)
奖励篡改(Everitt et al. 2019)
规范游戏(Krakovna 等人,2020)
客观稳健性(Koch 等人,2021)
目标错误概括(Langosco et al. 2022)
奖励指定错误(Pan et al. 2022)
这个概念起源于Amodei 等人。 (2016),他在其开创性论文“人工智能安全的具体问题”中提出了一系列关于人工智能安全的开放研究问题。他们将奖励黑客行为列为关键的人工智能安全问题之一。奖励黑客行为是指代理玩弄奖励函数以通过不良行为获得高额奖励的可能性。规格游戏(Krakovna et al. 2020)是一个类似的概念,定义为满足目标字面规格但未达到预期结果的行为。这里任务目标的字面描述和预期目标可能有差距。
奖励塑造是一种用于丰富奖励函数的技术,使代理更容易学习——例如,通过提供更密集的奖励。然而,设计不当的奖励塑造机制可能会改变最优政策的轨迹。设计有效的奖励塑造机制本质上是困难的。与其指责设计不佳的奖励函数,不如承认由于任务本身的复杂性、部分可观察状态、考虑的多个维度以及其他因素,设计一个好的奖励函数本质上是具有挑战性的。
在分发外(OOD) 环境中测试RL 代理时,可能会由于以下原因发生鲁棒性故障:
即使目标正确,该模型也无法有效推广。当算法缺乏足够的智能或能力时就会发生这种情况。
该模型具有很强的概括能力,但追求的目标与其训练的目标不同。当代理奖励与真实奖励函数$R’ \neq R$ 不同时,就会发生这种情况。这被称为客观鲁棒性(Koch et al. 2021)或目标错误概括(Langosco et al. 2022)
CoinRun 和Maze 两个RL 环境中的实验证明了训练过程中随机化的重要性。如果在训练过程中,硬币或奶酪被放置在固定位置(即关卡的右端或迷宫的右上角),但在随机放置硬币或奶酪的环境中进行测试,则智能体只会跑到固定位置,而不会在测试时获得硬币或奶酪。当视觉特征(例如,奶酪或硬币)和位置特征(例如,右上或右端)在测试期间不一致时,就会出现冲突,导致训练后的模型更喜欢位置特征。我想指出的是,在这两个例子中,奖励与结果的差距是明显的,但这种类型的偏见在大多数现实案例中不太可能如此明显。
(Note:有些工作将奖励篡改定义为与奖励黑客不同的错位行为类别。但我认为奖励黑客在这里是一个更广泛的概念。)
在较高的层面上,黑客奖励可以分为两种类型:环境或目标指定错误以及奖励篡改。
环境或目标错误指定: 该模型通过破坏环境或优化与真实奖励目标不符的奖励函数(例如,当奖励指定错误或缺乏关键要求时)来学习不良行为,以实现高奖励。
奖励篡改: 模型学会干扰奖励机制本身。
示例列表#
强化学习任务中的奖励黑客示例#
经过训练可以抓取物体的机器人手可以通过将手放在物体和相机之间来欺骗人们。 (链接)经过训练以最大化跳跃高度的智能体可能会利用物理模拟器中的错误来达到不切实际的高度。 (链接)
智能体被训练骑自行车到达目标,并在接近目标时获得奖励。然后,智能体可以学习围绕目标绕小圈骑行,因为当智能体离开目标时,不会受到任何惩罚。


