


8
月
在社区成长 8 月
LEVEL 90
100 XP
基于法学硕士的聊天机器人的功能每个月都在进步。这些改进主要通过MMLU、HumanEval 和MATH(例如sonnet 3.5、gpt-4o)等基准来衡量。然而,随着这些指标变得越来越饱和,用户体验是否与这些分数成比例地增加?如果我们设想人类与人工智能协作的未来,而不是人工智能取代人类,那么当前测量对话系统的方法可能还不够,因为它们以非交互方式进行测量。
为什么有目的的对话很重要?有目的的对话是指围绕目标或意图的多轮用户聊天机器人对话。目标范围可以从“无害且有帮助”之类的通用角色到“旅行计划代理人”、“心理治疗师”或“客户服务机器人”等更具体的角色。
旅行计划是一个简单、说明性的例子。我们的偏好、同行旅行者的偏好以及现实世界情况的所有复杂性使得一次性传输所有信息的成本过于昂贵。然而,如果允许多次来回信息交换,则只有重要信息才会被选择性地交换。谈判理论提供了这样的类比——反复讨价还价比“要么接受要么放弃”的要约产生更好的结果。
事实上,分享信息只是对话的一方面。用Terry Winograd 的话说:“所有语言的使用都可以被认为是激活听者内部程序的一种方式。”我们可以将每一句话视为一方为改变另一方的世界模式而采取的故意行动。如果双方都有更复杂甚至隐藏的目标怎么办?通过这种方式,有目的的对话为我们提供了一种将人类与人工智能交互制定为协作游戏的方法,其中聊天机器人的目标是帮助人类实现某些目标。
这似乎是一种不必要的复杂性,只有学者才会关心。然而,即使对于最顽固的、以产品为导向的研究方向(如代码生成),有目的的对话也可能是有益的。现有的编码基准主要衡量一次性生成设置中的性能;然而,对于人工智能来说,要自动解决普通的Github 问题(如SWE-bench 中的问题),不太可能通过单一操作来实现——人工智能需要与人类软件工程师来回沟通,以确保它理解正确的需求,要求缺少的文档和数据,甚至在需要时要求人类伸出援手。与结对编程类似,这可以减少代码缺陷,但不会增加工时的负担。
此外,随着轮流的引入,可以释放许多新的可能性。随着交互变得长期和记忆的建立,聊天机器人可以逐渐更新用户配置文件。它还可以适应他们的喜好。想象一下一个私人助理(例如IVA、Siri),通过日常互动了解您的偏好和意图。它可以自动读取您的新信息资源(例如twitter、arxiv、Slack、NYT),并根据您的喜好为您提供早间新闻摘要。它可以为您起草电子邮件,并通过从您的编辑中学习来不断改进。
简而言之,人与人之间有意义的互动很少是从完全陌生的人开始并以一次交流结束的。人类通过多轮对话自然地相互互动,并在整个对话过程中做出相应的调整。然而,这似乎与预测下一个令牌(现代法学硕士的基石)完全相反吗?下面,我们就来看看对话系统的构成。
对话系统是如何制作的?让我们回到20 世纪70 年代,当时Roger Schank 推出了他的“餐厅脚本”作为一种对话系统[1]。该脚本将典型的餐厅体验分解为进入、点餐、用餐和付款等步骤,每个步骤都有特定的脚本化话语。当时,这些场景中的每一段对话都是经过精心策划的,使人工智能系统能够模仿真实的对话。 ELIZA(罗杰斯心理治疗师模拟器)和PARRY(模仿偏执狂个体的系统)是机器学习出现之前的另外两个早期对话系统。
将这种方法与当今基于法学硕士的对话系统进行比较,经过训练来预测下一个标记的模型如何能够通过参与对话来完成任何事情,这似乎很神秘。因此,让我们仔细研究一下对话系统是如何制作的,重点是对话格式如何发挥作用:
(1) 预训练: 训练序列模型来预测庞大的混合互联网文本语料库上的下一个标记。这些内容可能有所不同,但主要是新闻、书籍、Github 代码,以及少量论坛爬行数据,例如来自Reddit、Stack Exchange 的数据,其中可能包含类似对话的数据。
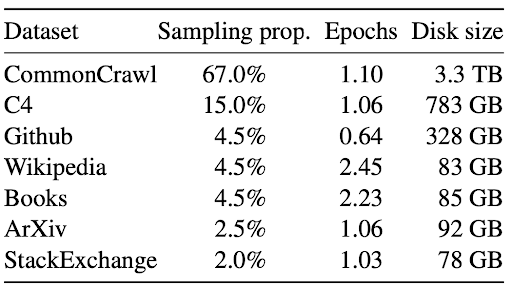 来自llama 技术报告的预训练数据混合表(2) 引入对话格式化: 因为序列模型只处理字符串,而对话历史最自然的表示是系统提示和过去交流的结构化索引,必须引入某种格式化才能进行转换。为了方便用户,一些Huggingface tokenizer 提供了名为tokenizer.apply_chat_template 的方法。确切的格式因模型而异,但通常涉及使用system 或INST 来保护系统提示,希望预训练的模型可以为它们分配更多的注意力权重。系统提示符在使语言模型适应下游应用程序并确保其安全行为方面发挥着重要作用(我们将在下一节中详细讨论)。值得注意的是,这一步格式的选择是任意的——预训练语料库不遵循这种格式。
 聊天机器人的上下文窗口(3) RLHF: 在此步骤中,聊天机器人因生成期望或不期望的答案而受到直接奖励或惩罚。值得注意的是,这是引入的对话格式首次出现在训练数据中。 RLHF 是一个微调步骤,不仅因为数据量与预训练语料库相比相形见绌,而且还因为KL 惩罚和目标权重调整(例如Lora)。用Lecun对蛋糕烘焙的比喻来说,RLHF只是顶部的小樱桃。
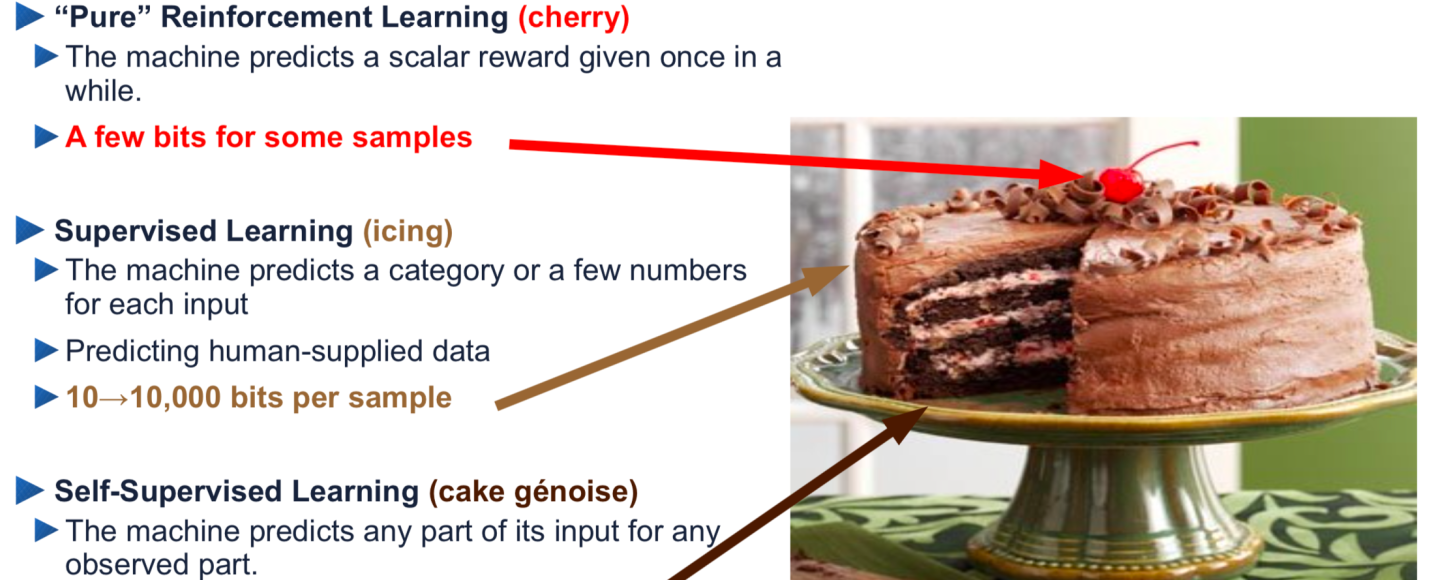 来自Yann Lecun 幻灯片的图片
目前,“系统提示”是用户控制LM行为的主要方法。然而,研究人员发现证据表明法学硕士在对抗性条件下遵循这些指示可能很脆弱[12,13]。读者可能在与ChatGPT 或Claude 的日常交互中也经历过这一点——当新打开一个新的聊天窗口时,模型可以很好地遵循你的指令[2],但经过几轮对话后,它就不再新鲜了,甚至完全不再遵循它的角色了。
我们如何定量地捕捉这个轶事?对于一轮指令跟踪,我们已经使用了大量基准测试,例如MT-Bench 和Alpaca-Eval。然而,当我们以交互方式测试模型时,很难预测模型会生成什么并提前准备回复。在我和我的合作者的一个项目中[3],我们构建了一个环境来合成无限长度的对话,以对LLM 聊天机器人的指令跟踪能力进行压力测试。
为了允许在时间尺度上不受限制的扩展,我们让两个系统提示的LM 代理在延长的轮次中相互聊天。这形成了对话的主干[a1, b1, a2, b2, …, a8, b8](假设对话是8轮)。此时,我们也许可以通过检查此对话来弄清楚法学硕士如何遵守其系统提示,但许多话语可能与说明无关,具体取决于对话的进行情况。因此,我们假设在每一轮中都提出一个与系统提示直接相关的问题,并使用相应的判断函数来量化其表现如何。数据集提供的只是一组三元组(系统提示、探究问题和判断函数)。
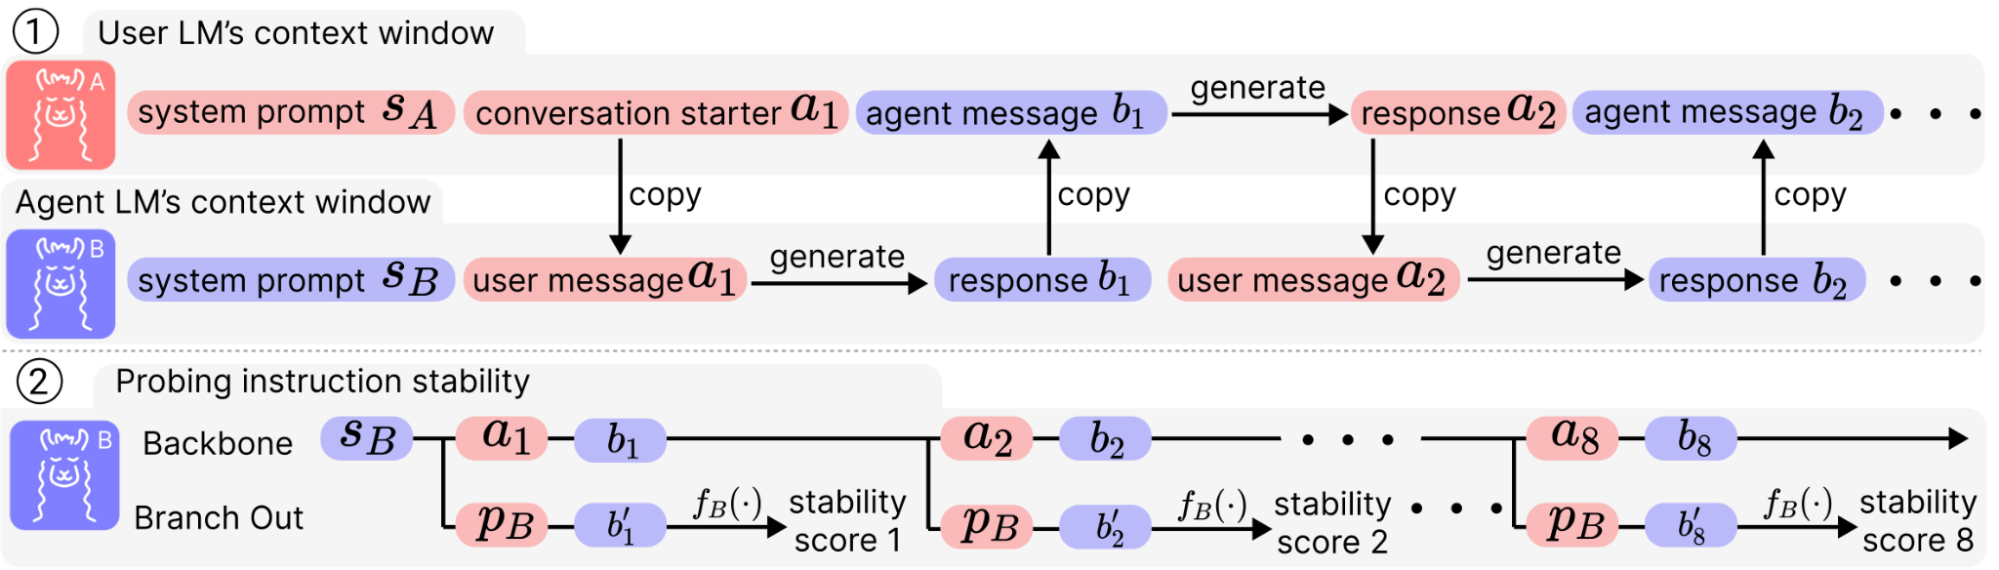 测量指令稳定性的过程示意图跨场景和成对的系统提示进行平均,我们得到了跨轮的指令稳定性曲线。令我们惊讶的是,LLaMA2-chat-70B 和gpt-3.5-turbo-16k 的汇总结果令人震惊。除了增加快速工程的难度之外,指令稳定性的缺乏还带来了安全问题。当聊天机器人偏离规定安全方面的系统提示时,它就更容易越狱,并且更容易产生幻觉。
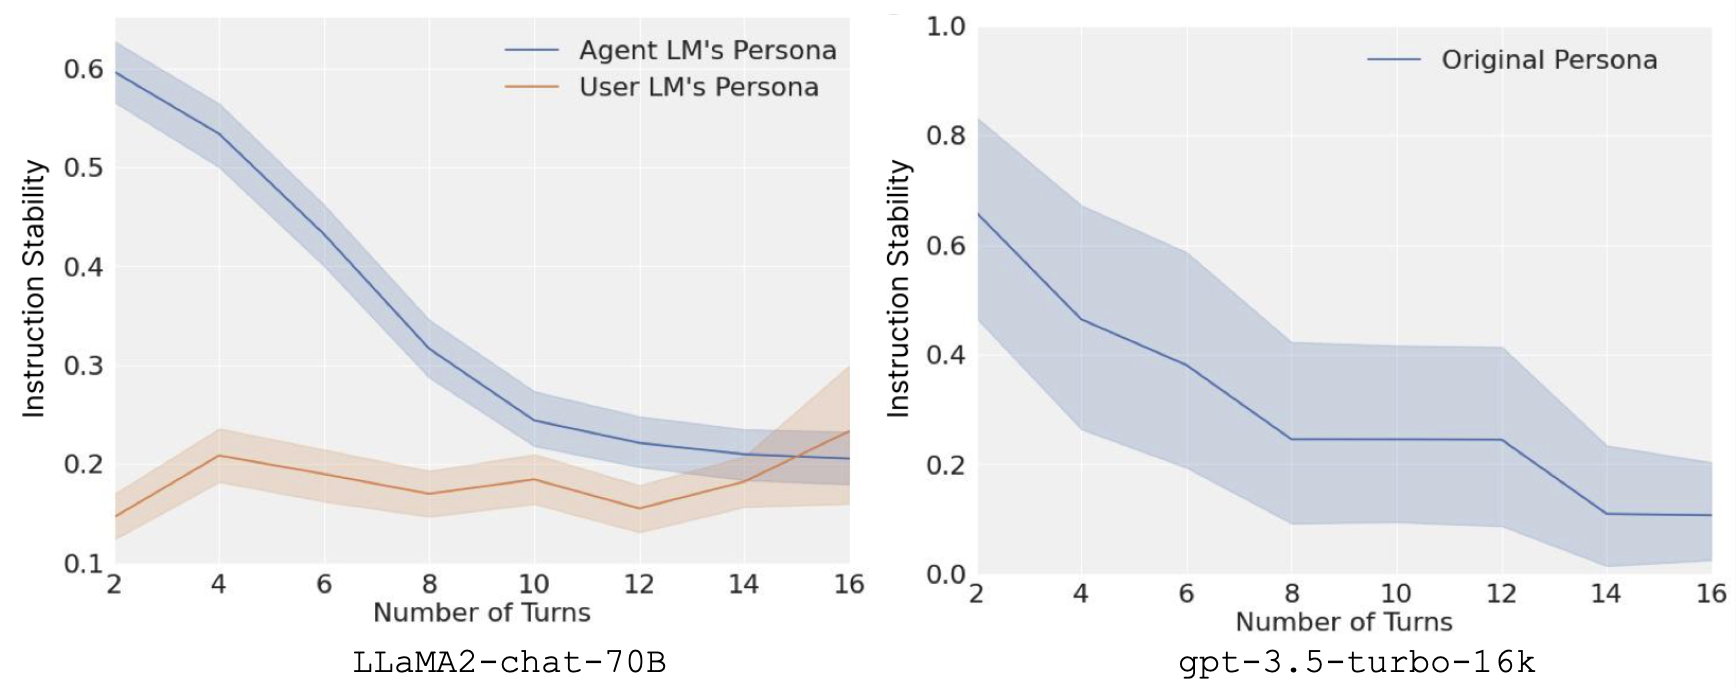 LLaMA2-chat-70B 和gpt-3.5-turbo-16k 话语的指令稳定性为100 个令牌)。在[3]中,我们进一步从理论上证明了在当前的提示方案下,基于Transformer 的LM 聊天机器人这是如何不可避免的,并提出了一种简单的技术
为什么有目的的对话很重要?有目的的对话是指围绕目标或意图的多轮用户聊天机器人对话。目标范围可以从“无害且有帮助”之类的通用角色到“旅行计划代理人”、“心理治疗师”或“客户服务机器人”等更具体的角色。
旅行计划是一个简单、说明性的例子。我们的偏好、同行旅行者的偏好以及现实世界情况的所有复杂性使得一次性传输所有信息的成本过于昂贵。然而,如果允许多次来回信息交换,则只有重要信息才会被选择性地交换。谈判理论提供了这样的类比——反复讨价还价比“要么接受要么放弃”的要约产生更好的结果。
事实上,分享信息只是对话的一方面。用Terry Winograd 的话说:“所有语言的使用都可以被认为是激活听者内部程序的一种方式。”我们可以将每一句话视为一方为改变另一方的世界模式而采取的故意行动。如果双方都有更复杂甚至隐藏的目标怎么办?通过这种方式,有目的的对话为我们提供了一种将人类与人工智能交互制定为协作游戏的方法,其中聊天机器人的目标是帮助人类实现某些目标。
这似乎是一种不必要的复杂性,只有学者才会关心。然而,即使对于最顽固的、以产品为导向的研究方向(如代码生成),有目的的对话也可能是有益的。现有的编码基准主要衡量一次性生成设置中的性能;然而,对于人工智能来说,要自动解决普通的Github 问题(如SWE-bench 中的问题),不太可能通过单一操作来实现——人工智能需要与人类软件工程师来回沟通,以确保它理解正确的需求,要求缺少的文档和数据,甚至在需要时要求人类伸出援手。与结对编程类似,这可以减少代码缺陷,但不会增加工时的负担。
此外,随着轮流的引入,可以释放许多新的可能性。随着交互变得长期和记忆的建立,聊天机器人可以逐渐更新用户配置文件。它还可以适应他们的喜好。想象一下一个私人助理(例如IVA、Siri),通过日常互动了解您的偏好和意图。它可以自动读取您的新信息资源(例如twitter、arxiv、Slack、NYT),并根据您的喜好为您提供早间新闻摘要。它可以为您起草电子邮件,并通过从您的编辑中学习来不断改进。
简而言之,人与人之间有意义的互动很少是从完全陌生的人开始并以一次交流结束的。人类通过多轮对话自然地相互互动,并在整个对话过程中做出相应的调整。然而,这似乎与预测下一个令牌(现代法学硕士的基石)完全相反吗?下面,我们就来看看对话系统的构成。
对话系统是如何制作的?让我们回到20 世纪70 年代,当时Roger Schank 推出了他的“餐厅脚本”作为一种对话系统[1]。该脚本将典型的餐厅体验分解为进入、点餐、用餐和付款等步骤,每个步骤都有特定的脚本化话语。当时,这些场景中的每一段对话都是经过精心策划的,使人工智能系统能够模仿真实的对话。 ELIZA(罗杰斯心理治疗师模拟器)和PARRY(模仿偏执狂个体的系统)是机器学习出现之前的另外两个早期对话系统。
将这种方法与当今基于法学硕士的对话系统进行比较,经过训练来预测下一个标记的模型如何能够通过参与对话来完成任何事情,这似乎很神秘。因此,让我们仔细研究一下对话系统是如何制作的,重点是对话格式如何发挥作用:
(1) 预训练: 训练序列模型来预测庞大的混合互联网文本语料库上的下一个标记。这些内容可能有所不同,但主要是新闻、书籍、Github 代码,以及少量论坛爬行数据,例如来自Reddit、Stack Exchange 的数据,其中可能包含类似对话的数据。
现有对话系统的一致性如何(2024 年)?
我们对对话系统的最低要求是它可以完成我们交给他们的任务。事实上,我们人类经常会从一个话题转移到另一个话题。当前系统的性能如何?目前,“系统提示”是用户控制LM行为的主要方法。然而,研究人员发现证据表明法学硕士在对抗性条件下遵循这些指示可能很脆弱[12,13]。读者可能在与ChatGPT 或Claude 的日常交互中也经历过这一点——当新打开一个新的聊天窗口时,模型可以很好地遵循你的指令[2],但经过几轮对话后,它就不再新鲜了,甚至完全不再遵循它的角色了。
我们如何定量地捕捉这个轶事?对于一轮指令跟踪,我们已经使用了大量基准测试,例如MT-Bench 和Alpaca-Eval。然而,当我们以交互方式测试模型时,很难预测模型会生成什么并提前准备回复。在我和我的合作者的一个项目中[3],我们构建了一个环境来合成无限长度的对话,以对LLM 聊天机器人的指令跟踪能力进行压力测试。
为了允许在时间尺度上不受限制的扩展,我们让两个系统提示的LM 代理在延长的轮次中相互聊天。这形成了对话的主干[a1, b1, a2, b2, …, a8, b8](假设对话是8轮)。此时,我们也许可以通过检查此对话来弄清楚法学硕士如何遵守其系统提示,但许多话语可能与说明无关,具体取决于对话的进行情况。因此,我们假设在每一轮中都提出一个与系统提示直接相关的问题,并使用相应的判断函数来量化其表现如何。数据集提供的只是一组三元组(系统提示、探究问题和判断函数)。


