


8
月
在社区成长 8 月
LEVEL 90
100 XP
您是否曾经训练过一个您认为很好的模型,但在应用于现实世界数据时却惨遭失败?如果是这样,那么你们的关系很好。机器学习过程很复杂,很容易导致过度拟合而不明显。在我从事机器学习的20多年里,我看到了很多这样的例子,促使我写了《如何避免机器学习陷阱:学术研究人员指南》,试图防止其他人落入这些陷阱。
但你不必相信我的话。科学媒体和大众媒体越来越多地报道这些问题。例子包括观察到在新冠病毒大流行期间开发的数百个模型根本不起作用,以及多伦多的水质系统定期告诉人们在危险的水中洗澡是安全的。其中许多都记录在AIAAIC 存储库中。甚至有人认为,这些机器学习失误正在造成科学的可重复性危机——而且,鉴于许多科学家如今将机器学习用作关键工具,人们对已发表的科学结果缺乏信任。
在本文中,我将讨论一些可能导致模型看似良好但实际上并不良好的问题。我还将讨论一些可以防止此类错误的方法,包括使用最近推出的REFORMS 检查表来进行基于ML 的科学研究。
在最坏的情况下,误导性数据可能会导致垃圾进垃圾出的现象。也就是说,您可以训练一个模型,并有可能在测试集上获得非常好的性能,但该模型没有现实世界的实用性。这方面的例子可以在前面提到的Roberts 等人对Covid 预测模型的评论中找到。预测类标签,而无需在此过程中学习任何有用的东西。
采取隐藏变量。这些是数据中存在的特征,并且恰好可以预测数据中的类标签,但与它们没有直接关系。如果您的模型在训练期间锁定了这些,它看起来会运行良好,但可能不适用于新数据。例如,在许多新冠肺炎胸部成像数据集中,身体的方向是一个隐藏变量:生病的人更有可能躺着接受扫描,而站立的人往往是健康的。因为他们学习的是这个隐藏变量,而不是疾病的真实特征,所以许多新冠病毒机器学习模型结果证明擅长预测姿势,但不擅长预测新冠病毒。尽管有它们的名字,这些隐藏变量通常是显而易见的,并且有许多分类器锁定图像中嵌入的边界标记、水印和时间戳的例子,它们通常用于区分一个类别与另一个类别,而无需查看实际数据。
一个相关问题是虚假相关性的存在。与隐藏变量不同,这些变量与数据中的其他任何内容都没有真正的关系;它们只是碰巧与类标签相关的模式。一个典型的例子是坦克问题,据称美国军方试图训练神经网络来识别坦克,但它实际上识别了天气,因为所有坦克的照片都是在一天中的同一时间拍摄的。考虑下面的图像:机器学习模型只需查看图像顶部像素的颜色就可以识别该数据集中的所有坦克图片,而无需考虑任何物体的形状。该模型的性能看起来很棒,但在实践中完全没有用处。
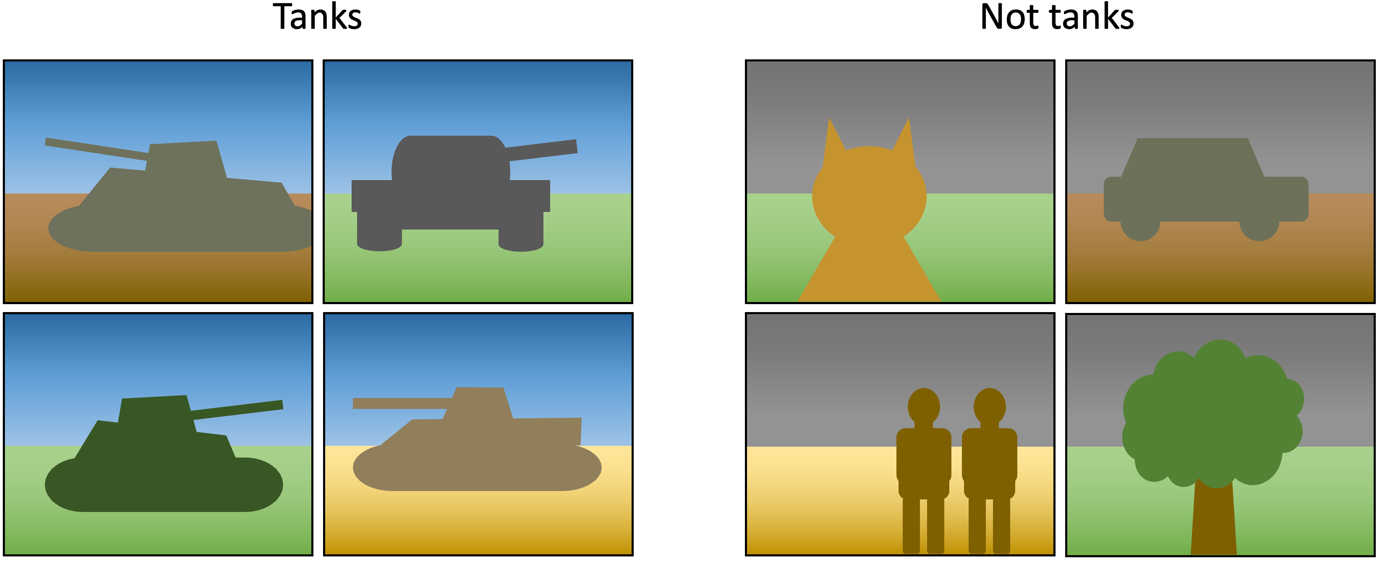 (作者来源:)许多(也许是大多数)数据集都包含虚假相关性,但它们通常不像这个那么明显。例如,众所周知,常见的计算机视觉基准具有与类别标签虚假相关的背景像素组。这对深度学习者来说是一个特殊的挑战,因为深度学习者有能力对数据中的许多模式进行建模;各种研究表明,它们确实倾向于捕捉虚假的相关模式,这降低了它们的通用性。如果深度学习模型将其预测基于图像背景像素中的虚假相关性,那么对对抗性攻击的敏感性就是这种情况的后果之一,然后对这些像素进行微小的更改就可以翻转模型的预测。对抗性训练(模型在训练过程中暴露于对抗性样本)可以用来解决这个问题,但它很昂贵。一种更简单的方法是查看您的模型,看看它使用哪些信息来做出决策。例如,如果由可解释的人工智能技术生成的显着性图表明您的模型专注于背景中的某些内容,那么它可能无法很好地概括。
有时有问题的不是数据本身,而是数据的标签。当数据由人类标记时尤其如此,并且标签最终捕获了标记者所犯的偏见、错误假设或简单的老错误。精确度为百分之零点几。也就是说,如果您的模型比竞争对手的模型表现稍好,这是由于实际的改进,还是由于标记过程中的建模噪声?当处理具有隐含主观性的数据时,例如情感分类,事情可能会更加麻烦,其中存在过度拟合特定标签的危险。
一个示例是在分割测试数据之前对整个数据集执行数据相关的预处理操作。也就是说,使用通过查看所有数据了解到的信息对所有数据进行更改。此类操作从简单的(例如居中和缩放数值特征)到复杂的(例如特征选择、降维和数据增强)各不相同,但它们都有一个共同点,即它们使用整个数据集的知识来指导其结果。这意味着测试数据的知识隐式进入模型训练管道,即使它没有明确用于训练模型。因此,从测试集得出的任何性能度量都可能高估模型的真实性能。
让我们考虑最简单的例子: 居中和缩放。这涉及查看每个特征的范围,然后使用此信息重新缩放所有值,通常使平均值为0,标准差为1。如果在分割测试数据之前在整个数据集上完成此操作,则训练数据的缩放将包括有关测试集中特征值的范围和分布的信息。如果测试集的范围比训练集更宽,这尤其成问题,因为模型可能会从训练数据中存在的截断值范围中推断出这一事实,并且仅通过预测高于或低于训练期间看到的值来在测试集上表现良好。例如,如果您正在使用一个模型根据时间序列数据进行股票价格预测,该模型接受0 到1 范围内的输入,但在训练期间只看到0 到0.5 范围内的值,那么它推断股票价格将来会上涨并不难。
事实上,预测是机器学习的一个领域,由于所谓的前瞻偏差,特别容易受到数据泄露的影响。当模型不应该访问的信息从未来泄漏并人为地提高其在测试集上的性能时,就会发生这种情况。评估时间序列预测模型的实践。
在早产预测模型的回顾中可以找到一个更复杂的数据依赖预处理操作导致过度乐观的性能指标的例子。基本上,许多论文都报道了预测婴儿是否会早产的高精度,但事实证明,所有论文在分割测试数据之前都对数据集应用了数据增强。这导致测试集包含增强的训练数据样本,训练集包含增强的测试数据样本——这很重要,相当于相当大的数据泄漏。当评论的作者
但你不必相信我的话。科学媒体和大众媒体越来越多地报道这些问题。例子包括观察到在新冠病毒大流行期间开发的数百个模型根本不起作用,以及多伦多的水质系统定期告诉人们在危险的水中洗澡是安全的。其中许多都记录在AIAAIC 存储库中。甚至有人认为,这些机器学习失误正在造成科学的可重复性危机——而且,鉴于许多科学家如今将机器学习用作关键工具,人们对已发表的科学结果缺乏信任。
在本文中,我将讨论一些可能导致模型看似良好但实际上并不良好的问题。我还将讨论一些可以防止此类错误的方法,包括使用最近推出的REFORMS 检查表来进行基于ML 的科学研究。
被数据欺骗
误导性数据是一个好的起点,或者更确切地说不是一个好的起点,因为整个机器学习过程依赖于用于训练和测试模型的数据。在最坏的情况下,误导性数据可能会导致垃圾进垃圾出的现象。也就是说,您可以训练一个模型,并有可能在测试集上获得非常好的性能,但该模型没有现实世界的实用性。这方面的例子可以在前面提到的Roberts 等人对Covid 预测模型的评论中找到。预测类标签,而无需在此过程中学习任何有用的东西。
采取隐藏变量。这些是数据中存在的特征,并且恰好可以预测数据中的类标签,但与它们没有直接关系。如果您的模型在训练期间锁定了这些,它看起来会运行良好,但可能不适用于新数据。例如,在许多新冠肺炎胸部成像数据集中,身体的方向是一个隐藏变量:生病的人更有可能躺着接受扫描,而站立的人往往是健康的。因为他们学习的是这个隐藏变量,而不是疾病的真实特征,所以许多新冠病毒机器学习模型结果证明擅长预测姿势,但不擅长预测新冠病毒。尽管有它们的名字,这些隐藏变量通常是显而易见的,并且有许多分类器锁定图像中嵌入的边界标记、水印和时间戳的例子,它们通常用于区分一个类别与另一个类别,而无需查看实际数据。
一个相关问题是虚假相关性的存在。与隐藏变量不同,这些变量与数据中的其他任何内容都没有真正的关系;它们只是碰巧与类标签相关的模式。一个典型的例子是坦克问题,据称美国军方试图训练神经网络来识别坦克,但它实际上识别了天气,因为所有坦克的照片都是在一天中的同一时间拍摄的。考虑下面的图像:机器学习模型只需查看图像顶部像素的颜色就可以识别该数据集中的所有坦克图片,而无需考虑任何物体的形状。该模型的性能看起来很棒,但在实践中完全没有用处。
有时有问题的不是数据本身,而是数据的标签。当数据由人类标记时尤其如此,并且标签最终捕获了标记者所犯的偏见、错误假设或简单的老错误。精确度为百分之零点几。也就是说,如果您的模型比竞争对手的模型表现稍好,这是由于实际的改进,还是由于标记过程中的建模噪声?当处理具有隐含主观性的数据时,例如情感分类,事情可能会更加麻烦,其中存在过度拟合特定标签的危险。
由泄密主导
错误数据并不是唯一的问题。机器学习流程中还有很多可能出错的地方。一种常见的情况是数据泄露。当模型训练管道可以访问它不应该访问的信息时,尤其是为模型带来优势的信息时,就会发生这种情况。信息泄露的方式。一个示例是在分割测试数据之前对整个数据集执行数据相关的预处理操作。也就是说,使用通过查看所有数据了解到的信息对所有数据进行更改。此类操作从简单的(例如居中和缩放数值特征)到复杂的(例如特征选择、降维和数据增强)各不相同,但它们都有一个共同点,即它们使用整个数据集的知识来指导其结果。这意味着测试数据的知识隐式进入模型训练管道,即使它没有明确用于训练模型。因此,从测试集得出的任何性能度量都可能高估模型的真实性能。
让我们考虑最简单的例子: 居中和缩放。这涉及查看每个特征的范围,然后使用此信息重新缩放所有值,通常使平均值为0,标准差为1。如果在分割测试数据之前在整个数据集上完成此操作,则训练数据的缩放将包括有关测试集中特征值的范围和分布的信息。如果测试集的范围比训练集更宽,这尤其成问题,因为模型可能会从训练数据中存在的截断值范围中推断出这一事实,并且仅通过预测高于或低于训练期间看到的值来在测试集上表现良好。例如,如果您正在使用一个模型根据时间序列数据进行股票价格预测,该模型接受0 到1 范围内的输入,但在训练期间只看到0 到0.5 范围内的值,那么它推断股票价格将来会上涨并不难。
事实上,预测是机器学习的一个领域,由于所谓的前瞻偏差,特别容易受到数据泄露的影响。当模型不应该访问的信息从未来泄漏并人为地提高其在测试集上的性能时,就会发生这种情况。评估时间序列预测模型的实践。
在早产预测模型的回顾中可以找到一个更复杂的数据依赖预处理操作导致过度乐观的性能指标的例子。基本上,许多论文都报道了预测婴儿是否会早产的高精度,但事实证明,所有论文在分割测试数据之前都对数据集应用了数据增强。这导致测试集包含增强的训练数据样本,训练集包含增强的测试数据样本——这很重要,相当于相当大的数据泄漏。当评论的作者


