


8
月
在社区成长 8 月
LEVEL 90
100 XP
变形金刚的状态空间模型
 现在,人工智能正在吞噬世界。
我所说的人工智能是指变形金刚。事实上,过去几年人工智能领域的所有重大突破都归功于变形金刚。
然而,Mamba 是称为状态空间模型(SSM) 的另一种模型之一。重要的是,Mamba 首次承诺提供与Transformer 相似的性能(以及极其相似的缩放法则),同时在长序列长度(例如100 万个令牌)下也是可行的。为了实现这个长上下文,Mamba 作者消除了注意力机制中的“二次瓶颈”。 Mamba 运行速度也很快——“比Transformer 快5 倍”1。
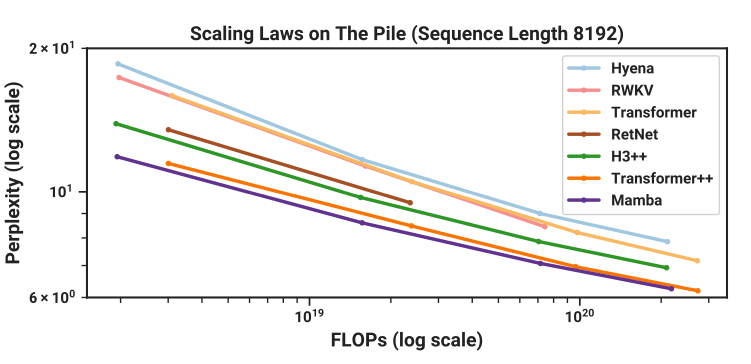 Mamba 在The Pile(来源)Gu 和Dao 上的表现与其他语言模型类似(或略好于),Mamba 作者写道:
Mamba 具有快速推理和序列长度线性缩放的特点,其性能在高达百万长度序列的实际数据上得到了提高。作为通用序列模型骨干,Mamba 在语言、音频和基因组学等多种模式上实现了最先进的性能。在语言建模方面,我们的Mamba-3B 模型在预训练和下游评估方面都优于相同大小的Transformer,并且与两倍大小的Transformer 相匹配。
在这里我们将讨论:
Mamba () 与Transformers ( ) 的优点(和缺点)、思考Mamba 的类比和直觉,以及Mamba 对于可解释性、人工智能安全和应用意味着什么。
但《变形金刚》有一个核心问题。在变压器中,每个令牌在进行预测时都可以回顾之前的每个令牌。对于此回溯,我们在所谓的KV 缓存中缓存有关每个令牌的详细信息。
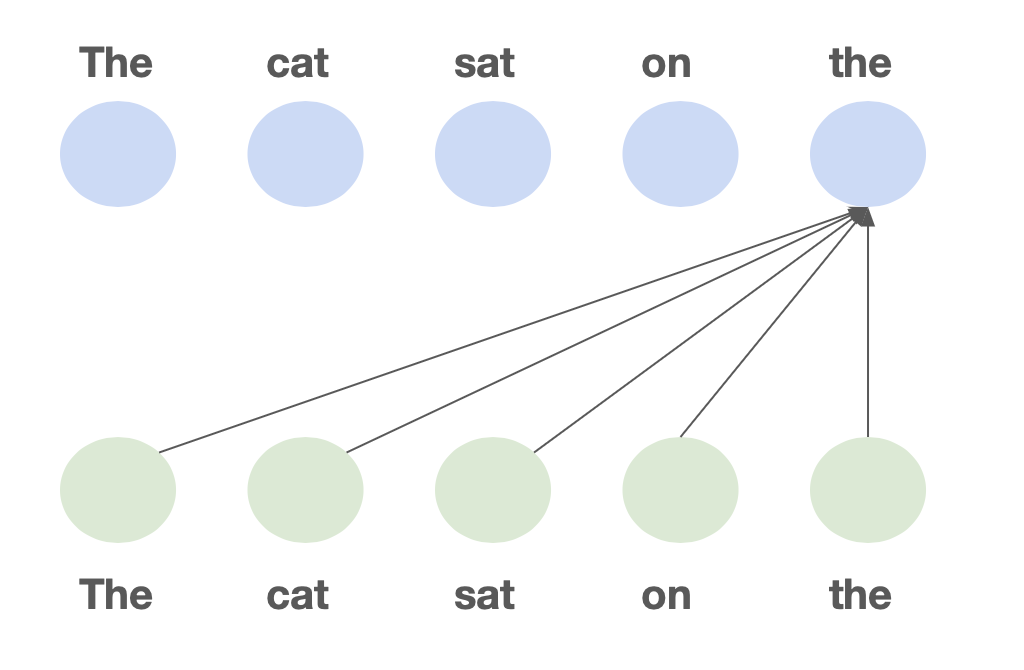 当使用注意力机制时,所有先前令牌的信息都可以传递到当前令牌。这种成对通信意味着前向传递在训练中的时间复杂度为O(n²)(可怕的二次瓶颈),并且自回归生成的每个新令牌都需要O
 时间。换句话说,随着上下文大小的增加,模型变得更慢。
雪上加霜的是,存储这个键值(KV) 缓存需要O 的空间。因此,随着内存占用的扩展,可怕的CUDA 内存不足(OOM) 错误将成为重大威胁。如果空间是唯一的问题,我们可能会考虑添加更多的GPU;然而,随着延迟呈二次方增加,简单地添加更多计算可能不是一个可行的解决方案。
在边际上,我们可以通过滑动窗口注意力等技术或FlashAttention 等巧妙的CUDA 优化来缓解二次瓶颈。但最终,对于超长的上下文窗口(例如记住您共享的每个对话的聊天机器人),我们需要一种不同的方法。
代币之间的通信代币内的计算
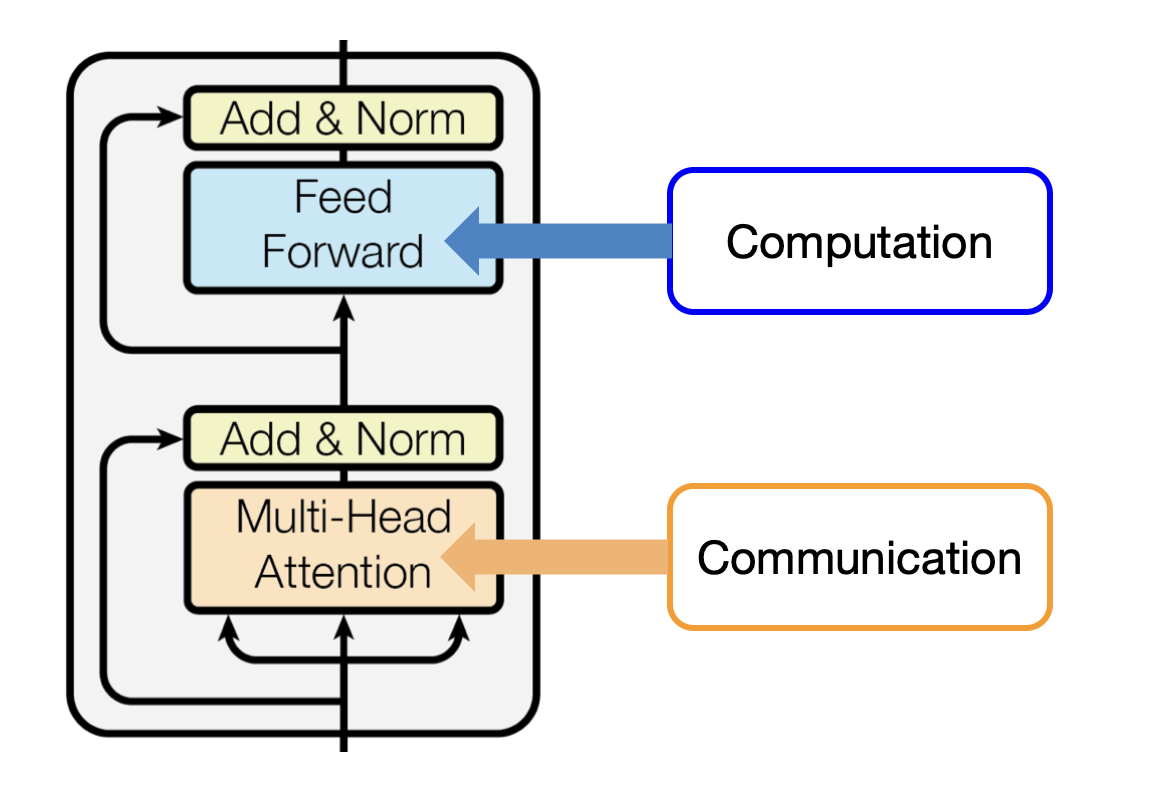 变压器块在变压器中,这是Attention(通信)和MLP(计算)。我们通过优化这两个操作来改进变压器。
我们希望用一种替代机制来替代注意力组件3,以促进代币间的通信。具体来说,Mamba 采用受控制理论启发的状态空间模型(SSM) 来实现通信目的,同时保留多层感知器(MLP) 式的投影来进行计算。
 Mamba 块就像由堆叠的变压器块组成的变压器一样,Mamba 也是由堆叠的Mamba 块组成,如上所述。
我们希望了解并激励选择SSM 进行序列转换。
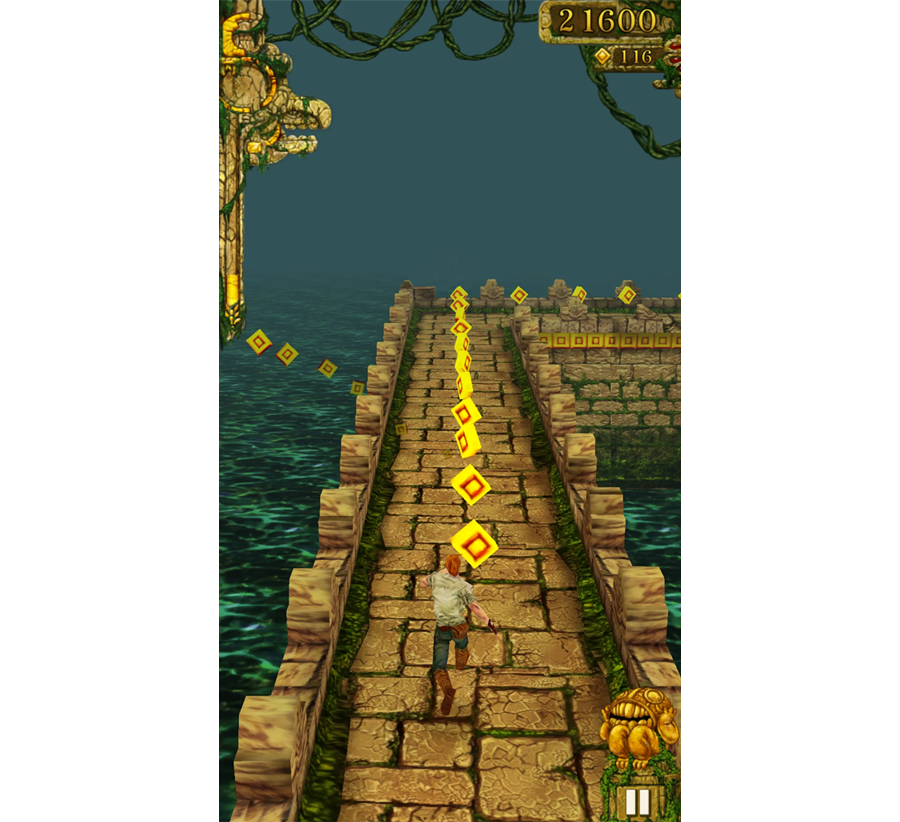 为了成功选择正确的方向,我们需要有关周围环境的信息。我们将相关信息的收集称为状态。这里的状态可能包括您当前的位置和速度、最近障碍物的位置、天气状况等。
请注意,您不需要一直看着整个屏幕。您可以通过注意到当您跑步时障碍物沿着屏幕移动来了解屏幕的大部分区域会发生什么。您只需查看屏幕顶部即可了解新信息,然后模拟其余部分。
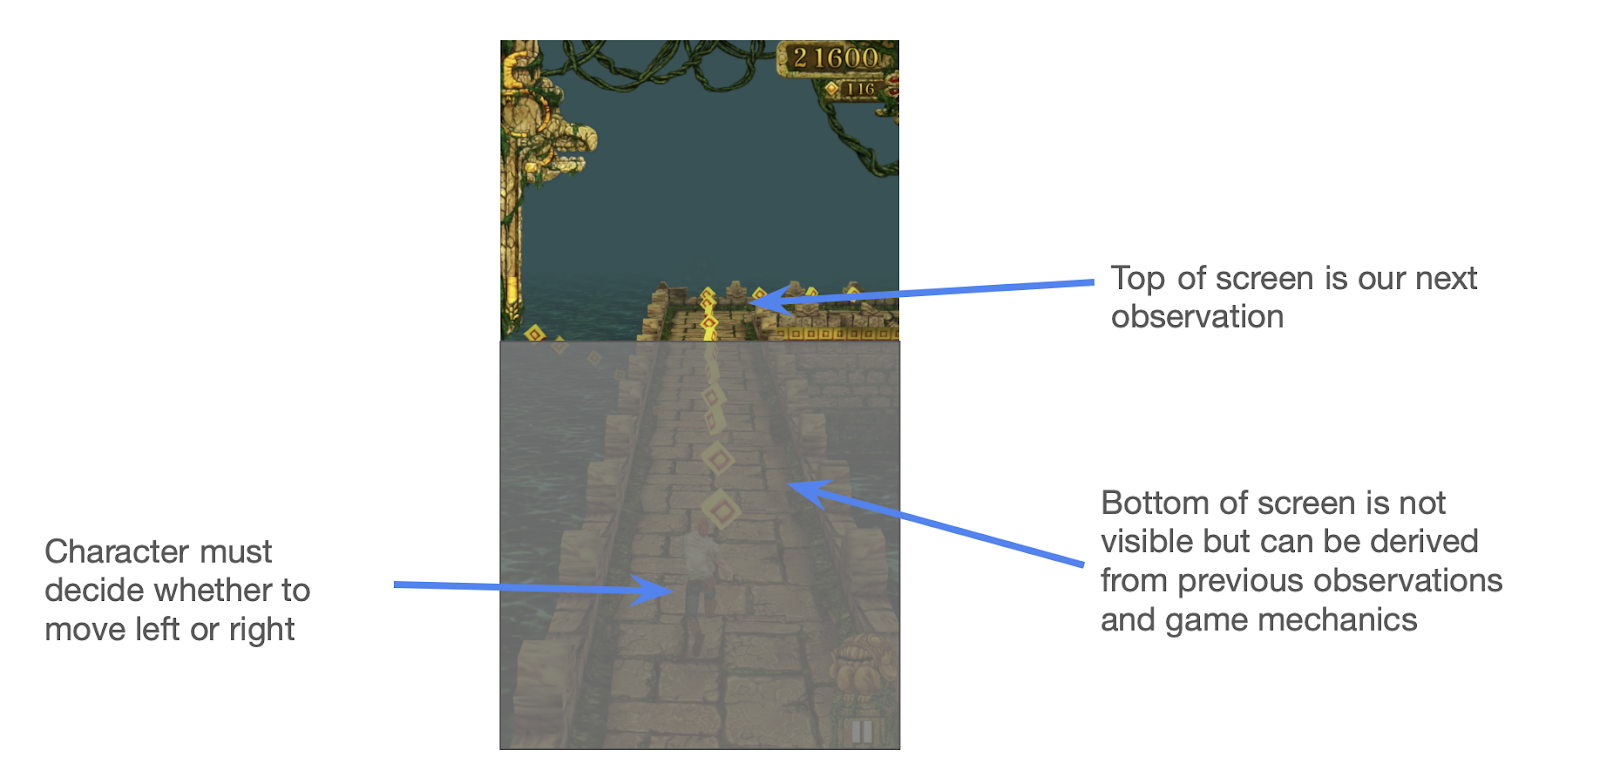 这适合于天然配方。令h 为隐藏状态,即关于世界的相关知识。还让x 为输入,即每次得到的观察结果。 h’则表示隐藏状态的导数,即状态如何演变。我们试图预测y,即最佳的下一步行动(向右或向左)。
现在,权利要求1 指出,根据隐藏状态h、h' 和新的观测值x,您可以算出y。
更具体地说,状态h 可以表示为微分方程(Eq 1a):
$h’(t)=\mathbf{A}h(t) + \mathbf{B}x(t)$
了解h 可以让您确定下一步行动y (方程1b):
$y(t)=\mathbf{C}h(t) + \mathbf{D}x(t)$
系统的演化取决于其当前状态和新获得的观测结果。一个小的新观察就足够了,因为可以通过将已知的状态动态应用于其先前的状态来推断大部分状态。也就是说,大部分屏幕都不是新的,它只是先前状态自然下降轨迹的延续。对状态的充分理解将使后续行动的最佳选择成为可能,用y 表示。
通过观察屏幕顶部,您可以了解很多有关系统动态的信息。例如,上半部分速度的增加也表明屏幕其余部分的加速,因此我们可以推断游戏正在加速5。通过这种方式,即使我们一开始对游戏一无所知并且只有有限的观察,也可以相当快速地全面了解屏幕动态。
但在实践中,这里有一些障碍。我们将时间建模为连续的。但在现实生活中,我们会在离散的时间步骤中获得新的输入并采取新的行动7。
 我们想将这个连续时间微分方程转换为离散时间差分方程。这种转换过程称为离散化。离散化是文献中经过充分研究的问题。 Mamba 使用零阶保持(ZOH) 离散化8。
根据方程1a,我们有
$h’(t)=\mathbf{A}h(t) + \mathbf{B}x(t)$
对于较小的Δ,
$h’(t)\约\frac{h(t+\Delta) - h(t)}{\Delta}$
根据导数的定义。
我们让:
$h_t=h(t)$
和
$h_{t+1}=h(t + \Delta)$
代入方程1a 得到:
$h_{t+1} - h_t \近似\Delta (\mathbf{A}h_t + \mathbf{B}x_t)$
$\Rightarrow h_{t+1} \approx (I + \Delta \mathbf{A})h_t + (\Delta
\mathbf{B})x_t$
因此,在重命名系数和重新标记索引后,我们得到了离散表示:
我所说的人工智能是指变形金刚。事实上,过去几年人工智能领域的所有重大突破都归功于变形金刚。
然而,Mamba 是称为状态空间模型(SSM) 的另一种模型之一。重要的是,Mamba 首次承诺提供与Transformer 相似的性能(以及极其相似的缩放法则),同时在长序列长度(例如100 万个令牌)下也是可行的。为了实现这个长上下文,Mamba 作者消除了注意力机制中的“二次瓶颈”。 Mamba 运行速度也很快——“比Transformer 快5 倍”1。
Mamba 具有快速推理和序列长度线性缩放的特点,其性能在高达百万长度序列的实际数据上得到了提高。作为通用序列模型骨干,Mamba 在语言、音频和基因组学等多种模式上实现了最先进的性能。在语言建模方面,我们的Mamba-3B 模型在预训练和下游评估方面都优于相同大小的Transformer,并且与两倍大小的Transformer 相匹配。
在这里我们将讨论:
Mamba () 与Transformers (
) 的优点(和缺点)、思考Mamba 的类比和直觉,以及Mamba 对于可解释性、人工智能安全和应用意味着什么。变形金刚的问题 - 也许注意力并不是您需要的全部
我们正处于历史上的变形金刚时代。机器学习过去主要用于检测猫和狗。现在,通过《变形金刚》,我们正在创作类似人类的诗歌,比中等水平的竞争性程序员更好地编码,并解决了蛋白质折叠问题。但《变形金刚》有一个核心问题。在变压器中,每个令牌在进行预测时都可以回顾之前的每个令牌。对于此回溯,我们在所谓的KV 缓存中缓存有关每个令牌的详细信息。
时间。换句话说,随着上下文大小的增加,模型变得更慢。雪上加霜的是,存储这个键值(KV) 缓存需要O
的空间。因此,随着内存占用的扩展,可怕的CUDA 内存不足(OOM) 错误将成为重大威胁。如果空间是唯一的问题,我们可能会考虑添加更多的GPU;然而,随着延迟呈二次方增加,简单地添加更多计算可能不是一个可行的解决方案。在边际上,我们可以通过滑动窗口注意力等技术或FlashAttention 等巧妙的CUDA 优化来缓解二次瓶颈。但最终,对于超长的上下文窗口(例如记住您共享的每个对话的聊天机器人),我们需要一种不同的方法。
基础模型主干
从根本上讲,所有优秀的ML 架构主干都具有用于两个重要操作的组件:代币之间的通信代币内的计算
我们希望用一种替代机制来替代注意力组件3,以促进代币间的通信。具体来说,Mamba 采用受控制理论启发的状态空间模型(SSM) 来实现通信目的,同时保留多层感知器(MLP) 式的投影来进行计算。
我们希望了解并激励选择SSM 进行序列转换。
激励曼巴 - 神庙逃亡的回归
假设我们正在构建一个Temple Run 特工4。它随时选择跑步者是否应该向左或向右移动。
请注意,您不需要一直看着整个屏幕。您可以通过注意到当您跑步时障碍物沿着屏幕移动来了解屏幕的大部分区域会发生什么。您只需查看屏幕顶部即可了解新信息,然后模拟其余部分。
现在,权利要求1 指出,根据隐藏状态h、h' 和新的观测值x,您可以算出y。
更具体地说,状态h 可以表示为微分方程(Eq 1a):
$h’(t)=\mathbf{A}h(t) + \mathbf{B}x(t)$
了解h 可以让您确定下一步行动y (方程1b):
$y(t)=\mathbf{C}h(t) + \mathbf{D}x(t)$
系统的演化取决于其当前状态和新获得的观测结果。一个小的新观察就足够了,因为可以通过将已知的状态动态应用于其先前的状态来推断大部分状态。也就是说,大部分屏幕都不是新的,它只是先前状态自然下降轨迹的延续。对状态的充分理解将使后续行动的最佳选择成为可能,用y 表示。
通过观察屏幕顶部,您可以了解很多有关系统动态的信息。例如,上半部分速度的增加也表明屏幕其余部分的加速,因此我们可以推断游戏正在加速5。通过这种方式,即使我们一开始对游戏一无所知并且只有有限的观察,也可以相当快速地全面了解屏幕动态。
什么是状态?
这里,状态是指与输入变量结合时完全确定未来系统行为的变量。理论上,一旦我们有了国家,我们就不需要了解过去来预测未来。通过这种状态选择,系统将转换为马尔可夫决策过程。理想情况下,状态是捕获系统基本属性的相当少量的信息。也就是说,状态是过去的压缩。离散化 - 如何应对量化世界中的生活
好的,太好了!因此,给定一些状态和输入观察,我们有一个自回归式系统来确定下一步动作。惊人的!但在实践中,这里有一些障碍。我们将时间建模为连续的。但在现实生活中,我们会在离散的时间步骤中获得新的输入并采取新的行动7。
根据方程1a,我们有
$h’(t)=\mathbf{A}h(t) + \mathbf{B}x(t)$
对于较小的Δ,
$h’(t)\约\frac{h(t+\Delta) - h(t)}{\Delta}$
根据导数的定义。
我们让:
$h_t=h(t)$
和
$h_{t+1}=h(t + \Delta)$
代入方程1a 得到:
$h_{t+1} - h_t \近似\Delta (\mathbf{A}h_t + \mathbf{B}x_t)$
$\Rightarrow h_{t+1} \approx (I + \Delta \mathbf{A})h_t + (\Delta
\mathbf{B})x_t$
因此,在重命名系数和重新标记索引后,我们得到了离散表示:


