


8
月
在社区成长 8 月
LEVEL 90
100 XP
[特别感谢Ian Kivlichan 提供的许多有用的指导(例如100 多年的Nature 论文“Vox populi”)和良好的反馈。 ]
高质量的数据是现代数据深度学习模型训练的燃料。大多数任务特定的标记数据来自人工注释,例如用于LLM 对齐训练的分类任务或RLHF 标记(可以构建为分类格式)。文章中的许多机器学习技术可以帮助提高数据质量,但从根本上讲,人类数据收集涉及对细节的关注和仔细的执行。社区知道高质量数据的价值,但不知何故,我们有这样一种微妙的印象:“每个人都想做模型工作,而不是数据工作”(Sambasivan 等人,2021)。
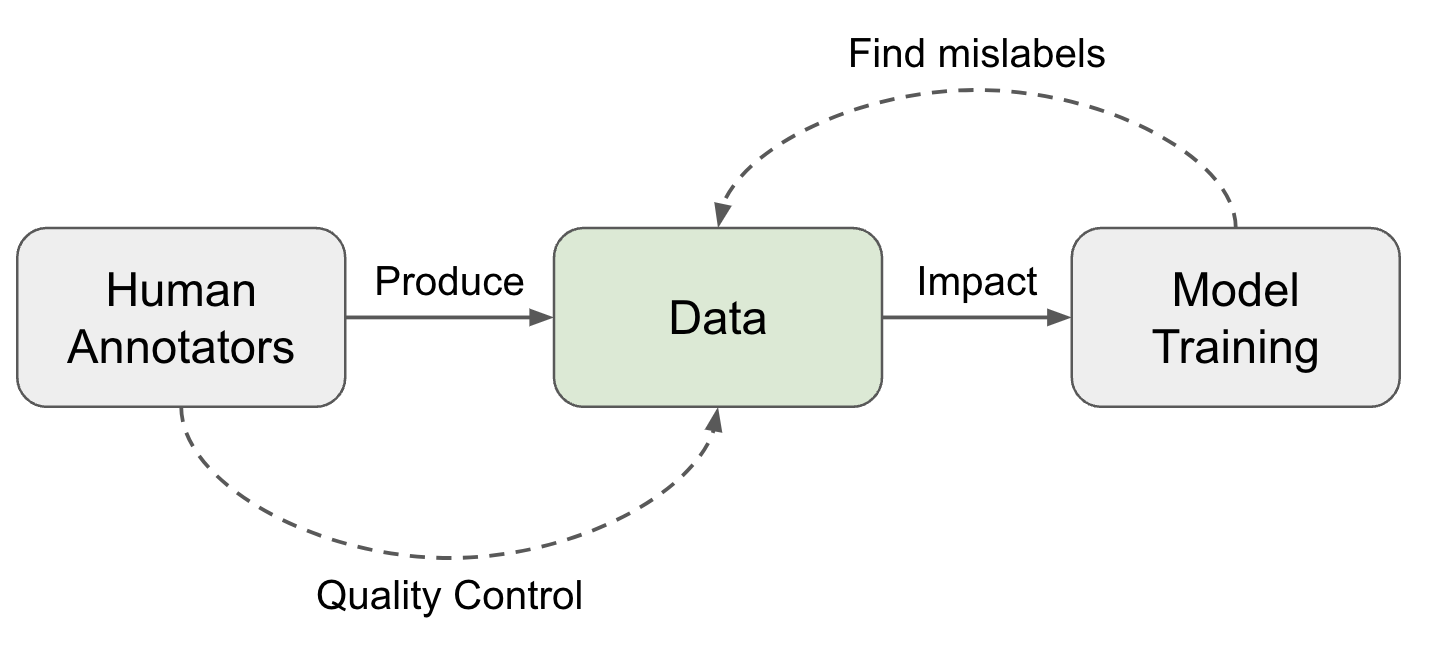 实现高数据质量的两个方向。
任务design: 设计任务工作流程以提高清晰度并降低复杂性。详细的指南很有帮助,但非常长且复杂的指南需要大量的培训才能发挥作用。
选择并培训一组评估者: 选择具有匹配技能和一致性的注释者。培训课程是必要的。入职后,还需要定期反馈和校准会议。
收集和汇总数据。在这个阶段,可以应用更多的机器学习技术来清理、过滤和智能聚合数据,以识别真正的标签。
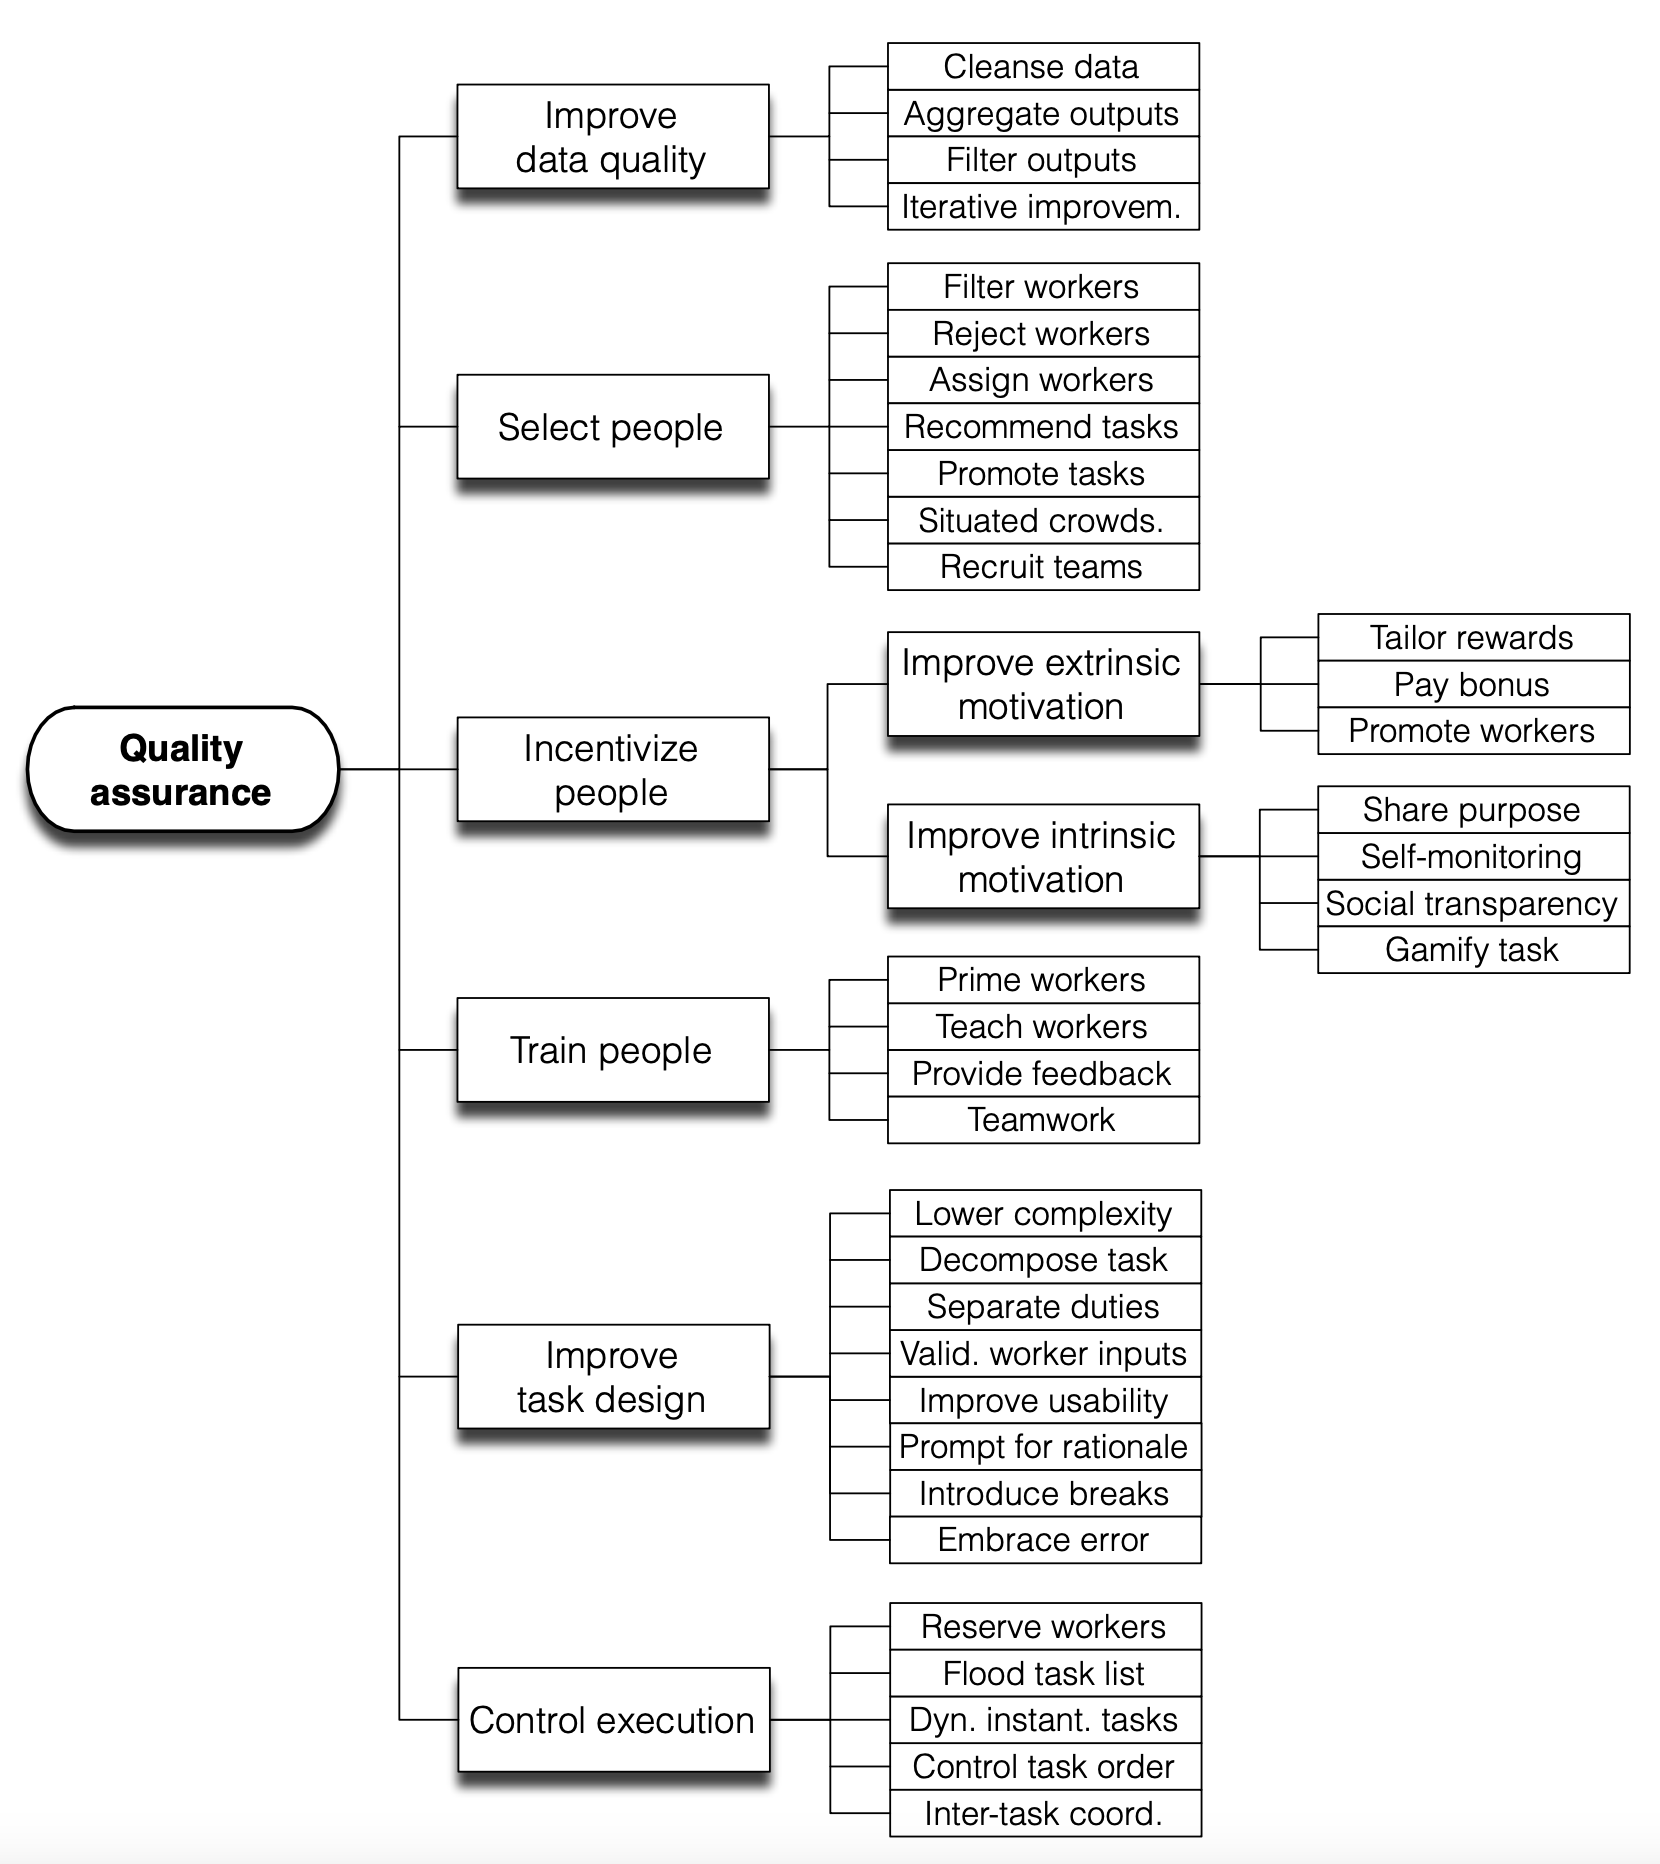 质量保证是指允许人们通过对质量模型中确定的质量属性进行操作来提高质量的一组操作。 (图片来源: Daniel et al. 2018)
近100 年后,Callison-Burch (2009) 进行了一项早期研究,使用Amazon Mechanical Turk (AMT) 对机器翻译(MT) 任务进行非专家人工评估,甚至依靠非专家创建新的黄金参考翻译。人工评估的设置很简单: 每个turker 都会看到一个源句子、一个参考翻译以及来自5 个MT 系统的5 个翻译。他们被要求对5 个翻译从最好到最差进行排名。每项任务由5 名火鸡完成。
毫不奇怪,有些垃圾邮件发送者会生成低质量的注释,只是为了优化数量。因此,在衡量专家和非专家之间的一致性时,需要采用不同的权重方案来降低垃圾邮件发送者的贡献: (1)“专家加权”:使用黄金组10个示例的专家一致性率; (2)“非专家加权”: 依赖于与其他火鸡人在整个数据集上的一致率。
在一项更艰巨的任务中,非专业的人类注释者被要求创建新的黄金参考翻译。 Callison-Burch 分两个阶段设计了该任务,第一阶段参考MT 输出创建新翻译,第二阶段过滤可能由MT 系统生成的翻译。专家翻译和众包翻译之间的相关性高于专家翻译和机器翻译系统输出之间的相关性。
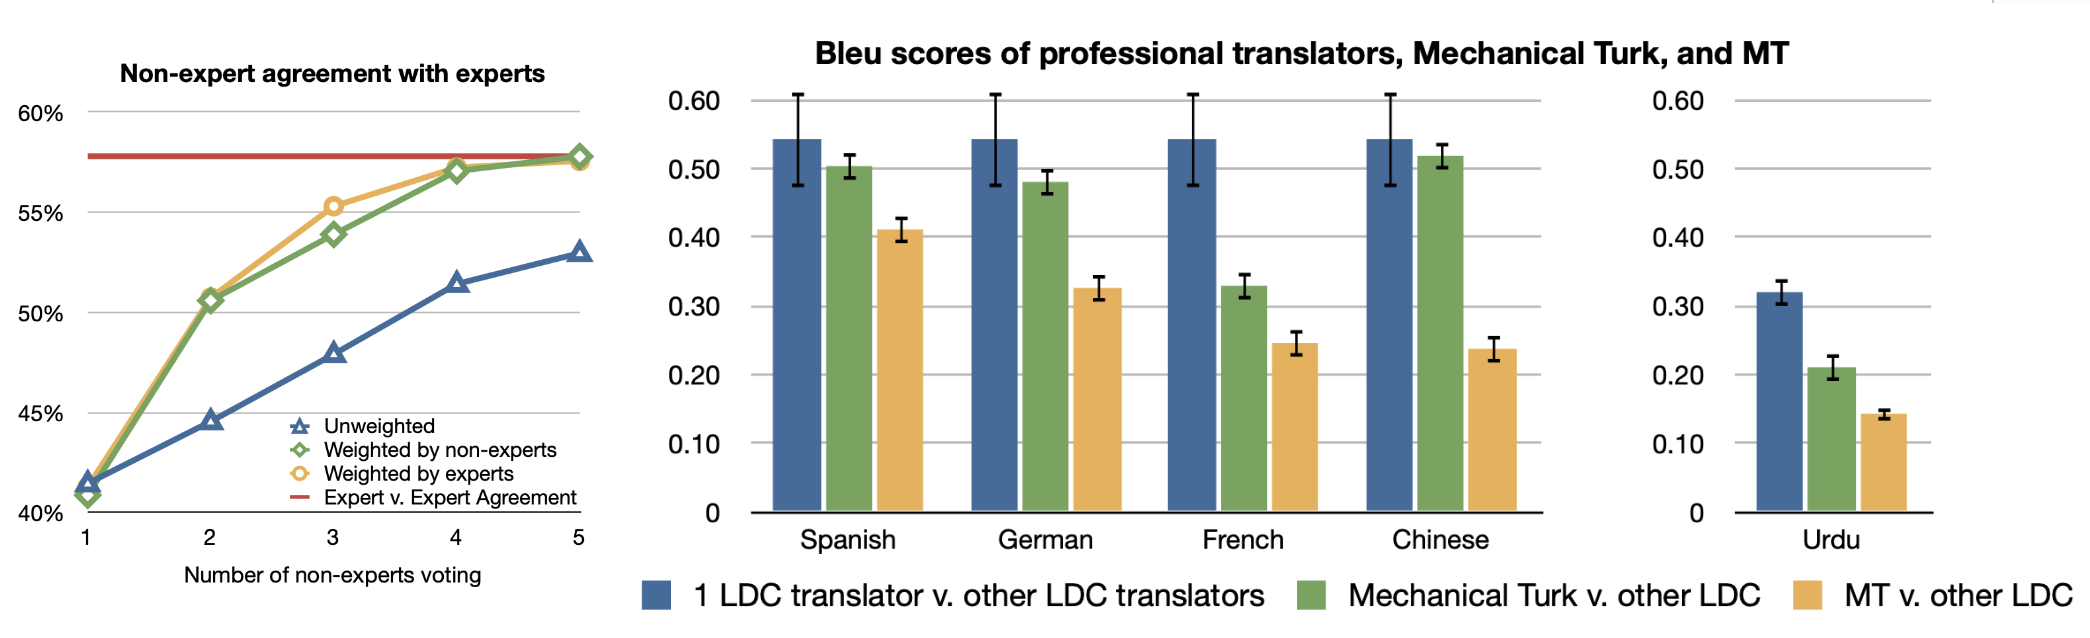 (左)通过比较每对翻译句子('A B'、'A=B'、'A B')来衡量一致率,因此机会一致率为1/3。上限由专家之间的一致率确定。 (右)不同来源的翻译之间的BLEU 分数比较。 LCD(语言数据联盟)翻译人员提供专家翻译。 (图片)source: Callison-Burch 2009)
多数投票: 采取多数投票是最简单的聚合方式,相当于采取一组标签的模式。在这种情况下,每个注释者都做出同等的贡献。
原始协议(Tratz Hovy,2010): 原始协议计算其他人同意他们的百分比。这与多数投票间接相关,因为多数类别的所有成员都有望获得更高的注释者间一致率。
Cohen’s Kappa (Landis Koch, 1977): Cohen’s kappa 以$\kappa=(p_o - p_e)/(1 - p_c)$ 的形式衡量评估者间的一致性,其中$p_o$ 是原始一致性率,$p_e$ 是偶然一致性。科恩的kappa 有一个偶然同意的修正项,但如果一个标签更普遍,则这种修正可能会被高估。
概率图建模: 有大量工作依赖于概率图建模来对注释决策中的不同因素进行建模,例如任务难度、任务潜在主题、评估者偏差、评估者置信度,然后相应地预测真实标签。郑等人。 (2017)比较了17 种众包真值推理算法,其中大多数是概率图模型。
MACE(多注释者能力估计;Hovy 等人,2013 年)是使用图建模通过提供随机标签来估计某人表现得像“垃圾邮件发送者”的可能性的早期示例。毫不奇怪,在激励措施不一致的情况下,一些注释者可能会充当“垃圾邮件发送者”,以优化完成的任务量以获得更高的报酬。 MACE 的目标是识别垃圾邮件发送者。给定任务$i$ 和注释器$j$,$T_i$ 是真实标签,$A_{ij}$ 是分配的标签,$S_{ij}$ 对注释器$j$ 发送垃圾邮件的概率进行建模。那么生成过程可以表示如下。参数$\theta_j$ 定义注释者$j$ 的可信度(不发送垃圾邮件的概率),参数$\xi_j$ 定义注释者在发送垃圾邮件时的行为方式。
$$
\开始{对齐}
\text{for } i=1 \dots N : \\
\quad T_i \sim \text{统一} \\
\quad \text{for } j=1 \dots M : \\
\quad \quad S_{ij} \sim \text{伯努利}(1 - \theta_j) \\
\quad \quad \text{if } S_{ij}=0 : \\
\quad \quad \quad A_{ij}=T_i \\
\quad \quad \text{其他} : \\
\quad \quad \quad A_{ij} \sim \text{多项式}(\xi_j) \\
\结束{对齐}
$$
然后我们可以学习$\theta,\xi$以边际数据似然的形式最大化观察到的数据,其中$A$是注释矩阵,$S$是能力指标矩阵,$T$是真实标签矩阵:
$$
P(A; \theta, \xi)=\sum_{T, S} \big[ \prod_{i=1}^N P(T_i) \cdot \prod_{j=1}^M P(S_{ij}; \theta_j) \cdot P(A_{ij} \vert S_{ij}, T_i; \xi_j) \big]
$$
可以应用EM(期望最大化)或VB(变分贝叶斯)来最大化上述边际似然。在EM 优化期间,在M 步,在归一化之前将固定值$\delta$ 添加到分数计数中。在VB 训练期间,他们在$\theta_j$ 上应用对称Beta 先验,在$\xi_j$ 上应用对称Dirichlet 先验。当恢复正确答案时,我们可以通过注释者的$\theta$ 估计来进行多数投票加权。
Aroyo Welty(2015)讨论了人类注释收集实践中的一系列“神话”,发现它们都有些不准确,主要发现包括:
对于某些样本,通常有不止一种正确的解释。我们需要不同的观点,例如让多人来审查注释质量。
分歧并不总是坏事。我们应该减少由错误或设计不当的流程引起的分歧,但其他分歧可以为我们提供丰富的信息。
如果是由于任务定义不明确造成的,我们应该加强指导。然而,更详细的指导方针并不能解决意见之间固有的多样性。
专家可能并不总是比外行人更好,但他们在考虑什么是重要的方面存在很大差距。
地面实况注释可能会随着时间而改变,尤其是那些与及时事件或新闻相关的注释。
后来,罗特格等人。 (2021) 将这种差异表述为主观NLP 任务的数据注释的两种对比范例。
描述性的
规定性的
定义
鼓励注释者的主观性,尝试为许多信念建模。
阻止注释者的主观性,试图始终如一地应用一种信念。
优点
- 可以帮助识别哪些条目更主观;
- 拥抱多样性
-莫尔
高质量的数据是现代数据深度学习模型训练的燃料。大多数任务特定的标记数据来自人工注释,例如用于LLM 对齐训练的分类任务或RLHF 标记(可以构建为分类格式)。文章中的许多机器学习技术可以帮助提高数据质量,但从根本上讲,人类数据收集涉及对细节的关注和仔细的执行。社区知道高质量数据的价值,但不知何故,我们有这样一种微妙的印象:“每个人都想做模型工作,而不是数据工作”(Sambasivan 等人,2021)。
人工评估者 ↔ 数据质量#
采集人体数据涉及一组操作步骤,每个步骤都有助于数据质量:任务design: 设计任务工作流程以提高清晰度并降低复杂性。详细的指南很有帮助,但非常长且复杂的指南需要大量的培训才能发挥作用。
选择并培训一组评估者: 选择具有匹配技能和一致性的注释者。培训课程是必要的。入职后,还需要定期反馈和校准会议。
收集和汇总数据。在这个阶段,可以应用更多的机器学习技术来清理、过滤和智能聚合数据,以识别真正的标签。
群体的智慧#
Vox populi(原为“Vox populi, vox Dei”),拉丁语短语,意思是“人民的声音”。 1907年,《自然》杂志发表了一篇同名短文。它跟踪了一年一度的展览会上的一次活动,其中选择了一头肥牛,人们会猜测这头牛的重量,如果猜测的数字接近真实数字,就可以赢得奖品。最中间的估计值被视为“民众之声”,最终非常接近真实值。作者总结道:“我认为,这一结果比预期的更值得信赖,体现了民主判断的可信度。”这可能是最早提到众包(“人群的智慧”)如何发挥作用。近100 年后,Callison-Burch (2009) 进行了一项早期研究,使用Amazon Mechanical Turk (AMT) 对机器翻译(MT) 任务进行非专家人工评估,甚至依靠非专家创建新的黄金参考翻译。人工评估的设置很简单: 每个turker 都会看到一个源句子、一个参考翻译以及来自5 个MT 系统的5 个翻译。他们被要求对5 个翻译从最好到最差进行排名。每项任务由5 名火鸡完成。
毫不奇怪,有些垃圾邮件发送者会生成低质量的注释,只是为了优化数量。因此,在衡量专家和非专家之间的一致性时,需要采用不同的权重方案来降低垃圾邮件发送者的贡献: (1)“专家加权”:使用黄金组10个示例的专家一致性率; (2)“非专家加权”: 依赖于与其他火鸡人在整个数据集上的一致率。
在一项更艰巨的任务中,非专业的人类注释者被要求创建新的黄金参考翻译。 Callison-Burch 分两个阶段设计了该任务,第一阶段参考MT 输出创建新翻译,第二阶段过滤可能由MT 系统生成的翻译。专家翻译和众包翻译之间的相关性高于专家翻译和机器翻译系统输出之间的相关性。
评估者协议#
我们经常将注释视为针对单一基本事实,并尝试根据一致标准的一个黄金答案来评估质量。寻找可靠的真实标签的常见做法是从多个评估者那里收集多个标签。假设每个评估者的质量水平不同,我们可以使用注释的加权平均值,但按熟练程度分数进行加权。该分数通常根据一个评估者与其他评估者达成一致的频率来近似。多数投票: 采取多数投票是最简单的聚合方式,相当于采取一组标签的模式。在这种情况下,每个注释者都做出同等的贡献。
原始协议(Tratz Hovy,2010): 原始协议计算其他人同意他们的百分比。这与多数投票间接相关,因为多数类别的所有成员都有望获得更高的注释者间一致率。
Cohen’s Kappa (Landis Koch, 1977): Cohen’s kappa 以$\kappa=(p_o - p_e)/(1 - p_c)$ 的形式衡量评估者间的一致性,其中$p_o$ 是原始一致性率,$p_e$ 是偶然一致性。科恩的kappa 有一个偶然同意的修正项,但如果一个标签更普遍,则这种修正可能会被高估。
概率图建模: 有大量工作依赖于概率图建模来对注释决策中的不同因素进行建模,例如任务难度、任务潜在主题、评估者偏差、评估者置信度,然后相应地预测真实标签。郑等人。 (2017)比较了17 种众包真值推理算法,其中大多数是概率图模型。
MACE(多注释者能力估计;Hovy 等人,2013 年)是使用图建模通过提供随机标签来估计某人表现得像“垃圾邮件发送者”的可能性的早期示例。毫不奇怪,在激励措施不一致的情况下,一些注释者可能会充当“垃圾邮件发送者”,以优化完成的任务量以获得更高的报酬。 MACE 的目标是识别垃圾邮件发送者。给定任务$i$ 和注释器$j$,$T_i$ 是真实标签,$A_{ij}$ 是分配的标签,$S_{ij}$ 对注释器$j$ 发送垃圾邮件的概率进行建模。那么生成过程可以表示如下。参数$\theta_j$ 定义注释者$j$ 的可信度(不发送垃圾邮件的概率),参数$\xi_j$ 定义注释者在发送垃圾邮件时的行为方式。
$$
\开始{对齐}
\text{for } i=1 \dots N : \\
\quad T_i \sim \text{统一} \\
\quad \text{for } j=1 \dots M : \\
\quad \quad S_{ij} \sim \text{伯努利}(1 - \theta_j) \\
\quad \quad \text{if } S_{ij}=0 : \\
\quad \quad \quad A_{ij}=T_i \\
\quad \quad \text{其他} : \\
\quad \quad \quad A_{ij} \sim \text{多项式}(\xi_j) \\
\结束{对齐}
$$
然后我们可以学习$\theta,\xi$以边际数据似然的形式最大化观察到的数据,其中$A$是注释矩阵,$S$是能力指标矩阵,$T$是真实标签矩阵:
$$
P(A; \theta, \xi)=\sum_{T, S} \big[ \prod_{i=1}^N P(T_i) \cdot \prod_{j=1}^M P(S_{ij}; \theta_j) \cdot P(A_{ij} \vert S_{ij}, T_i; \xi_j) \big]
$$
可以应用EM(期望最大化)或VB(变分贝叶斯)来最大化上述边际似然。在EM 优化期间,在M 步,在归一化之前将固定值$\delta$ 添加到分数计数中。在VB 训练期间,他们在$\theta_j$ 上应用对称Beta 先验,在$\xi_j$ 上应用对称Dirichlet 先验。当恢复正确答案时,我们可以通过注释者的$\theta$ 估计来进行多数投票加权。
评估者分歧的两种范式#
上述聚合过程取决于这样一个假设:存在一个潜在的黄金答案,因此我们可以相应地评估注释者的表现。然而,在许多话题上,特别是在安全、社会或文化领域,人们可能会存在分歧,而且这种分歧通常是有效的,然后就取决于我们在多大程度上想要应用严格的规则而不是拥抱多样性。Aroyo Welty(2015)讨论了人类注释收集实践中的一系列“神话”,发现它们都有些不准确,主要发现包括:
对于某些样本,通常有不止一种正确的解释。我们需要不同的观点,例如让多人来审查注释质量。
分歧并不总是坏事。我们应该减少由错误或设计不当的流程引起的分歧,但其他分歧可以为我们提供丰富的信息。
如果是由于任务定义不明确造成的,我们应该加强指导。然而,更详细的指导方针并不能解决意见之间固有的多样性。
专家可能并不总是比外行人更好,但他们在考虑什么是重要的方面存在很大差距。
地面实况注释可能会随着时间而改变,尤其是那些与及时事件或新闻相关的注释。
后来,罗特格等人。 (2021) 将这种差异表述为主观NLP 任务的数据注释的两种对比范例。
描述性的
规定性的
定义
鼓励注释者的主观性,尝试为许多信念建模。
阻止注释者的主观性,试图始终如一地应用一种信念。
优点
- 可以帮助识别哪些条目更主观;
- 拥抱多样性
-莫尔


