


8
月
在社区成长 8 月
LEVEL 90
100 XP
AI/ML
 作者:Adrien Payong
AI顾问和技术作家
 目录热门主题
复制早期的工作作为基线需要时间,并且由于缺少源代码而增加了出错的风险。由于出版物中遗漏了一些微小的细节,完美地复制结果也具有挑战性。这些问题给该领域的基准比较带来了挑战。
像TextAttack 这样的框架已经被开发出来来应对这些挑战。它是一个用于对抗性攻击、数据增强和对抗性训练的NLP Python 框架。该框架解决了当前的挑战并激发了对抗稳健性方面的进步。这篇文章探讨了TextAttack,详细介绍了其组件。此外,还将通过深入的代码示例来检查实际实现。
Python 编程技能: 使用Python 的经验,包括安装库、编写脚本和处理数据。
PyTorch Knowledge: 对PyTorch 的基本了解,因为TextAttack 通常与基于PyTorch 的模型集成。
TextAttack 安装: 使用pip install textattack 在您的环境中安装TextAttack 框架。确保安装了NumPy、pandas 和PyTorch 等依赖项。
数据集熟悉度: 了解如何处理数据集,例如Hugging Face 数据集库中提供的数据集。
目标函数: 攻击的目标由目标函数定义,其中可以包括更改模型的预测或欺骗模型犯特定错误。
约束集: 它们是攻击必须遵守的规则,例如限制单词数量或保证所做的所有修改在语法上都是准确的。
Transformation: 转换确定如何修改输入文本以生成对抗性示例。例如,用同义词替换单词或插入/删除单词。
搜索方法: 该组件确定攻击如何探索可能修改的空间以找到最有效的对抗示例,例如使用基于梯度的方法或随机搜索算法。

图片来源
在图中,攻击模块部分显示了TextAttack 重新实现文献中的攻击的能力。本节提到我们可以使用16 篇论文和预先构建的攻击方案。
该图显示了如何使用TextAttack 以两种方式构建攻击:创建新攻击和对现有攻击进行基准测试。用户可以通过组合新的和现有的组件来创建新的对抗策略。
TextAttack 拥有超过82 个预训练模型,因此研究人员可以针对标准模型测试他们的新攻击。这使他们能够将他们的结果与之前的工作进行比较。
该图显示了attack:数据增强和对抗训练的两种方法。通过使用增强器模块,用户模型可以通过生成新样本来增强现有的训练数据集来改进。通过TextAttack 的训练流程,我们可以创建对抗性示例并将其输入训练过程中以改进我们的模型。
TextAttack 与NLP 库的集成可以自动加载相应的预训练模型以用于测试和验证数据集。虽然许多先前的文献都集中在分类和蕴涵上,但TextAttack 的一系列预训练模型为研究提供了新的途径。这使得研究人员能够深入研究所有GLUE 任务的模型稳健性。
初始训练: 该模型在干净的训练集上训练了多个时期。
对抗性示例生成: 攻击会为每个输入生成对抗性版本。
数据集替换: 此过程涉及用扰动变量替换原始数据集。
定期重新生成: 根据模型当前的弱点定期重新生成对抗数据集。
下表说明了标准LSTM 分类器针对_TextAtt_ack 中使用的各种攻击配方进行和不进行对抗性训练的准确性。

图片来源
它显示了LSTM 模型针对deepwordbug、textfooler、pruthi、hotflip 和bae 攻击的性能与其在干净训练集上的基线Carlini 得分的比较。该表比较了有攻击和没有攻击的准确性,分别评估了模型在20 和75 个epoch 时针对deepwordbug 的鲁棒性。它还评估了模型在20 个时期对textfooler 的脆弱性。
攻击配方是一组预定义的步骤和配置,用于为NLP 模型生成对抗性示例。每个攻击配方都有四个主要组成部分(目标函数、约束、转换、搜索方法)
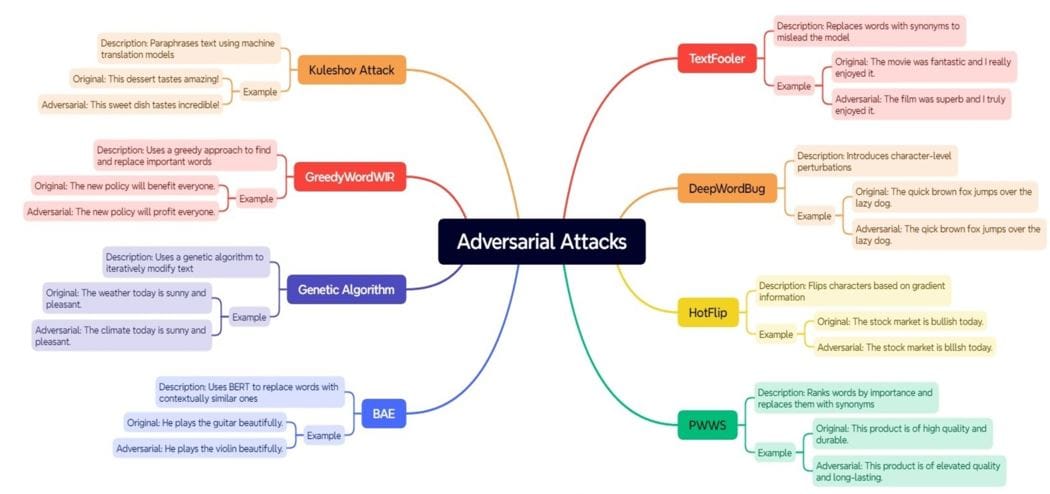
攻击秘诀是从最新研究中提炼出来的最佳实践和技术。他们加速了对抗性例子的产生。这些帮助研究人员和从业者的工作使我们能够实施复杂的攻击策略,而无需了解所有底层细节。我们在下图中说明了一些常见的攻击类型:
对抗性攻击概述
我们的情感分析模型的对抗性攻击过程
要开始攻击过程,我们必须在声明中找到与积极情绪相关的重要单词。例如,可以使用WordNet 数据库将“fantastic”替换为同义词。
我们希望尽可能保留语法正确性和原始含义。我们在贪婪算法中使用迭代方法,在每次替换时检查模型的预测。
该过程持续进行,直到无法进行更多替代来实现所需结果或预测发生变化。通过将“棒极了”这个词替换为“很棒”等等价词,可以成功地攻击该模型,从而将情绪从积极转变为消极。
在这种情况下,最初的陈述“这部电影很棒”已更改为“这部电影很棒”,因为我们可以看到模型的预测已从正面变为负面。这是模型中存在漏洞的证据。
textfooler 是一个聪明的方案,旨在暴露情感分析模型的缺陷。该技术可以通过用同义词替换关键字来显着影响模型预测,同时保持上下文连贯性。这迫使我们优先考虑培训和评估框架,以最大限度地减少此类对抗性攻击的脆弱性。
标记化“这部电影太棒了!”可能会导致“这个”、“电影”、“是”或“太棒了!”省略开头的大写字母。这使得转型变得更加困难。这种担忧可能会削弱
AI顾问和技术作家
简介
在过去几年中,人们对测试自然语言处理(NLP) 模型的对抗鲁棒性越来越感兴趣。该领域的研究涵盖了生成对抗性示例并防御它们的新技术。直接比较这些攻击具有挑战性,因为它们是根据不同的数据和受害者模型进行评估的。复制早期的工作作为基线需要时间,并且由于缺少源代码而增加了出错的风险。由于出版物中遗漏了一些微小的细节,完美地复制结果也具有挑战性。这些问题给该领域的基准比较带来了挑战。
像TextAttack 这样的框架已经被开发出来来应对这些挑战。它是一个用于对抗性攻击、数据增强和对抗性训练的NLP Python 框架。该框架解决了当前的挑战并激发了对抗稳健性方面的进步。这篇文章探讨了TextAttack,详细介绍了其组件。此外,还将通过深入的代码示例来检查实际实现。
先决条件
对NLP: 的基本了解熟悉自然语言处理(NLP) 概念,例如标记化、嵌入和序列模型(例如Transformer)。Python 编程技能: 使用Python 的经验,包括安装库、编写脚本和处理数据。
PyTorch Knowledge: 对PyTorch 的基本了解,因为TextAttack 通常与基于PyTorch 的模型集成。
TextAttack 安装: 使用pip install textattack 在您的环境中安装TextAttack 框架。确保安装了NumPy、pandas 和PyTorch 等依赖项。
数据集熟悉度: 了解如何处理数据集,例如Hugging Face 数据集库中提供的数据集。
TextAttack 的关键组件
TextAttack 通过将NLP 攻击分解为四个组件来统一对抗性攻击方法:目标函数: 攻击的目标由目标函数定义,其中可以包括更改模型的预测或欺骗模型犯特定错误。
约束集: 它们是攻击必须遵守的规则,例如限制单词数量或保证所做的所有修改在语法上都是准确的。
Transformation: 转换确定如何修改输入文本以生成对抗性示例。例如,用同义词替换单词或插入/删除单词。
搜索方法: 该组件确定攻击如何探索可能修改的空间以找到最有效的对抗示例,例如使用基于梯度的方法或随机搜索算法。
TextAttack的主要特点
正如我们上面提到的,TextAttack 模块化设计的核心是四个主要组件。
图片来源
在图中,攻击模块部分显示了TextAttack 重新实现文献中的攻击的能力。本节提到我们可以使用16 篇论文和预先构建的攻击方案。
该图显示了如何使用TextAttack 以两种方式构建攻击:创建新攻击和对现有攻击进行基准测试。用户可以通过组合新的和现有的组件来创建新的对抗策略。
TextAttack 拥有超过82 个预训练模型,因此研究人员可以针对标准模型测试他们的新攻击。这使他们能够将他们的结果与之前的工作进行比较。
该图显示了attack:数据增强和对抗训练的两种方法。通过使用增强器模块,用户模型可以通过生成新样本来增强现有的训练数据集来改进。通过TextAttack 的训练流程,我们可以创建对抗性示例并将其输入训练过程中以改进我们的模型。
TextAttack 的预训练模型和数据集
TextAttack 的预训练模型包括单词级LSTM 和CNN 模块以及基于Transformer 的BERT 变体。这些模型已经在HuggingFace 提供的各种数据集上进行了预训练。TextAttack 与NLP 库的集成可以自动加载相应的预训练模型以用于测试和验证数据集。虽然许多先前的文献都集中在分类和蕴涵上,但TextAttack 的一系列预训练模型为研究提供了新的途径。这使得研究人员能够深入研究所有GLUE 任务的模型稳健性。
对抗性训练
TextAttack 可以创建新的对抗性示例训练集。该过程涉及几个步骤:初始训练: 该模型在干净的训练集上训练了多个时期。
对抗性示例生成: 攻击会为每个输入生成对抗性版本。
数据集替换: 此过程涉及用扰动变量替换原始数据集。
定期重新生成: 根据模型当前的弱点定期重新生成对抗数据集。
下表说明了标准LSTM 分类器针对_TextAtt_ack 中使用的各种攻击配方进行和不进行对抗性训练的准确性。
图片来源
它显示了LSTM 模型针对deepwordbug、textfooler、pruthi、hotflip 和bae 攻击的性能与其在干净训练集上的基线Carlini 得分的比较。该表比较了有攻击和没有攻击的准确性,分别评估了模型在20 和75 个epoch 时针对deepwordbug 的鲁棒性。它还评估了模型在20 个时期对textfooler 的脆弱性。
使用攻击配方对现有攻击进行基准测试
TextAttack 允许采用模块化结构将多个过去的研究攻击组合到一个框架中。这是通过添加一两个新组件来实现的,我们在创建新的攻击计划时获得了更大的灵活性和生产力。攻击配方是一组预定义的步骤和配置,用于为NLP 模型生成对抗性示例。每个攻击配方都有四个主要组成部分(目标函数、约束、转换、搜索方法)
攻击秘诀是从最新研究中提炼出来的最佳实践和技术。他们加速了对抗性例子的产生。这些帮助研究人员和从业者的工作使我们能够实施复杂的攻击策略,而无需了解所有底层细节。我们在下图中说明了一些常见的攻击类型:
对抗性攻击概述
实际用例:情感分析
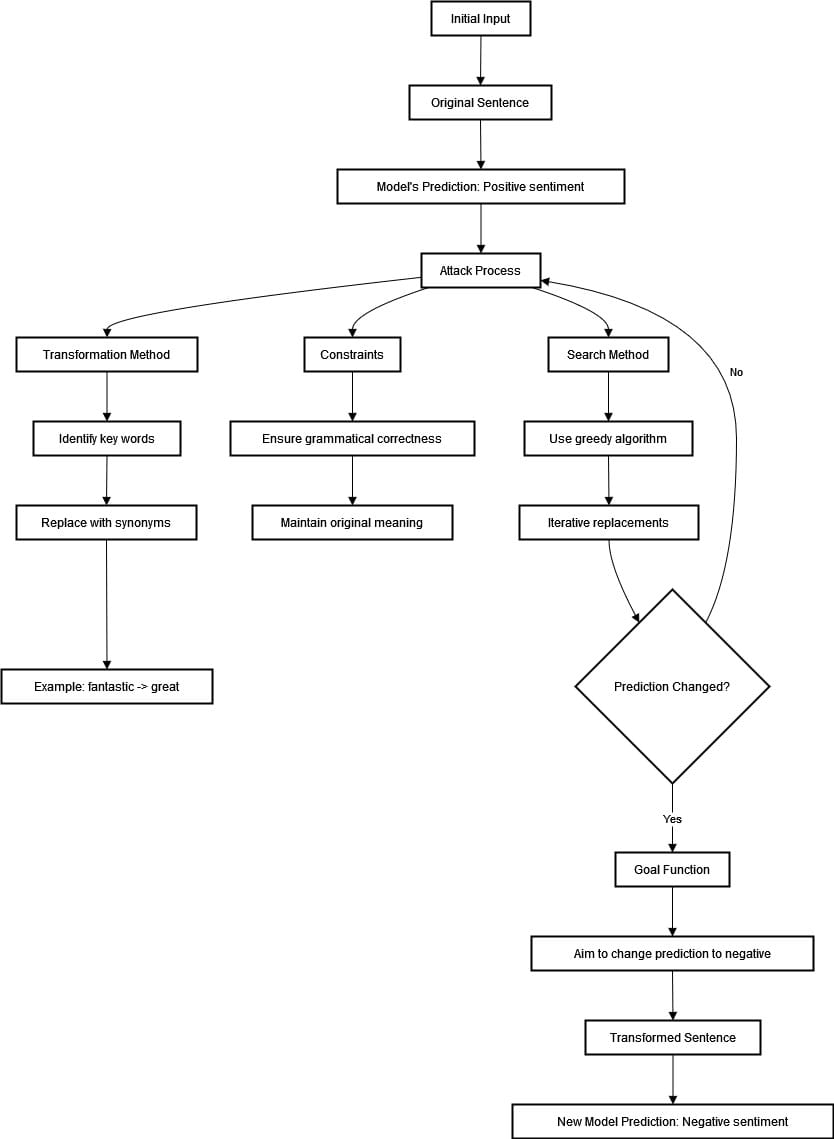
假设我们有一个情感分析模型,可以将电影评论分为正面或负面类别。我们想使用textfooler 攻击配方来测试该模型的强度和鲁棒性。给出的输入是“这部电影很棒”,模型预测了积极的情绪。让我们看看下图中的过程。
我们的情感分析模型的对抗性攻击过程
要开始攻击过程,我们必须在声明中找到与积极情绪相关的重要单词。例如,可以使用WordNet 数据库将“fantastic”替换为同义词。
我们希望尽可能保留语法正确性和原始含义。我们在贪婪算法中使用迭代方法,在每次替换时检查模型的预测。
该过程持续进行,直到无法进行更多替代来实现所需结果或预测发生变化。通过将“棒极了”这个词替换为“很棒”等等价词,可以成功地攻击该模型,从而将情绪从积极转变为消极。
在这种情况下,最初的陈述“这部电影很棒”已更改为“这部电影很棒”,因为我们可以看到模型的预测已从正面变为负面。这是模型中存在漏洞的证据。
textfooler 是一个聪明的方案,旨在暴露情感分析模型的缺陷。该技术可以通过用同义词替换关键字来显着影响模型预测,同时保持上下文连贯性。这迫使我们优先考虑培训和评估框架,以最大限度地减少此类对抗性攻击的脆弱性。
使用 TextAttack 的 AttackedText 对象增强对抗性 NLP 攻击
使用传统NLP 攻击实现时,对标记化文本进行更改通常会导致大写和分词问题。标记化涉及将文本分解为单独的单词或标记,这可能会导致其初始大写字母和单词之间的边界中断。标记化“这部电影太棒了!”可能会导致“这个”、“电影”、“是”或“太棒了!”省略开头的大写字母。这使得转型变得更加困难。这种担忧可能会削弱


