


8
月
在社区成长 8 月
LEVEL 50
100 XP
深度学习安全AI/ML
 作者:Adrien Payong
AI顾问和技术作家
 目录热门话题
他们在文本分类、自然语言推理、情感分析和机器翻译等任务中表现出色。通过利用大量数据,这些深度学习框架正在彻底改变我们处理和理解语言的方式。他们在无数的NLP 任务中激发了高性能成果。
尽管自然语言处理(NLP)领域取得了进步,但仍然存在一些悬而未决的问题,包括对抗性攻击的风险。通常,此类攻击涉及向数据中注入难以察觉的小扰动,但足以欺骗NLP 模型并扭曲其结果。
与图像等连续数据相比,自然语言处理中存在的对抗性攻击可能会带来挑战。这主要是由于基于文本的数据的离散性质,这使得对抗性示例的有效生成更加复杂。
已经建立了许多机制来防御攻击。本文概述了对抗机制,这些机制可分为三大类: 基于对抗训练的方法、基于扰动控制的方法和基于认证的方法。
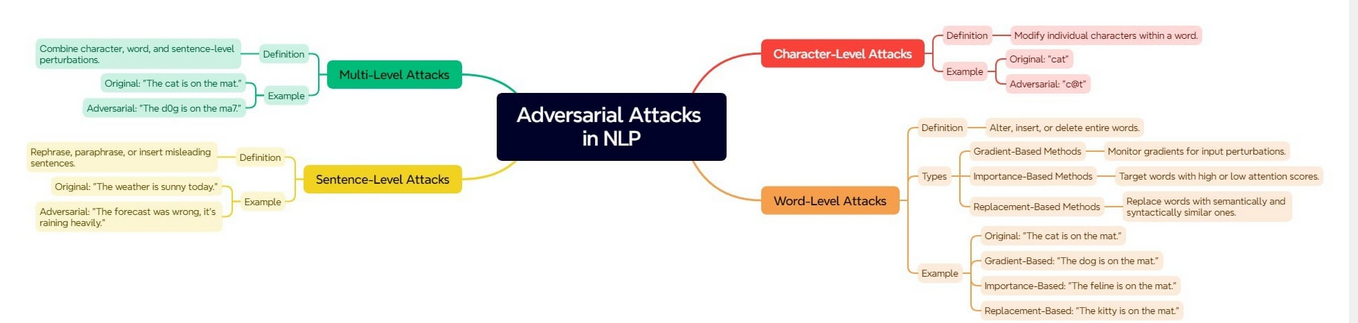
NLP 中的攻击类型
自然语言处理(NLP)领域的对抗性攻击有可能影响不同的文本粒度,从单个字符到整个句子。他们还可能同时利用多个级别进行更复杂的攻击。
对手经常利用基于梯度的方法来检测最熟练的扰动。通过计算损失函数相对于输入的梯度,攻击者可以推断出对输入的哪些修改会对模型输出产生重大影响。
由于人们对该模型的广泛熟悉,白盒攻击往往会在欺骗模型方面取得巨大成功。
这种攻击者的本质受到限制,这使得黑盒攻击变得更加复杂。观察到的查询是他们被迫推断模型固有行为的唯一手段。
通常,攻击者会参与训练代理模型的过程,该模型模拟其预期目标所表现出的操作模式。该替代模型随后被用来制定对抗性质的实例。
语义完整性: 确保对抗性示例在语义上与原始文本相似。
语言多样性: 保持文本的自然性和多样性以逃避检测。
模型Robustness: 克服高级NLP 模型的防御。
评估指标: 缺乏有效的指标来衡量对抗的成功。
攻击可转移性: 实现跨不同模型的攻击可转移性。
计算资源: 生成高质量对抗性示例的计算要求很高。
人类直觉和创造力: 利用人类创造力生成现实的对抗性示例。
这些挑战强调需要继续进行研究和开发工作,以推进自然语言处理中的对抗性攻击领域。他们还强调了提高NLP 系统抵御此类攻击的能力的重要性。
例如,一些方法可能涉及将噪声引入词嵌入或实现同义词替换作为生成对抗性示例的手段。有不同的方法来执行基于数据增强的对抗训练。这些包括字级数据增强、基于串联的数据增强和基于生成的数据增强。
例如,短语“这部电影很棒”可以转换为“这部电影很棒”。使用这些增强的数据集进行训练可以使模型更好地泛化,并减少其针对输入扰动的脆弱性。
基于生成的数据增强使用生成模型生成新的对抗性示例。使用生成对抗网络(GAN),可以创建语法和语义正确的对抗文本。然后将这些生成的示例合并到训练集中,以增强对抗场景的多样性。
AI顾问和技术作家
简介
由于采用了最先进的深度学习技术,自然语言处理或NLP 领域已经发生了鼓舞人心的突破。这些算法以指数方式提高了NLP 模型的内部灵活性,超出了人类的能力。他们在文本分类、自然语言推理、情感分析和机器翻译等任务中表现出色。通过利用大量数据,这些深度学习框架正在彻底改变我们处理和理解语言的方式。他们在无数的NLP 任务中激发了高性能成果。
尽管自然语言处理(NLP)领域取得了进步,但仍然存在一些悬而未决的问题,包括对抗性攻击的风险。通常,此类攻击涉及向数据中注入难以察觉的小扰动,但足以欺骗NLP 模型并扭曲其结果。
与图像等连续数据相比,自然语言处理中存在的对抗性攻击可能会带来挑战。这主要是由于基于文本的数据的离散性质,这使得对抗性示例的有效生成更加复杂。
已经建立了许多机制来防御攻击。本文概述了对抗机制,这些机制可分为三大类: 基于对抗训练的方法、基于扰动控制的方法和基于认证的方法。
先决条件
熟悉基本的NLP 概念(标记化、嵌入、变压器)、对抗性攻击(例如扰动、释义)以及NLP 模型的评估指标。对PyTorch 或TensorFlow 等深度学习框架的一些了解很有帮助。NLP 中的对抗性攻击概述
了解不同类型的攻击对于创建强大的防御并增强对NLP 模型可靠性的信心至关重要。攻击类型
下图描述了不同类型的攻击。
NLP 中的攻击类型
自然语言处理(NLP)领域的对抗性攻击有可能影响不同的文本粒度,从单个字符到整个句子。他们还可能同时利用多个级别进行更复杂的攻击。
黑盒与白盒攻击
NLP 模型上的对抗性攻击的分类通常可分为两种类型(黑盒攻击和白盒攻击),这取决于攻击者对模型参数的访问级别。了解这些类别对于建立防御机制至关重要。白盒攻击
白盒攻击要求攻击者能够不受限制地控制与特定模型关联的所有参数。这些因素包括但不限于架构、梯度和权重——授予有关内部操作的广泛知识。通过深入了解上述机制,攻击者可以高效、精确地执行有针对性的对抗措施。对手经常利用基于梯度的方法来检测最熟练的扰动。通过计算损失函数相对于输入的梯度,攻击者可以推断出对输入的哪些修改会对模型输出产生重大影响。
由于人们对该模型的广泛熟悉,白盒攻击往往会在欺骗模型方面取得巨大成功。
黑匣子攻击
在黑盒攻击的范例中,攻击者对给定模型的参数和架构的访问仍然受到限制。然而,它们与模型的通信仅限于输入,模型通过输出响应输入。这种攻击者的本质受到限制,这使得黑盒攻击变得更加复杂。观察到的查询是他们被迫推断模型固有行为的唯一手段。
通常,攻击者会参与训练代理模型的过程,该模型模拟其预期目标所表现出的操作模式。该替代模型随后被用来制定对抗性质的实例。
生成 NLP 对抗示例的挑战
自然语言处理(NLP) 中有效对抗性示例的生成是一项多方面的工作,带来了固有的挑战。这些挑战源于语言学、NLP 模型行为的复杂性以及与攻击方法相关的约束:语义完整性: 确保对抗性示例在语义上与原始文本相似。
语言多样性: 保持文本的自然性和多样性以逃避检测。
模型Robustness: 克服高级NLP 模型的防御。
评估指标: 缺乏有效的指标来衡量对抗的成功。
攻击可转移性: 实现跨不同模型的攻击可转移性。
计算资源: 生成高质量对抗性示例的计算要求很高。
人类直觉和创造力: 利用人类创造力生成现实的对抗性示例。
这些挑战强调需要继续进行研究和开发工作,以推进自然语言处理中的对抗性攻击领域。他们还强调了提高NLP 系统抵御此类攻击的能力的重要性。
基于对抗训练的防御方法
基于对抗训练的防御的主要目标是增强模型的弹性。它是通过在训练阶段对其进行对抗性示例来实现的。此外,它还涉及将对抗性损失整合到总体训练目标中。基于数据增强的方法
基于数据增强的方法需要创建对抗性示例并将其合并到训练数据集中。该策略有助于开发模型管理扰动输入的能力,使其能够抵御来自对手的具有弹性的攻击。例如,一些方法可能涉及将噪声引入词嵌入或实现同义词替换作为生成对抗性示例的手段。有不同的方法来执行基于数据增强的对抗训练。这些包括字级数据增强、基于串联的数据增强和基于生成的数据增强。
字级数据增强
在单词级别,可以通过直接对输入文本的单词应用一些扰动来执行文本数据增强。这可以通过替换、添加、省略或重新定位句子或文档中的单词来实现。通过这些扰动,模型被训练来检测和解决发生的对抗性变化。例如,短语“这部电影很棒”可以转换为“这部电影很棒”。使用这些增强的数据集进行训练可以使模型更好地泛化,并减少其针对输入扰动的脆弱性。
基于串联和基于生成的数据增强
在基于串联的方法中,新的句子或短语被添加到原始文本中。该方法可以通过连接可能改变模型预测的其他信息来注入对抗性示例。例如,在图像分类场景中,可以通过向输入文本添加误导性句子来创建对抗性示例。基于生成的数据增强使用生成模型生成新的对抗性示例。使用生成对抗网络(GAN),可以创建语法和语义正确的对抗文本。然后将这些生成的示例合并到训练集中,以增强对抗场景的多样性。


