


8
月
在社区成长 8 月
LEVEL 50
100 XP
物体检测计算机视觉AI/ML
 作者:Shaoni Mukherjee
技术撰稿人
 目录热门话题
Meta 的分段任意模型(SAM) 可以立即识别图像中的对象并将它们分开,而无需针对特定图像进行训练。它就像一个数字魔术师,只需挥动虚拟魔杖就能理解图像中的每个对象。继llama 3.1 成功发布后,Meta 于7 月29 日发布了SAM 2,这是一个用于图像和视频实时分割对象的统一模型,取得了最先进的性能。
SAM 2 提供了大量的实际应用程序。例如,其输出可以与生成视频模型集成,以创建创新的视频效果并释放新的创意可能性。此外,SAM 2 可以增强视觉数据注释工具,加快更先进计算机视觉系统的开发。
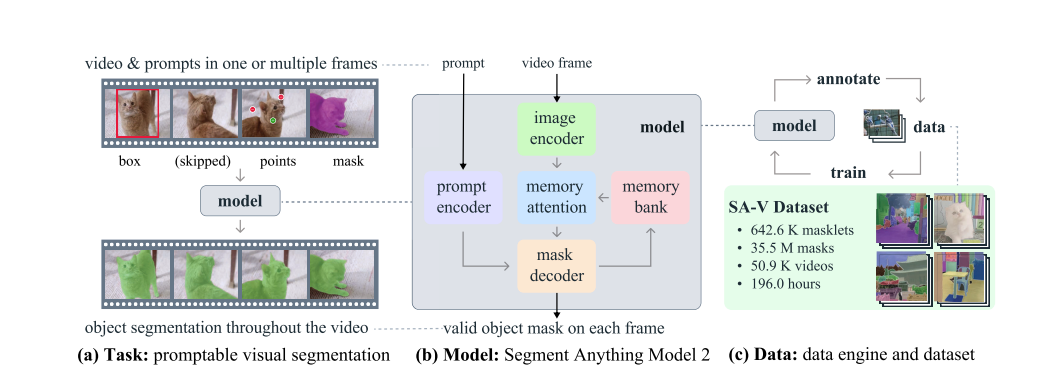
SAM 2 涉及任务、模型和数据(图片来源)
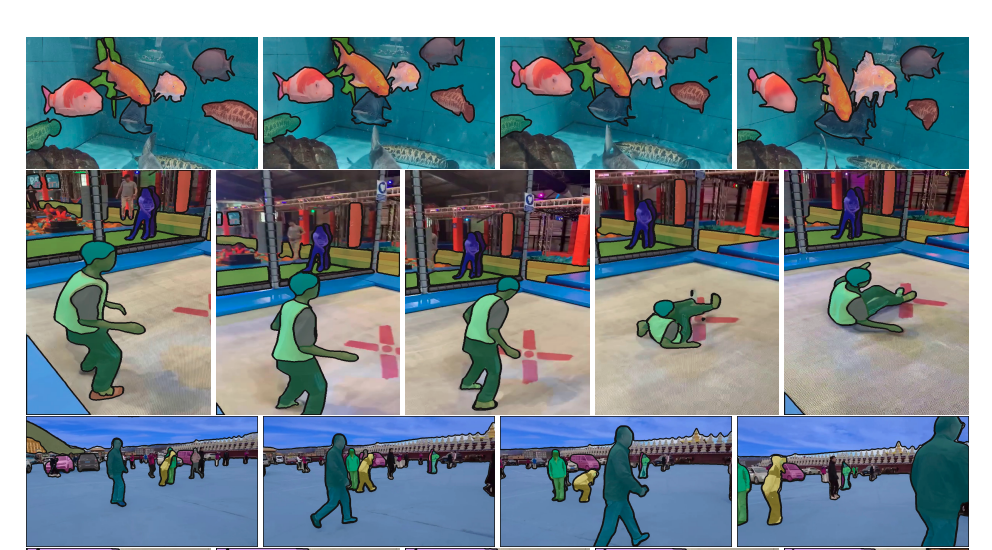
来自带有masklet 的SA-V 数据集的示例视频(图像源)
与SAM 不同,SAM 2 解码器使用的帧嵌入不是直接从图像编码器获取的。相反,它以对过去预测的记忆和先前帧的提示为条件,包括来自相对于当前帧的“未来”帧的提示。内存编码器根据当前预测创建这些内存,并将它们存储在内存库中以供将来使用。被传递到掩码解码器。
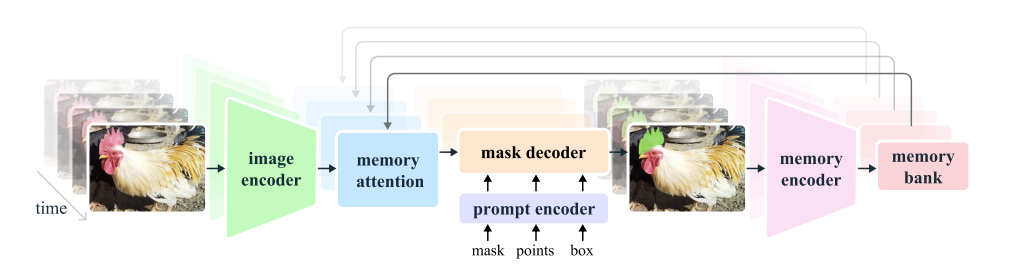
SAM 2 架构。在每一帧中,分割预测基于当前提示和任何先前观察到的记忆。视频以流式处理方式进行处理,图像编码器每次分析一帧,并交叉引用较早帧中目标对象的记忆。掩模解码器也可以使用输入提示来预测帧的分割掩模。最后,内存编码器对预测和图像编码器嵌入(图中未显示)进行转换,以便在未来的帧中使用。 (图片来源)
以下是图像: 中存在的不同组件和流程的简化说明
工作原理: 整个视频仅运行一次,从而提高效率。 MAE 和Hiera 提取不同细节级别的特征,以帮助准确分割。
它是如何工作的:它使用一系列变压器块来处理当前帧的特征,将它们与过去帧的记忆进行比较,并根据两者更新分割。这有助于处理对象可能随时间移动或变化的复杂场景。
Mask Decoder: 与提示编码器配合生成准确的掩模。如果提示不清楚,它会预测多个可能的蒙版,并根据与对象的重叠情况选择最佳蒙版。
记忆库: 它存储过去帧和提示的记忆。这包括最近帧和提示的队列以及高级对象信息。它帮助模型跟踪对象随时间的变化和运动。
工作原理: 在训练期间,模型学习通过与帧序列交互来预测分割掩模。它接收诸如真实掩码、点击或边界框之类的提示来指导其预测。这有助于模型擅长响应各种类型的输入并提高其分割准确性。
总体而言,该模型旨在高效处理长视频,记住过去帧中的信息,并根据交互式提示准确分割对象。
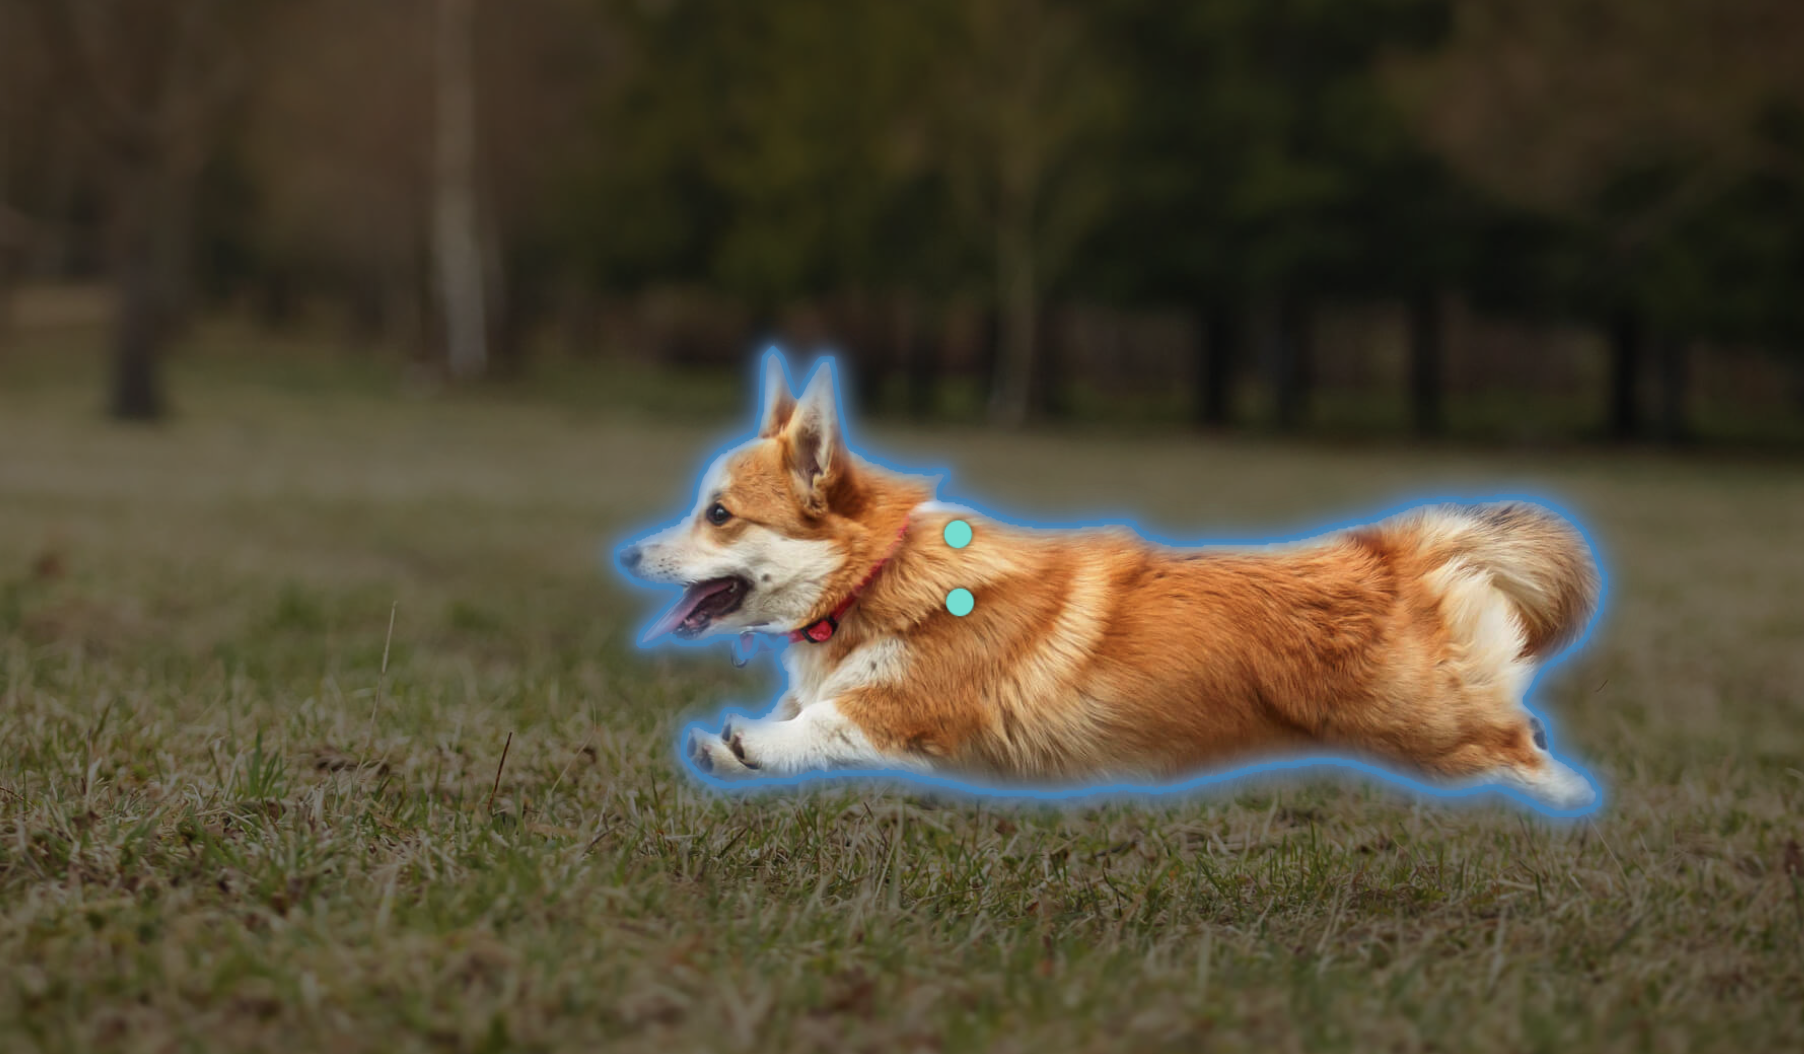
SAM 2 对象分割
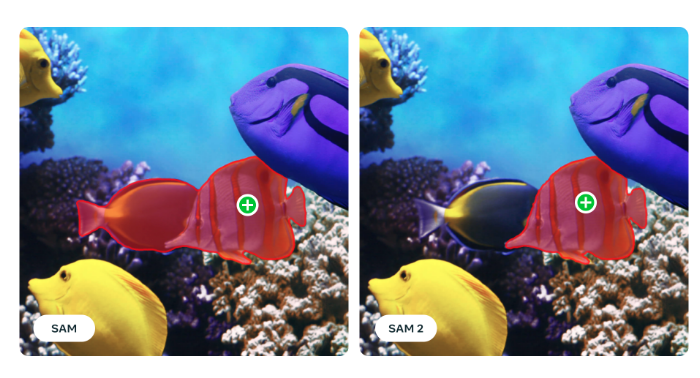
SAM 与SAM 2 的比较
SAM 2 在交互式视频分割方面显着优于以前的方法,在17 个零样本视频数据集上取得了优异的结果,并且所需的人工交互减少了约三倍。它在零样本基准测试套件中超越了SAM,速度快了六倍,并且在DAVIS、MOSE、LVOS 和YouTube-VOS 等既定视频对象分割基准测试中表现出色。 SAM 2 的实时推理速度约为每秒44 帧,比使用SAM 进行的手动每帧注释快8.4 倍。
!git克隆https://github.com/facebookresearch/segment-anything-2.git
# 移动到文件夹
cd 段-任意-2
# 安装必要的要求
!pip install -e 。
要使用SAM 2 预测器并运行示例笔记本,需要jupyter 和matplotlib,并且可以通过: 安装
pip install -e '.[演示]'
下载检查点
裁谈会检查点
./download_ckpts.sh
进口火炬
从sam2.build_sam 导入build_sam2
从sam2.sam2_image_predictor 导入SAM2ImagePredictor
检查点='./checkpoints/sam2_hiera_large.pt'
model_cfg='sam2_hiera_l.yaml'
预测器=SAM2ImagePredic
技术撰稿人
简介
得益于YOLO和SAM等技术,手机或计算机可以理解图像对象的时代已经到来。Meta 的分段任意模型(SAM) 可以立即识别图像中的对象并将它们分开,而无需针对特定图像进行训练。它就像一个数字魔术师,只需挥动虚拟魔杖就能理解图像中的每个对象。继llama 3.1 成功发布后,Meta 于7 月29 日发布了SAM 2,这是一个用于图像和视频实时分割对象的统一模型,取得了最先进的性能。
SAM 2 提供了大量的实际应用程序。例如,其输出可以与生成视频模型集成,以创建创新的视频效果并释放新的创意可能性。此外,SAM 2 可以增强视觉数据注释工具,加快更先进计算机视觉系统的开发。
SAM 2 涉及任务、模型和数据(图片来源)
什么是 SAM 中的图像分割?
Segment Anything (SAM) 引入了图像分割任务,其中根据输入提示生成分割掩模,例如指示感兴趣对象的边界框或点。 SAM 在SA-1B 数据集上进行训练,支持零样本分割和灵活的提示,使其适合各种应用。最近的进步提高了SAM 的质量和效率。 HQ-SAM 使用高质量输出令牌和细粒度掩模训练来提高输出质量。提高效率以适应更广泛的实际应用的努力包括EfficientSAM、MobileSAM 和FastSAM。 SAM 的成功导致其在医学成像、遥感、运动分割和伪装目标检测等领域的应用。使用的数据集
已经开发了许多数据集来支持视频对象分割(VOS)任务。早期的数据集具有高质量的注释,但对于训练深度学习模型来说太小。 YouTube-VOS 是第一个大规模VOS 数据集,涵盖4,000 个基准视频的94 个对象类别。随着算法的改进和性能的稳定,研究人员通过关注遮挡、长视频、极端变换以及对象和场景的多样性来增加VOS 任务的难度。当前的视频分割数据集缺乏“分割视频中的任何内容”所需的广度,因为它们的注释通常涵盖特定类别内的整个对象,例如人、车辆和动物。相比之下,最近引入的SA-V 数据集不仅关注整个对象,还广泛关注对象部分,包含多一个数量级的掩模。收集的SA-V 数据集包含50.9K 视频和642.6K masklet。
来自带有masklet 的SA-V 数据集的示例视频(图像源)
模型架构
该模型扩展了SAM,使其能够处理视频和图像。 SAM 2 可以在各个帧上使用点、框和遮罩提示来定义整个视频中要分割的对象的空间范围。处理图像时,该模型的运行方式与SAM 类似。轻量级、可提示的掩码解码器采用帧的嵌入和任何提示来生成分段掩码。可以迭代地添加提示来完善蒙版。与SAM 不同,SAM 2 解码器使用的帧嵌入不是直接从图像编码器获取的。相反,它以对过去预测的记忆和先前帧的提示为条件,包括来自相对于当前帧的“未来”帧的提示。内存编码器根据当前预测创建这些内存,并将它们存储在内存库中以供将来使用。被传递到掩码解码器。
SAM 2 架构。在每一帧中,分割预测基于当前提示和任何先前观察到的记忆。视频以流式处理方式进行处理,图像编码器每次分析一帧,并交叉引用较早帧中目标对象的记忆。掩模解码器也可以使用输入提示来预测帧的分割掩模。最后,内存编码器对预测和图像编码器嵌入(图中未显示)进行转换,以便在未来的帧中使用。 (图片来源)
以下是图像: 中存在的不同组件和流程的简化说明
图像编码器
目的: 图像编码器处理每个视频帧以创建特征嵌入,这些特征嵌入本质上是每个帧中视觉信息的压缩表示。工作原理: 整个视频仅运行一次,从而提高效率。 MAE 和Hiera 提取不同细节级别的特征,以帮助准确分割。
记忆注意力
目的: 记忆注意力有助于模型使用先前帧的信息和任何新提示来改进当前帧的分割。它是如何工作的:它使用一系列变压器块来处理当前帧的特征,将它们与过去帧的记忆进行比较,并根据两者更新分割。这有助于处理对象可能随时间移动或变化的复杂场景。
提示编码器和掩码解码器
提示编码器: 与SAM 类似,它需要输入提示(如点击或框)来定义要分割帧的哪个部分。它使用这些提示来细化分段。Mask Decoder: 与提示编码器配合生成准确的掩模。如果提示不清楚,它会预测多个可能的蒙版,并根据与对象的重叠情况选择最佳蒙版。
内存编码器和内存库
内存编码器: 该组件通过总结和组合来自先前掩模和当前帧的信息来创建过去帧的记忆。这有助于模型记住和使用视频前面的信息。记忆库: 它存储过去帧和提示的记忆。这包括最近帧和提示的队列以及高级对象信息。它帮助模型跟踪对象随时间的变化和运动。
培训
目的: 该模型经过训练,可以使用图像和视频处理交互式提示和分割任务。工作原理: 在训练期间,模型学习通过与帧序列交互来预测分割掩模。它接收诸如真实掩码、点击或边界框之类的提示来指导其预测。这有助于模型擅长响应各种类型的输入并提高其分割准确性。
总体而言,该模型旨在高效处理长视频,记住过去帧中的信息,并根据交互式提示准确分割对象。
SAM 2 性能
SAM 2 对象分割
SAM 与SAM 2 的比较
SAM 2 在交互式视频分割方面显着优于以前的方法,在17 个零样本视频数据集上取得了优异的结果,并且所需的人工交互减少了约三倍。它在零样本基准测试套件中超越了SAM,速度快了六倍,并且在DAVIS、MOSE、LVOS 和YouTube-VOS 等既定视频对象分割基准测试中表现出色。 SAM 2 的实时推理速度约为每秒44 帧,比使用SAM 进行的手动每帧注释快8.4 倍。
如何安装 SAM 2?
# 克隆仓库!git克隆https://github.com/facebookresearch/segment-anything-2.git
# 移动到文件夹
cd 段-任意-2
# 安装必要的要求
!pip install -e 。
要使用SAM 2 预测器并运行示例笔记本,需要jupyter 和matplotlib,并且可以通过: 安装
pip install -e '.[演示]'
下载检查点
裁谈会检查点
./download_ckpts.sh
如何使用 SAM 2?
图像预测
SAM 2 可用于静态图像来分割对象。 SAM 2 为这些用例提供了与SAM 类似的图像预测API。 SAM2ImagePredictor 类提供了一个用户友好的图像提示界面。进口火炬
从sam2.build_sam 导入build_sam2
从sam2.sam2_image_predictor 导入SAM2ImagePredictor
检查点='./checkpoints/sam2_hiera_large.pt'
model_cfg='sam2_hiera_l.yaml'
预测器=SAM2ImagePredic


