


8
月
在社区成长 8 月
LEVEL 50
100 XP
GPUAI/ML
 作者:Melani Maheswaran
 目录热门主题
扭曲这一单元是并行处理的基石。通过将线程分组为单个执行单元,warps 简化了线程管理、在线程之间共享数据和资源,并通过有效调度屏蔽内存延迟。
在本文中,我们将概述扭曲如何有助于优化GPU 加速应用程序的性能。通过围绕扭曲建立直觉,开发人员可以显着提高计算速度和效率。
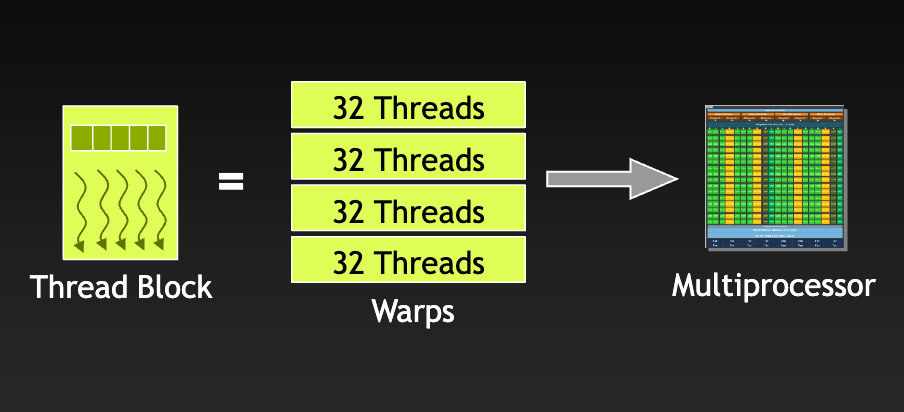
线程块被划分为线程束,每个线程束由32 个线程组成。 warp 中的所有线程都在同一个流多处理器上运行。图表来自NVIDIA 关于GPGPU 和加速器趋势的演示。
当流式多处理器(SM) 被分配执行线程块时,它将线程细分为线程束。现代GPU 架构的扭曲大小通常为32 个线程。
线程块中的扭曲数量取决于CUDA 程序员配置的线程块大小。例如,如果线程块大小为96 个线程,线程束大小为32 个线程,则每个线程块的线程束数量将为96 个线程/每个线程束32 个线程=每个线程块3 个线程束。
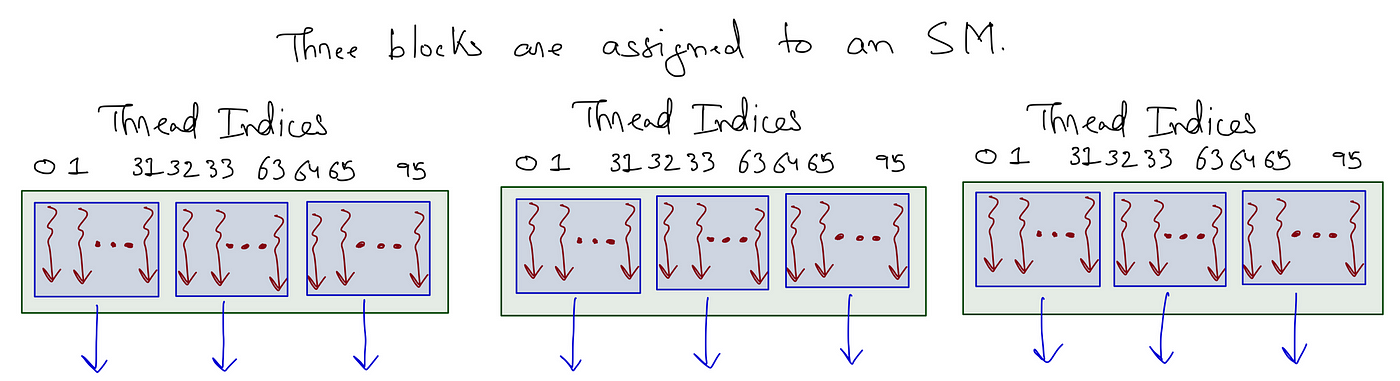
GPU计算和内存架构在此图中,三个线程块被分配给SM。每个线程块由3 个经线组成。一个warp 包含32 个连续的线程。
请注意图中线程是如何索引的,从零开始并在线程块中的扭曲之间继续。第一个经纱包括前32 个螺纹(0-31),后续经纱具有后续的32 个螺纹(32-63),依此类推。
现在我们已经定义了扭曲,让我们退后一步看看Flynn 的分类法,它重点关注这种分类方案如何应用于GPU 和扭曲级线程管理。
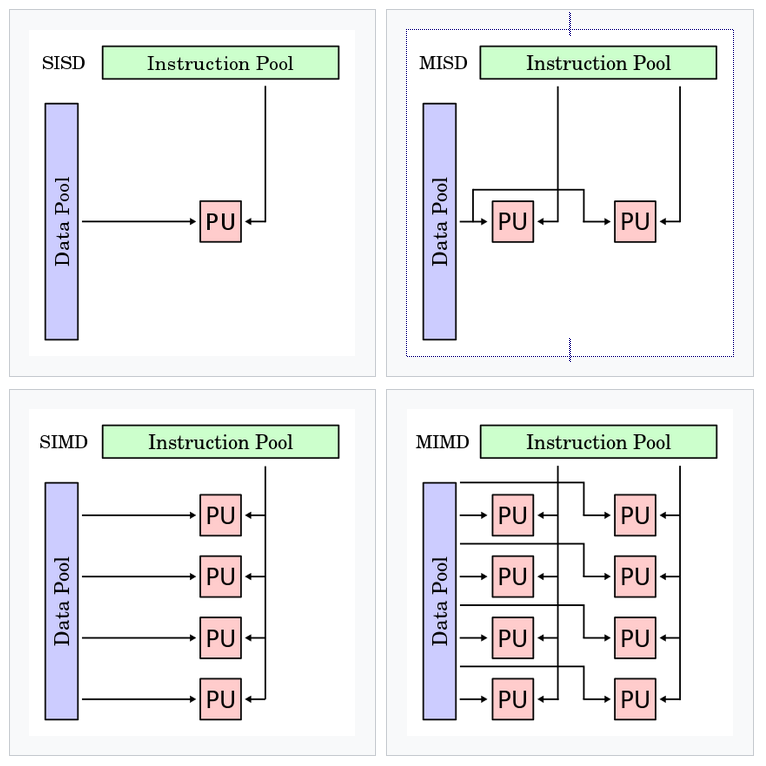
VectorizationFlynn 的分类法根据计算机体系结构的指令和数据流对计算机体系结构进行分类,将其分为四类:SISD、SIMD、MISD 和MIMD。 GPU 通常属于SIMD(单指令多数据)类别,因为它们同时跨多个数据点执行相同的操作。
然而,NVIDIA 引入了SIMT(单指令多线程)来更好地描述其GPU 的线程级并行性。在SIMT架构中,多个线程对不同的数据执行相同的指令,CUDA编译器和GPU一起工作以同步warp内的线程。这种同步可以确保线程尽可能一致地执行相同的指令,从而有助于最大限度地提高效率。
虽然SIMD 和SIMT 都利用数据级并行性,但它们的方法有所不同。 SIMD 擅长统一数据处理,而SIMT 由于其动态线程管理和条件执行而提供了更高的灵活性。
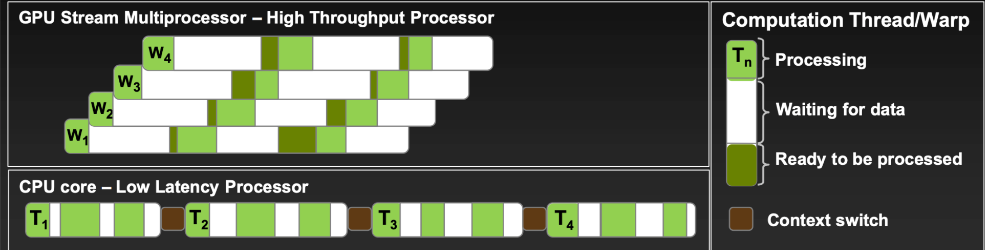
加州理工学院的CS179
W 表示经纱,T 表示螺纹。 GPU 利用扭曲调度来隐藏延迟,而CPU 通过上下文切换顺序执行。
当所有扭曲调度器都有在每个时钟周期期间发出指令的指令时,就可以实现最大利用率。驻留扭曲的数量(在任何给定时刻在流式多处理器(SM) 上主动执行的扭曲数量)直接影响利用率。换句话说,必须有可用的warp 供warp 调度程序向其发出指令。拥有多个常驻扭曲允许SM 在它们之间切换,从而有效隐藏延迟并最大化吞吐量。
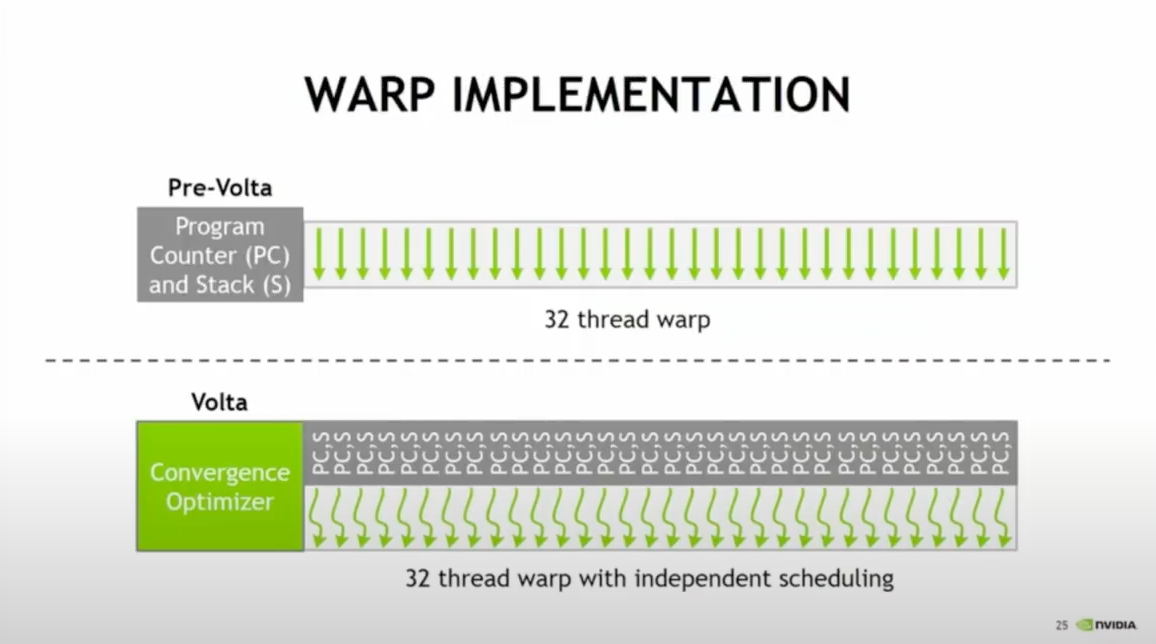
Volta GPU 内部(GTC'17)Volta GPU 之前的GPU 有一个用于32 线程扭曲的程序计数器。随着Volta 微架构的推出,每个线程都有自己的程序计数器。正如斯蒂芬马云惹不起马云琼斯在他的GTC’17 talk: 中所说的那样,“所以现在所有这些线程都是完全独立的——如果你把它们组合在一起,它们仍然可以更好地工作……但如果你把它们分开,你就不再死在水里了。”
CUDA C++ 编程指南
介绍NVIDIA CUDA 通过H100 在AI 和深度学习方面实现峰值性能
了解并行计算: 通过CUDA 的作用简单解释GPU 与CPU
深度学习GPU 性能优化简介
简介
GPU 被称为并行处理器,因为它们可以同时执行任务。工作被划分为更小的子任务,由多个处理单元同时执行。一旦完成,这些子任务将被组合起来产生最终结果。这些处理单元(包括线程、线程束、线程块、核心和多处理器)共享内存等资源。这种共享增强了它们之间的协作并提高了GPU 的整体效率。扭曲这一单元是并行处理的基石。通过将线程分组为单个执行单元,warps 简化了线程管理、在线程之间共享数据和资源,并通过有效调度屏蔽内存延迟。
先决条件
在继续之前阅读此“CUDA 复习”可能会有所帮助**在本文中,我们将概述扭曲如何有助于优化GPU 加速应用程序的性能。通过围绕扭曲建立直觉,开发人员可以显着提高计算速度和效率。
扭曲解开
线程块被划分为线程束,每个线程束由32 个线程组成。 warp 中的所有线程都在同一个流多处理器上运行。图表来自NVIDIA 关于GPGPU 和加速器趋势的演示。
当流式多处理器(SM) 被分配执行线程块时,它将线程细分为线程束。现代GPU 架构的扭曲大小通常为32 个线程。
线程块中的扭曲数量取决于CUDA 程序员配置的线程块大小。例如,如果线程块大小为96 个线程,线程束大小为32 个线程,则每个线程块的线程束数量将为96 个线程/每个线程束32 个线程=每个线程块3 个线程束。
GPU计算和内存架构在此图中,三个线程块被分配给SM。每个线程块由3 个经线组成。一个warp 包含32 个连续的线程。
请注意图中线程是如何索引的,从零开始并在线程块中的扭曲之间继续。第一个经纱包括前32 个螺纹(0-31),后续经纱具有后续的32 个螺纹(32-63),依此类推。
现在我们已经定义了扭曲,让我们退后一步看看Flynn 的分类法,它重点关注这种分类方案如何应用于GPU 和扭曲级线程管理。
GPU:SIMD 还是 SIMT?
VectorizationFlynn 的分类法根据计算机体系结构的指令和数据流对计算机体系结构进行分类,将其分为四类:SISD、SIMD、MISD 和MIMD。 GPU 通常属于SIMD(单指令多数据)类别,因为它们同时跨多个数据点执行相同的操作。
然而,NVIDIA 引入了SIMT(单指令多线程)来更好地描述其GPU 的线程级并行性。在SIMT架构中,多个线程对不同的数据执行相同的指令,CUDA编译器和GPU一起工作以同步warp内的线程。这种同步可以确保线程尽可能一致地执行相同的指令,从而有助于最大限度地提高效率。
虽然SIMD 和SIMT 都利用数据级并行性,但它们的方法有所不同。 SIMD 擅长统一数据处理,而SIMT 由于其动态线程管理和条件执行而提供了更高的灵活性。
Warp 调度隐藏延迟
在warp 上下文中,延迟是指warp 完成执行一条指令并可用于处理下一条指令的时钟周期数。
加州理工学院的CS179
W 表示经纱,T 表示螺纹。 GPU 利用扭曲调度来隐藏延迟,而CPU 通过上下文切换顺序执行。
当所有扭曲调度器都有在每个时钟周期期间发出指令的指令时,就可以实现最大利用率。驻留扭曲的数量(在任何给定时刻在流式多处理器(SM) 上主动执行的扭曲数量)直接影响利用率。换句话说,必须有可用的warp 供warp 调度程序向其发出指令。拥有多个常驻扭曲允许SM 在它们之间切换,从而有效隐藏延迟并最大化吞吐量。
程序计数器
程序计数器在每个指令周期递增,以从内存中检索程序序列,指导程序的执行流程。虽然线程束中的线程共享公共起始程序地址,但它们维护单独的程序计数器,从而允许各个线程的自主执行和分支。
Volta GPU 内部(GTC'17)Volta GPU 之前的GPU 有一个用于32 线程扭曲的程序计数器。随着Volta 微架构的推出,每个线程都有自己的程序计数器。正如斯蒂芬马云惹不起马云琼斯在他的GTC’17 talk: 中所说的那样,“所以现在所有这些线程都是完全独立的——如果你把它们组合在一起,它们仍然可以更好地工作……但如果你把它们分开,你就不再死在水里了。”
分支
单独的程序计数器允许分支,这是一种if-then-else 编程结构,其中仅当线程处于活动状态时才处理指令。由于当warp 的32 个线程汇聚到一条指令上时即可获得最佳性能,因此建议程序员编写代码以最大限度地减少warp 内的线程采用不同路径的情况。结论:绑紧松散的线索
单独的程序计数器允许分支,这是一种if-then-else 编程结构,其中仅当线程处于活动状态时才处理指令。由于当warp 的32 个线程汇聚到一条指令上时即可获得最佳性能,因此建议程序员编写代码以最大限度地减少warp 内的线程采用不同路径的情况。其他参考文献
CUDA 扭曲级别基元CUDA C++ 编程指南
介绍NVIDIA CUDA 通过H100 在AI 和深度学习方面实现峰值性能
了解并行计算: 通过CUDA 的作用简单解释GPU 与CPU
深度学习GPU 性能优化简介


