


8
月
在社区成长 8 月
LEVEL 50
100 XP
AI/ML
 作者:Adrien Payong
AI顾问和技术作家
 目录热门主题
最令人兴奋的工具之一是用于程序综合的开源法学硕士,它使每个人都能民主化编码。它被称为CODEGEN。 CODEGEN 由Salesforce 研究团队创建。在本文中,我们将探讨其功能以及对未来编程的影响。
编程语言: Python 或任何流行语言的基础知识。
语言模型: GPT 或基于Transformer 的架构的一般知识。
开源工具: 具有GitHub 存储库和基本代码部署经验。
CODEGEN 背后的创新之处在于全方位的培训。它利用自然语言和编程语言的大量文本语料库,使CODEGEN 能够深入理解人类语言和代码。这使得它能够在许多程序综合任务中表现出色。
CODEGEN 最令人印象深刻的方面是它在HumanEval 基准测试上的卓越表现,HumanEval 基准测试是零样本代码生成的事实上的标准评估。通过超越最先进的模型,CODEGEN 展示了无需微调特定任务即可生成高质量功能代码的可能性。
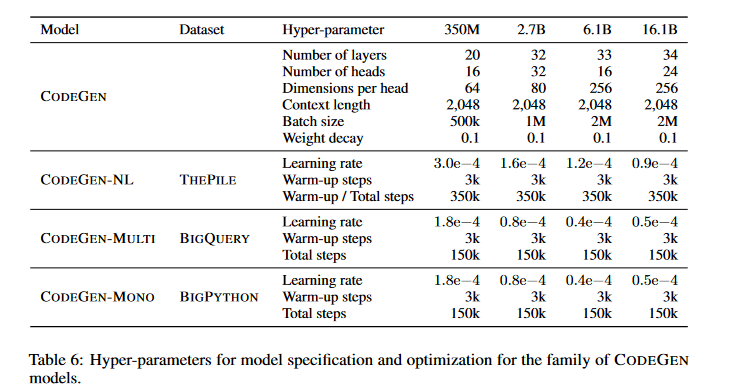
CODEGEN-NL: 最初在The Pile 上进行预训练,The Pile 是一个包含代码数据的大规模精选数据集。此阶段为自然语言理解奠定了基础。
CODEGEN-MULTI: 基于CODEGEN-NL,此阶段包括BigQuery 训练,BigQuery 是一个包含多种编程语言(包括C、C++、Go、Java、JavaScript 和Python)代码的数据集。
CODEGEN-MONO: 最后阶段通过在BigPython(来自GitHub 存储库的Python 代码数据集)上进行训练来重点关注Python 特定功能。
图片来源
凭借顺序训练方法的可能性,CodeGen 可以理解自然语言和多种编程语言。因此,它是与程序综合相关的任务的有效解决方案。
与仅根据单个提示生成完整片段的传统单轮技术形成鲜明对比,多轮合成促进了交互式开发。这使得能够生成更复杂和更准确的代码。
迭代细化: 多轮综合利用了用户机器协作的循环特征。根据用户的初始输入或高级描述,模型会生成初步的代码草案。然后,用户可以完善提示、请求修改并指定更正- 所有这些都会导致优化最终输出的渐进迭代。
基于对话的交互: 这种方法涉及一个促进对话的交互界面,用户和模型可以在其中活跃地交换想法。该模型提出了进一步澄清的询问,用户回复了更多详细信息;并且模型相应地更新代码。
上下文保留: 系统保留对话上下文的能力对于增强对用户意图的理解并有效地集成所做的任何修改至关重要。这对于处理需要多个步骤和调整的复杂编程任务至关重要。
Salesforce 研究团队意识到,通常需要一种更细致、分步的方法,将复杂的问题分解为小的、模块化的子问题。
为了研究这个概念,研究人员开发了多轮编程基准(MTPB)。它是一个综合数据集,由115 个需要多轮程序综合的不同问题集组成。通过评估CODEGEN 在该基准测试中的性能,他们能够证明多轮方法相对于单轮方法的显着优势。
多轮编程综合彻底改变了这一过程。它将任务分成更小的步骤,以便随着时间的推移进行改进。例如,如果我们想对x 和y 执行线性回归,程序将首先设置基本结构,例如导入库和定义变量,然后再完成任务。
用户将提供更多提示,例如“用数据拟合模型并打印系数”,然后他可以说“预测一组新的x 的值并绘制结果”。这有助于确保任务的每个部分都得到正确处理,并且可以根据用户的反馈进行更改。下图说明了线性回归任务的单轮和多轮示例。
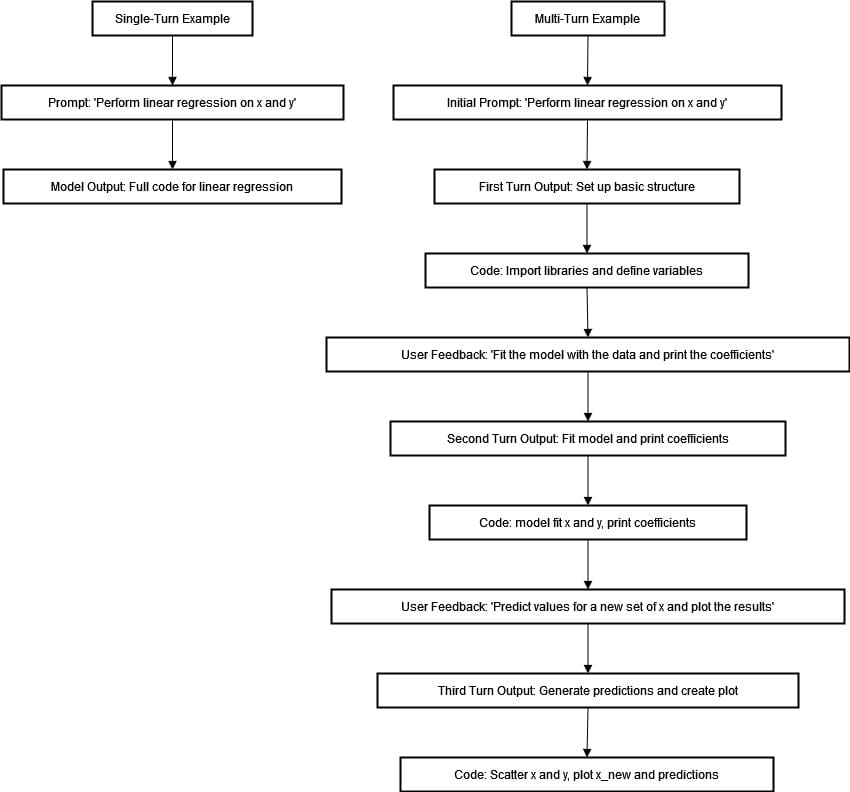
多轮编程综合:步执行线性回归任务
使用多匝有很多好处。它可以帮助我们更准确地控制编码过程,因为每个过程都专注于特定的任务,从而减少错误。在整个过程中获得用户的反馈可以进行调整,以更好地满足他们的需求和偏好。
上面的流程图捕捉到了在建立线性回归模型时单轮编程综合和多轮编程综合之间存在的显着差异。当使用前一种方法时,用户只需提示:“对x和y执行线性回归”,渴望立即生成完整的代码。然而,事实证明,这种方法在解决需要理解和迭代细化的复杂编码挑战方面存在局限性。
在多轮示例中,我们采取迭代步骤来完成一个过程。用户从提示开始,获得结构化响应,帮助建立基本框架,如必要的库和变量。随后的每次交互都涉及反馈,以指导模型拟合数据、打印系数、预测新值和创建可视化。
以下是如何将CODEGEN 与Hugging Face Transformers 库结合使用的示例:
进口火炬
从变压器导入AutoTokenizer、AutoModelForCausalLM
tokenizer=AutoTokenizer.from_pretrained('Salesforce/codegen-2B-mono')
模型=AutoModelForCausalLM.from_pretrained('Salesforce/codegen-2B-mono')
input=tokenizer('# 该函数打印hello world', return_tensors='pt')
样本=model.generate(__inputs, max_length=128)
打印(tokenizer.decode(样本[0],truncate_before_pattern=[r'
^#', '^'''', '
']))
输出:
AI顾问和技术作家
简介
随着大型语言模型(LLM) 的兴起,我们对许多任务的思考和处理方式有所不同,从自然语言处理和文本生成到编程。从OpenAI的GPT-3和GPT-4到Anthropic Claude、Google的PaLM、Apple的当然,我们正处于后LLM时代。最令人兴奋的工具之一是用于程序综合的开源法学硕士,它使每个人都能民主化编码。它被称为CODEGEN。 CODEGEN 由Salesforce 研究团队创建。在本文中,我们将探讨其功能以及对未来编程的影响。
先决条件
了解本文中的概念,熟悉:编程语言: Python 或任何流行语言的基础知识。
语言模型: GPT 或基于Transformer 的架构的一般知识。
开源工具: 具有GitHub 存储库和基本代码部署经验。
CODEGEN:程序综合民主化
由于缺乏培训资源和数据,用于程序合成的高性能语言模型一直受到阻碍- 现在,Salesforce 研究团队已开始通过名为CODEGEN 的LLM 系列来解决这个问题,其参数大小范围为15 亿到161 亿。CODEGEN 背后的创新之处在于全方位的培训。它利用自然语言和编程语言的大量文本语料库,使CODEGEN 能够深入理解人类语言和代码。这使得它能够在许多程序综合任务中表现出色。
CODEGEN 最令人印象深刻的方面是它在HumanEval 基准测试上的卓越表现,HumanEval 基准测试是零样本代码生成的事实上的标准评估。通过超越最先进的模型,CODEGEN 展示了无需微调特定任务即可生成高质量功能代码的可能性。
用于增强程序综合的 CodeGen 多阶段训练方法
CodeGen 基于变压器的架构利用自注意力来捕获自然语言和代码中的复杂关系。 CodeGen 的独特之处在于其多阶段训练方法,使其能够熟练地理解和生成跨各种编程语言的代码。 CodeGen 模型训练过程涉及的三个关键阶段是:CODEGEN-NL: 最初在The Pile 上进行预训练,The Pile 是一个包含代码数据的大规模精选数据集。此阶段为自然语言理解奠定了基础。
CODEGEN-MULTI: 基于CODEGEN-NL,此阶段包括BigQuery 训练,BigQuery 是一个包含多种编程语言(包括C、C++、Go、Java、JavaScript 和Python)代码的数据集。
CODEGEN-MONO: 最后阶段通过在BigPython(来自GitHub 存储库的Python 代码数据集)上进行训练来重点关注Python 特定功能。
图片来源
凭借顺序训练方法的可能性,CodeGen 可以理解自然语言和多种编程语言。因此,它是与程序综合相关的任务的有效解决方案。
释放多轮程序综合的力量
多轮程序综合代表了代码创建的尖端方法。在这种方法中,用户和系统进行迭代交互,以逐步设计、完善和纠正程序。与仅根据单个提示生成完整片段的传统单轮技术形成鲜明对比,多轮合成促进了交互式开发。这使得能够生成更复杂和更准确的代码。
多轮程序综合的关键概念
以下是多轮程序综合的一些关键概念:迭代细化: 多轮综合利用了用户机器协作的循环特征。根据用户的初始输入或高级描述,模型会生成初步的代码草案。然后,用户可以完善提示、请求修改并指定更正- 所有这些都会导致优化最终输出的渐进迭代。
基于对话的交互: 这种方法涉及一个促进对话的交互界面,用户和模型可以在其中活跃地交换想法。该模型提出了进一步澄清的询问,用户回复了更多详细信息;并且模型相应地更新代码。
上下文保留: 系统保留对话上下文的能力对于增强对用户意图的理解并有效地集成所做的任何修改至关重要。这对于处理需要多个步骤和调整的复杂编程任务至关重要。
使用 CODEGEN 生成多轮代码
这是令人印象深刻的- 任何人都不应该低估CODEGEN,它在单轮代码生成任务中仍然表现良好。然而,构建模型的研究人员进一步进行了这些研究,探索多轮程序合成。在大多数程序合成工作中,任务是给模型一个单一的、完整的输入提示,并让它尝试一次性吐出程序。Salesforce 研究团队意识到,通常需要一种更细致、分步的方法,将复杂的问题分解为小的、模块化的子问题。
为了研究这个概念,研究人员开发了多轮编程基准(MTPB)。它是一个综合数据集,由115 个需要多轮程序综合的不同问题集组成。通过评估CODEGEN 在该基准测试中的性能,他们能够证明多轮方法相对于单轮方法的显着优势。
通过迭代细化增强代码生成
如果用户被分配执行线性回归模型,他可以请求模型说“对X 和Y 执行线性回归”。这里的假设是模型能够流利地理解该指令并立即呈现出包含所有内容的代码片段。这种技术对于简单的任务来说是有用的,但在面对更复杂的编程挑战时就变得不够用了。多轮编程综合彻底改变了这一过程。它将任务分成更小的步骤,以便随着时间的推移进行改进。例如,如果我们想对x 和y 执行线性回归,程序将首先设置基本结构,例如导入库和定义变量,然后再完成任务。
用户将提供更多提示,例如“用数据拟合模型并打印系数”,然后他可以说“预测一组新的x 的值并绘制结果”。这有助于确保任务的每个部分都得到正确处理,并且可以根据用户的反馈进行更改。下图说明了线性回归任务的单轮和多轮示例。
多轮编程综合:步执行线性回归任务
使用多匝有很多好处。它可以帮助我们更准确地控制编码过程,因为每个过程都专注于特定的任务,从而减少错误。在整个过程中获得用户的反馈可以进行调整,以更好地满足他们的需求和偏好。
上面的流程图捕捉到了在建立线性回归模型时单轮编程综合和多轮编程综合之间存在的显着差异。当使用前一种方法时,用户只需提示:“对x和y执行线性回归”,渴望立即生成完整的代码。然而,事实证明,这种方法在解决需要理解和迭代细化的复杂编码挑战方面存在局限性。
在多轮示例中,我们采取迭代步骤来完成一个过程。用户从提示开始,获得结构化响应,帮助建立基本框架,如必要的库和变量。随后的每次交互都涉及反馈,以指导模型拟合数据、打印系数、预测新值和创建可视化。
将 CODEGEN 与 Hugging Face Transformer 集成
基于Hugging Face 的系统的另一个重要组成部分是Transformers 库,这是一个功能强大的通用开源工具包,可让开发人员使用LLM(包括CODEGEN)进行工作。将CODEGEN 集成到Transformers 库中,用户可以在其应用程序和工作流程中轻松利用模型的功能。以下是如何将CODEGEN 与Hugging Face Transformers 库结合使用的示例:
进口火炬
从变压器导入AutoTokenizer、AutoModelForCausalLM
tokenizer=AutoTokenizer.from_pretrained('Salesforce/codegen-2B-mono')
模型=AutoModelForCausalLM.from_pretrained('Salesforce/codegen-2B-mono')
input=tokenizer('# 该函数打印hello world', return_tensors='pt')
样本=model.generate(__inputs, max_length=128)
打印(tokenizer.decode(样本[0],truncate_before_pattern=[r'
^#', '^'''', '
']))
输出:


