


8
月
在社区成长 8 月
LEVEL 50
100 XP
AI/ML
 作者:Shaoni Mukherjee
技术撰稿人
 目录热门话题
“能力越大,责任越大”
在这种情况下,模型复杂性越高,功耗和内存消耗也越大。
例如,由于涉及文本编码器、扩散主干和图像解码器等组件,使用Stable Diffusion 3 等模型运行推理需要巨大的GPU 内存。这种高内存要求会给那些使用消费级GPU 的人带来阻碍,从而阻碍可访问性和实验。
输入模型量化。想象一下能够将资源匮乏的模型缩小到更易于管理的规模而不牺牲其有效性。量化就像将高分辨率图像压缩为更紧凑的格式一样,将模型的参数转换为较低精度的表示形式。这不仅减少了内存使用量,还加快了计算速度,使复杂的模型更容易访问和使用。
在这篇文章中,我们探讨了Quanto 的量化工具如何显着提高基于Transformer 的扩散管道的内存效率。
量化知识: 模型量化的基本概念及其在优化AI 模型中的目的。
设置环境: 访问安装了Python 以及所需依赖项(例如PyTorch 和Optimum)的计算机。
计算资源: 用于基准测试性能的支持GPU 的环境(例如NVIDIA H100)。
示例模型/数据集: 用于使用Quanto 进行测试和实验的预训练模型或数据集。
推出Quanto,这是Optimum 的新量化后端,旨在提供通用且简单的量化过程。 Quanto 以其对各种功能的全面支持而脱颖而出,确保与不同型号配置和设备的兼容性:
Quanto 也是Hugging Face Optimum 的一部分,Hugging Face Optimum 是一组用于硬件优化的工具
Eager 模式兼容性: 与不可追踪模型无缝协作。
设备灵活性: 量化模型可以部署在任何设备上,包括CUDA 和MPS。
自动集成: 自动插入量化/反量化存根、函数运算和量化模块。
简化的工作流程: 提供从浮点模型到动态和静态量化模型的轻松过渡。
序列化支持: 与PyTorch Weight_only 和 Safetensors 格式兼容。
加速矩阵乘法: 支持CUDA 设备上的各种量化格式(int8-int8、fp16-int4、bf16-int8、bf16-int4)。
广泛的支持: 处理int2、int4、int8 和float8 权重和激活。
虽然许多工具专注于使大型AI 模型变得更小,但Quanto 的设计简单且适用于所有类型的模型。
!pip 安装最佳双币种
量化模型
下面的代码将有助于将标准模型转换为量化模型
从optimal.quanto导入量化,qint8
量化(模型,权重=qint8,激活=qint8)
校准
Quanto的校准模式确保量化参数调整到模型中的实际数据分布,从而提高量化模型的准确性和效率。
from optimization.quanto 导入校准
带校准(动量=0.9):
型号(样品)
量化感知训练
如果模型性能受到影响,可以对模型进行几个时期的调整以提高模型性能。
进口火炬
模型.train()
对于batch_idx,枚举(train_loader):中的(数据,目标)
数据,目标=数据.to(设备),目标.to(设备)
优化器.zero_grad()
输出=模型(数据).dequantize()
损失=torch.nn.function.nll_loss(输出,目标)
loss.backward()
优化器.step()
冻结整数权重
冻结模型时,浮点权重将转换为量化权重。
从最佳.Quanto 导入冻结
冻结(模型)
顶级性能: H100 提供卓越的速度和功能,非常适合处理文本到图像和文本到视频生成管道等大型模型所需的复杂操作。
支持FP16: 该GPU 可有效处理FP16(半精度浮点)计算,从而减少内存使用并加快计算速度,而不会显着牺牲精度。
高级硬件功能: H100 支持混合精度训练和推理的优化操作,使其成为旨在减少模型大小同时保持性能的量化技术的绝佳选择。
在基准测试研究中,主要重点是将新型量化工具Quanto 应用于扩散模型。虽然量化在大型语言模型(LLM) 的实践者中众所周知,但在扩散模型中使用较少。 Quanto 用于探索它是否可以在这些模型中节省内存,而质量损失很小或没有。
以下是该研究涉及的内容:
PyTorch 2.4.0: 用于模型训练和推理的深度学习框架。
Diffusers: 用于构建和运行扩散模型的库,从特定提交安装以确保一致性。
Quanto: 量化工具,也是从特定提交安装的。
FP16: 中的计算默认情况下,所有计算均在FP16 中执行,以减少内存使用并提高速度。然而,VAE(变分自动编码器)没有被量化,以避免潜在的数值不稳定。
关注关键管道: 在本研究中,从扩散器中选择了三个基于变压器的扩散管道。选择这些管道是因为它们代表了一些最先进的文本到图像生成模型,使其成为测试Quanto 在保持模型质量的同时减少内存使用的有效性的理想选择。
原相西格玛
稳定扩散3
灵气流
通过使用H100 GPU 并重点关注这些关键模型,该研究旨在展示Quanto 在量化方面弥合LLM 和扩散模型之间差距的潜力,从而在对性能影响最小的情况下显着节省内存。
首先安装所需的软件包,这里我们安装transformers、quanto、torch、sentpiece。但请注意,您可能需要根据要求安装更多软件包。
!pip 安装变压器==4.35.0
!pip install quanto==0.0.11
!pip 安装火炬==2.1.1
!pip安装sentpiece==0.2.0
!pip 安装最佳双币种
在要量化的模块上调用quantize() 函数,指定要量化的组件。在这种情况下,只有参数被量化,而激活保持不变。参数被量化为FP8 数据类型。最后,调用freeze() 函数将原始参数替换为新量化的参数。
从optimum.quanto导入冻结,qfloat8,量化
从扩散器导入PixArtSigmaPipeline
进口火炬
管道=PixArtSigmaPipeline.from_pretrained(
'PixArt-alpha/PixArt-Sigma-XL-2-1024-MS', torch_dtype=torch.float16
).to('cuda')
量化(管道.transformer,权重=qfloat8)
冻结(管道.变压器)
完成后使用管道。
image=pipeline('吉卜力风格,有城堡的奇幻风景').images[0]
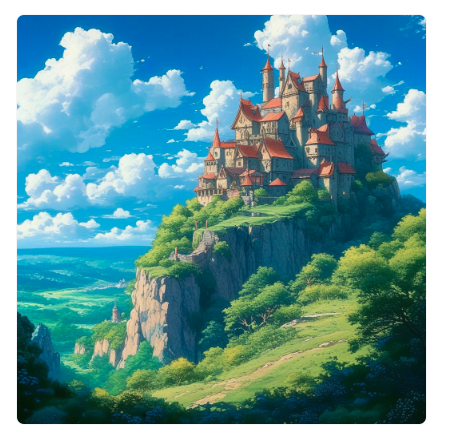
使用FP8 中的扩散变压器生成的图像(图像源)
下面的代码可用于量化文本编码器。
量化(pipeline.text_encoder,权重=qfloat8)
冻结(管道.text_encoder)
文本编码器也是一个转换器模型,也可以被量化。通过量化文本编码器和扩散主干,可以显着节省内存。
下面的代码将加载预训练的语言模型(Meta-Llama-3-8B
技术撰稿人
简介
基于变压器的扩散模型正在日益改进,并已被证明能够彻底改变文本到图像的生成模型。变压器的功能增强了任何模型的可扩展性和性能,从而增加了模型的复杂性。“能力越大,责任越大”
在这种情况下,模型复杂性越高,功耗和内存消耗也越大。
例如,由于涉及文本编码器、扩散主干和图像解码器等组件,使用Stable Diffusion 3 等模型运行推理需要巨大的GPU 内存。这种高内存要求会给那些使用消费级GPU 的人带来阻碍,从而阻碍可访问性和实验。
输入模型量化。想象一下能够将资源匮乏的模型缩小到更易于管理的规模而不牺牲其有效性。量化就像将高分辨率图像压缩为更紧凑的格式一样,将模型的参数转换为较低精度的表示形式。这不仅减少了内存使用量,还加快了计算速度,使复杂的模型更容易访问和使用。
在这篇文章中,我们探讨了Quanto 的量化工具如何显着提高基于Transformer 的扩散管道的内存效率。
先决条件
对AI 模型的基本了解: 熟悉深度学习框架,特别是PyTorch。量化知识: 模型量化的基本概念及其在优化AI 模型中的目的。
设置环境: 访问安装了Python 以及所需依赖项(例如PyTorch 和Optimum)的计算机。
计算资源: 用于基准测试性能的支持GPU 的环境(例如NVIDIA H100)。
示例模型/数据集: 用于使用Quanto 进行测试和实验的预训练模型或数据集。
Quanto 简介:多功能 PyTorch 量化后端
量化是减少深度学习模型的计算和内存需求的关键技术,使它们更适合在消费设备上部署。通过使用8 位整数(int8) 等低精度数据类型而不是32 位浮点(float32),量化不仅可以降低内存存储需求,还可以针对特定硬件进行优化,例如CUDA 设备上的int8 或float8 矩阵乘法。推出Quanto,这是Optimum 的新量化后端,旨在提供通用且简单的量化过程。 Quanto 以其对各种功能的全面支持而脱颖而出,确保与不同型号配置和设备的兼容性:
Quanto 也是Hugging Face Optimum 的一部分,Hugging Face Optimum 是一组用于硬件优化的工具
Eager 模式兼容性: 与不可追踪模型无缝协作。
设备灵活性: 量化模型可以部署在任何设备上,包括CUDA 和MPS。
自动集成: 自动插入量化/反量化存根、函数运算和量化模块。
简化的工作流程: 提供从浮点模型到动态和静态量化模型的轻松过渡。
序列化支持: 与PyTorch Weight_only 和
Safetensors 格式兼容。加速矩阵乘法: 支持CUDA 设备上的各种量化格式(int8-int8、fp16-int4、bf16-int8、bf16-int4)。
广泛的支持: 处理int2、int4、int8 和float8 权重和激活。
虽然许多工具专注于使大型AI 模型变得更小,但Quanto 的设计简单且适用于所有类型的模型。
双币种工作流程
要使用pip 安装Quanto,请使用下面的代码:-!pip 安装最佳双币种
量化模型
下面的代码将有助于将标准模型转换为量化模型
从optimal.quanto导入量化,qint8
量化(模型,权重=qint8,激活=qint8)
校准
Quanto的校准模式确保量化参数调整到模型中的实际数据分布,从而提高量化模型的准确性和效率。
from optimization.quanto 导入校准
带校准(动量=0.9):
型号(样品)
量化感知训练
如果模型性能受到影响,可以对模型进行几个时期的调整以提高模型性能。
进口火炬
模型.train()
对于batch_idx,枚举(train_loader):中的(数据,目标)
数据,目标=数据.to(设备),目标.to(设备)
优化器.zero_grad()
输出=模型(数据).dequantize()
损失=torch.nn.function.nll_loss(输出,目标)
loss.backward()
优化器.step()
冻结整数权重
冻结模型时,浮点权重将转换为量化权重。
从最佳.Quanto 导入冻结
冻结(模型)
H100 基准研究
H100 GPU 是一款高性能显卡,专为要求苛刻的AI 任务而设计,包括变压器和扩散模型等大型模型的训练和推理。这就是选择它用于此基准测试的原因:顶级性能: H100 提供卓越的速度和功能,非常适合处理文本到图像和文本到视频生成管道等大型模型所需的复杂操作。
支持FP16: 该GPU 可有效处理FP16(半精度浮点)计算,从而减少内存使用并加快计算速度,而不会显着牺牲精度。
高级硬件功能: H100 支持混合精度训练和推理的优化操作,使其成为旨在减少模型大小同时保持性能的量化技术的绝佳选择。
在基准测试研究中,主要重点是将新型量化工具Quanto 应用于扩散模型。虽然量化在大型语言模型(LLM) 的实践者中众所周知,但在扩散模型中使用较少。 Quanto 用于探索它是否可以在这些模型中节省内存,而质量损失很小或没有。
以下是该研究涉及的内容:
环境设置
CUDA 12.2: 使用的CUDA 版本,这对于在H100 GPU 上运行计算至关重要。PyTorch 2.4.0: 用于模型训练和推理的深度学习框架。
Diffusers: 用于构建和运行扩散模型的库,从特定提交安装以确保一致性。
Quanto: 量化工具,也是从特定提交安装的。
FP16: 中的计算默认情况下,所有计算均在FP16 中执行,以减少内存使用并提高速度。然而,VAE(变分自动编码器)没有被量化,以避免潜在的数值不稳定。
关注关键管道: 在本研究中,从扩散器中选择了三个基于变压器的扩散管道。选择这些管道是因为它们代表了一些最先进的文本到图像生成模型,使其成为测试Quanto 在保持模型质量的同时减少内存使用的有效性的理想选择。
原相西格玛
稳定扩散3
灵气流
通过使用H100 GPU 并重点关注这些关键模型,该研究旨在展示Quanto 在量化方面弥合LLM 和扩散模型之间差距的潜力,从而在对性能影响最小的情况下显着节省内存。
应用 Quanto 来量化 DiffusionPipeline
使用Quanto 量化模型遵循简单的过程:-首先安装所需的软件包,这里我们安装transformers、quanto、torch、sentpiece。但请注意,您可能需要根据要求安装更多软件包。
!pip 安装变压器==4.35.0
!pip install quanto==0.0.11
!pip 安装火炬==2.1.1
!pip安装sentpiece==0.2.0
!pip 安装最佳双币种
在要量化的模块上调用quantize() 函数,指定要量化的组件。在这种情况下,只有参数被量化,而激活保持不变。参数被量化为FP8 数据类型。最后,调用freeze() 函数将原始参数替换为新量化的参数。
从optimum.quanto导入冻结,qfloat8,量化
从扩散器导入PixArtSigmaPipeline
进口火炬
管道=PixArtSigmaPipeline.from_pretrained(
'PixArt-alpha/PixArt-Sigma-XL-2-1024-MS', torch_dtype=torch.float16
).to('cuda')
量化(管道.transformer,权重=qfloat8)
冻结(管道.变压器)
完成后使用管道。
image=pipeline('吉卜力风格,有城堡的奇幻风景').images[0]
使用FP8 中的扩散变压器生成的图像(图像源)
下面的代码可用于量化文本编码器。
量化(pipeline.text_encoder,权重=qfloat8)
冻结(管道.text_encoder)
文本编码器也是一个转换器模型,也可以被量化。通过量化文本编码器和扩散主干,可以显着节省内存。
法学硕士管道
optimization-quanto 提供帮助程序类来量化、保存和重新加载Hugging Face 量化模型。下面的代码将加载预训练的语言模型(Meta-Llama-3-8B


