


8
月
在社区成长 8 月
LEVEL 90
100 XP
GPUAI/ML
 作者:Melani Maheswaran
 目录热门主题
当主机代码(CPU 串行代码)调用内核函数时,CUDA 程序的执行开始。此函数调用在设备(GPU) 上启动线程网格以并行处理不同的数据组件。
线程由程序代码、代码中的当前执行点以及其变量和数据结构的值组成。一组线程形成一个线程块,一组线程块组成CUDA内核网格。软件组件、线程和线程块直接对应于它们的硬件类似物、CUDA 核心和CUDA 流多处理器(SM)。
这些共同构成了GPU 的组成部分。
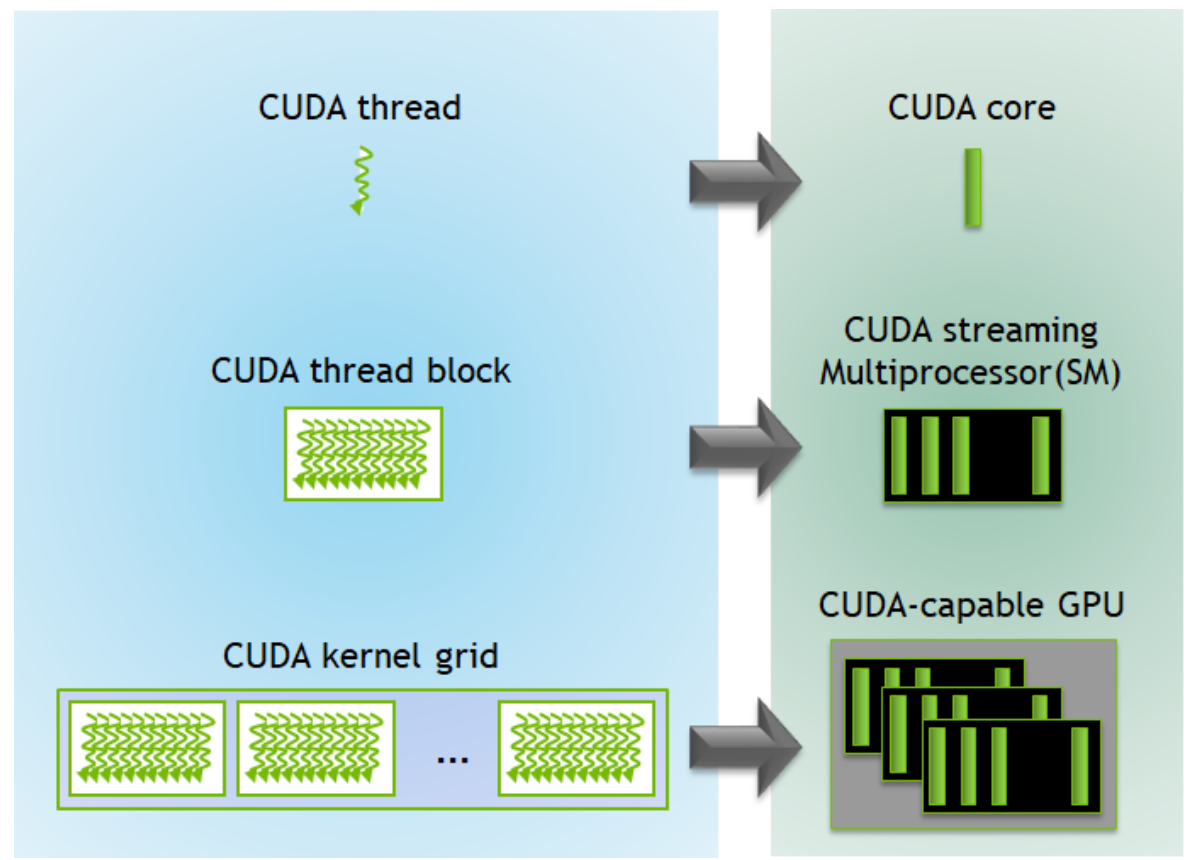
线程被组织成块,块被组织成网格。图取自NVIDIA 技术博客。
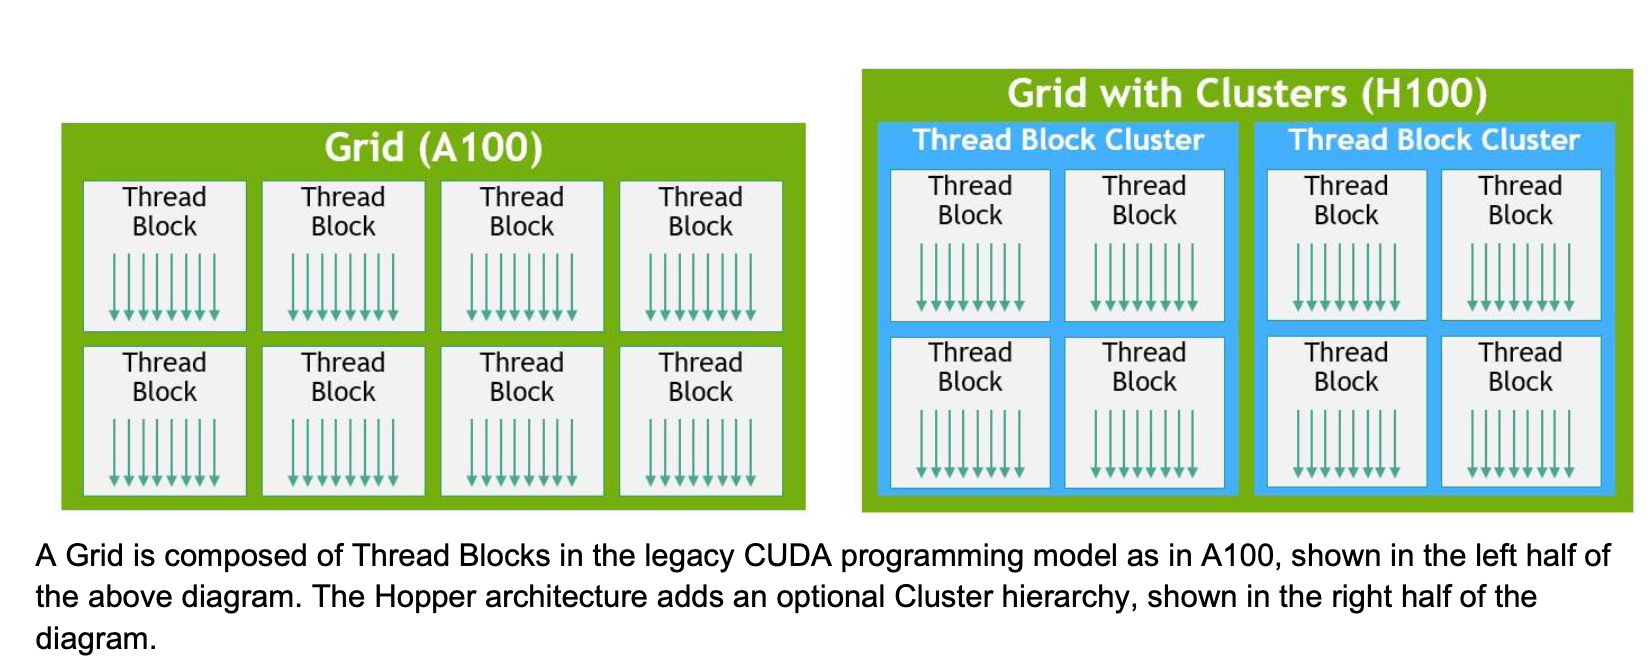
图取自NVIDIA H100 白皮书。
H100 引入了新的线程块集群架构,扩展了GPU 的物理编程架构,现在包括线程、线程块、线程块集群和网格。
以下是不同内存类型的快速概述:
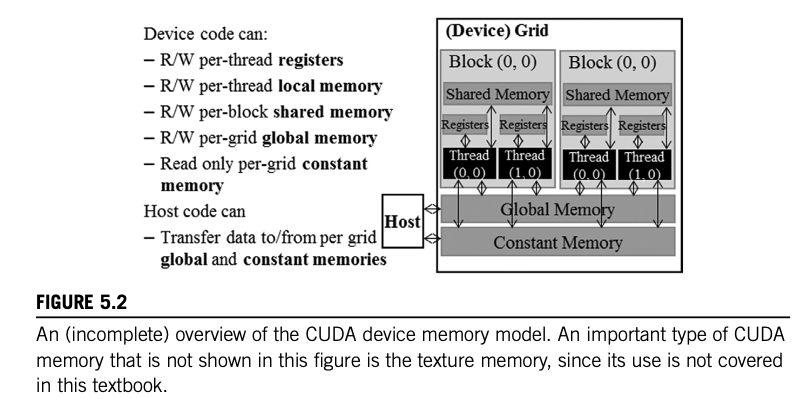
该图取自《大规模并行处理器编程》教科书第4 版第5 章。
寄存器内存是每个线程私有的。这意味着当该特定线程结束时,该寄存器的数据将丢失。
本地内存也是每个线程私有的,但它比寄存器内存慢。
共享内存可供同一块中的所有线程访问,并在块的生命周期内持续存在。
全局内存保存在网格/主机的持续时间内持续的数据。所有线程和主机都可以访问全局内存。
常量内存是只读的,专为在内核执行期间不会更改的数据而设计。
纹理内存是另一种只读内存类型,非常适合物理相邻数据访问。与全局内存相比,它的使用可以减轻内存流量并提高性能。
寄存器和共享存储器都是片上存储器,可以以并行方式以非常高的速度访问驻留在这些存储器中的变量。
通过有效地利用寄存器,可以最大化数据重用并优化性能。
在为大规模并行处理器设计内存系统时,会存在恒定的内存变量。重写这些变量是多余且毫无意义的。因此,像常量高速缓存这样的专用存储器系统消除了对计算成本高昂的硬件逻辑的需要。
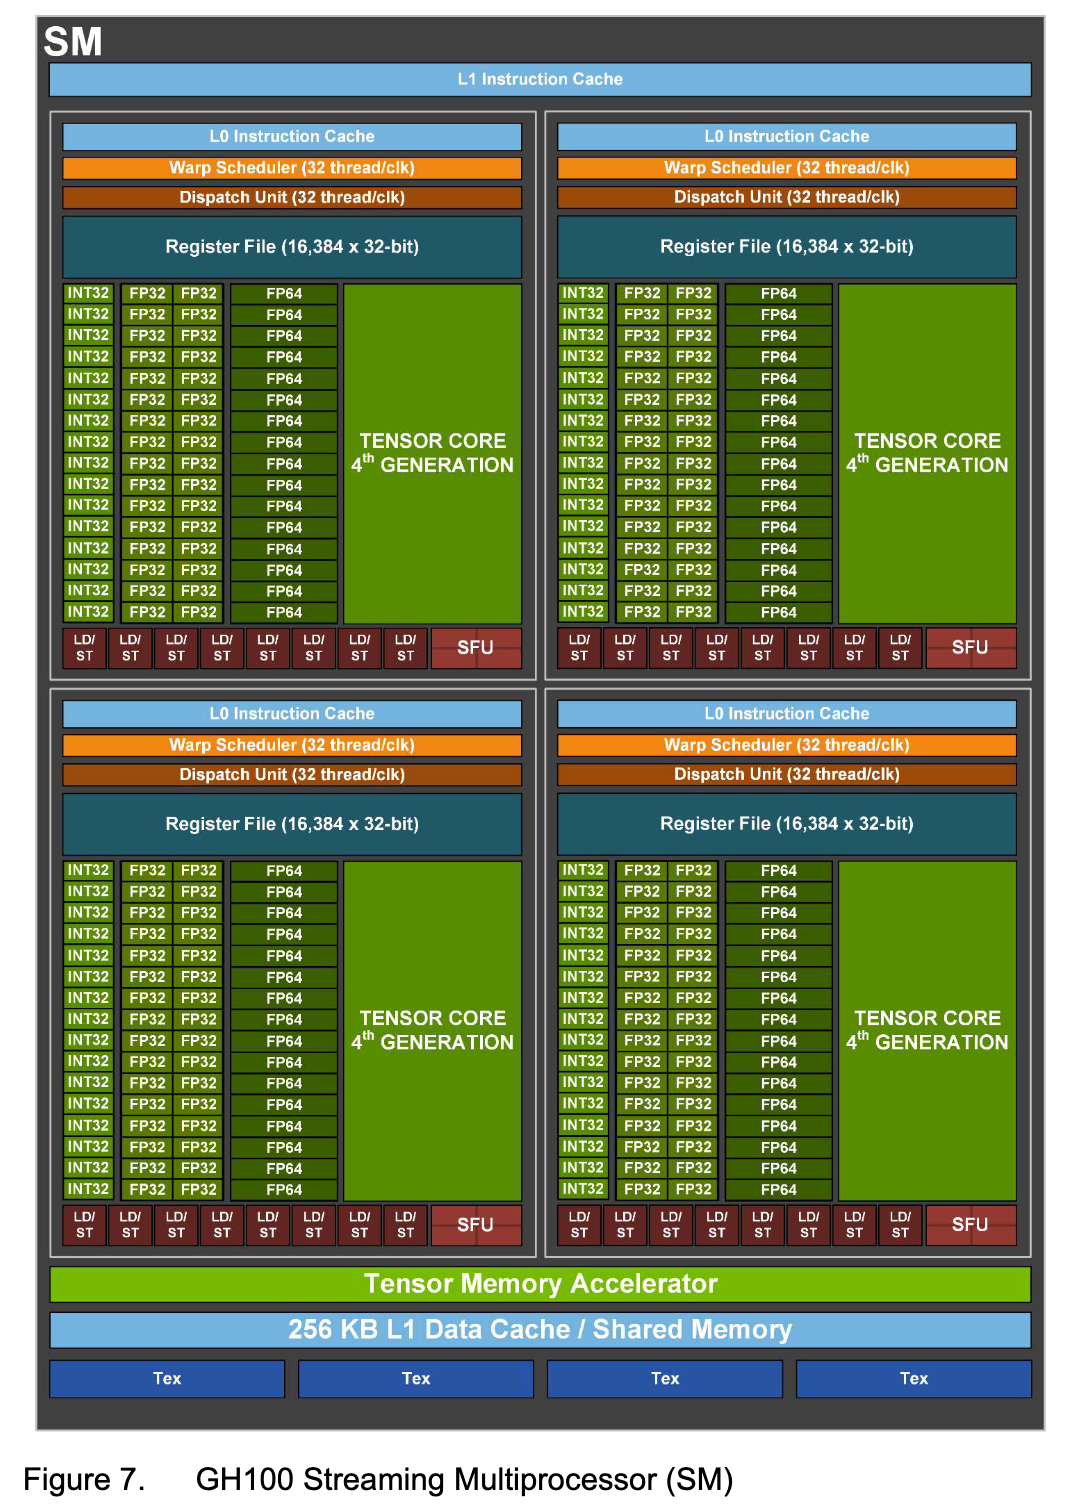
NVIDIA Hopper 流式多处理器。图取自NVIDIA H100 白皮书。
与之前的NVIDIA 微架构相比,Hopper 通过其H100 系列GPU 引入了新功能来增强其性能。
张量内存加速器(TMA) 单元允许在全局内存和共享内存之间高效传输大块数据。
异步事务屏障允许CUDA 线程和片上加速器同步,无论它们物理上是否位于单独的SM 上。
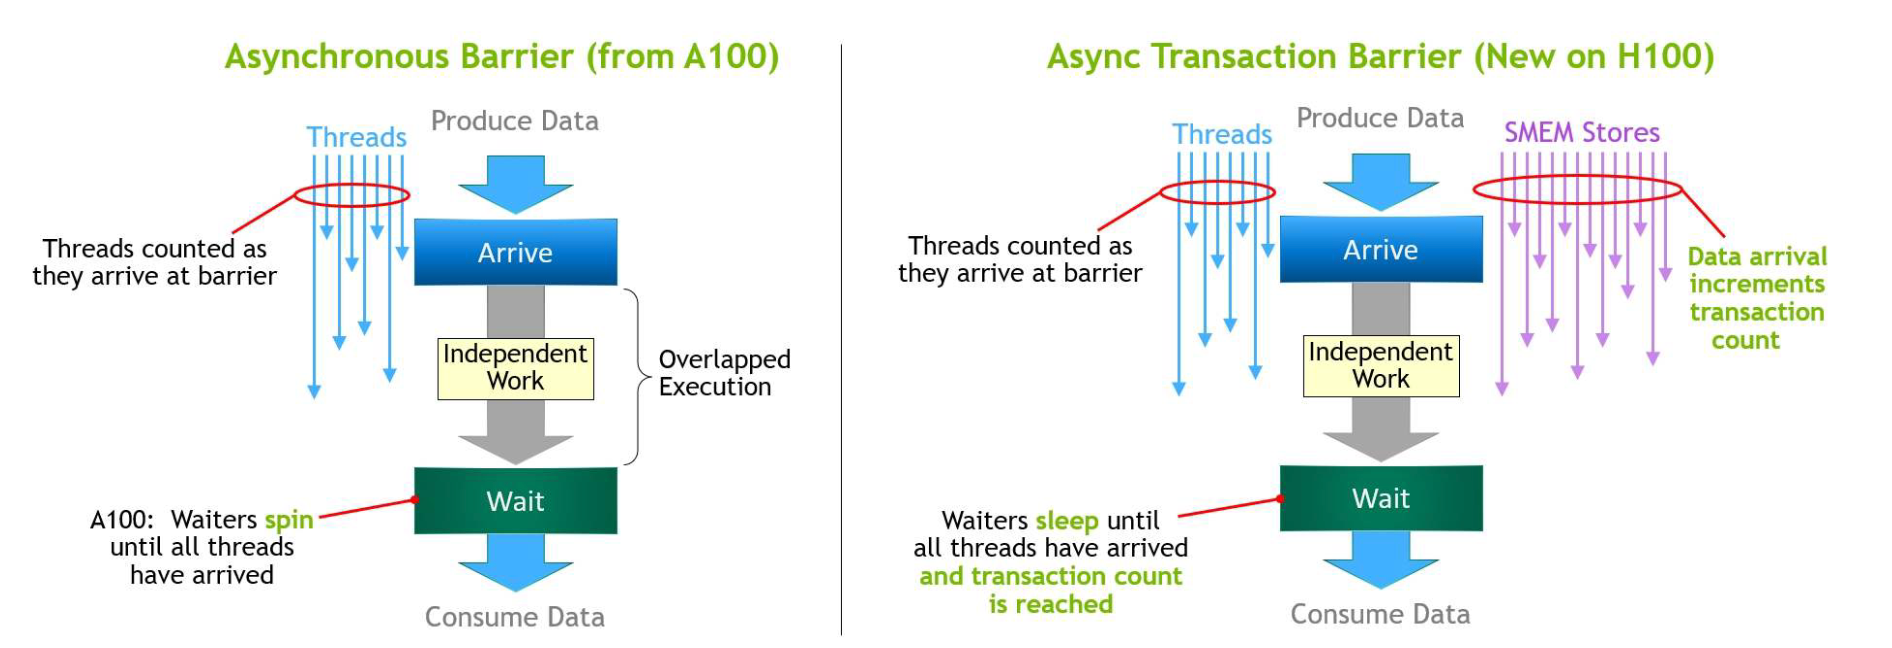
H100 包含Ampere GPU 架构中引入的异步屏障和新的异步事务屏障。
霍珀白皮书
CUDA 复习: CUDA 编程模型| NVIDIA 技术博客
简介
GPU 内存层次结构日益成为深度学习研究人员和从业者感兴趣的领域。通过围绕内存层次结构构建直觉,开发人员可以最大限度地减少内存访问延迟、最大化内存带宽并降低功耗,从而缩短处理时间、加速数据传输并实现经济高效的计算使用。对内存架构的透彻理解将使开发人员能够大规模实现GPU 的峰值能力。CUDA 复习
CUDA(统一计算设备架构)是NVIDIA开发的用于配置GPU的并行计算平台。当主机代码(CPU 串行代码)调用内核函数时,CUDA 程序的执行开始。此函数调用在设备(GPU) 上启动线程网格以并行处理不同的数据组件。
线程由程序代码、代码中的当前执行点以及其变量和数据结构的值组成。一组线程形成一个线程块,一组线程块组成CUDA内核网格。软件组件、线程和线程块直接对应于它们的硬件类似物、CUDA 核心和CUDA 流多处理器(SM)。
这些共同构成了GPU 的组成部分。
线程被组织成块,块被组织成网格。图取自NVIDIA 技术博客。
图取自NVIDIA H100 白皮书。
H100 引入了新的线程块集群架构,扩展了GPU 的物理编程架构,现在包括线程、线程块、线程块集群和网格。
CUDA 内存类型
CUDA 设备使用的内存存储类型的可访问性和持续时间各不相同。当CUDA 程序员将变量分配给特定的CUDA 内存类型时,他们会规定变量的访问方式、访问速度及其可见范围。以下是不同内存类型的快速概述:
该图取自《大规模并行处理器编程》教科书第4 版第5 章。
寄存器内存是每个线程私有的。这意味着当该特定线程结束时,该寄存器的数据将丢失。
本地内存也是每个线程私有的,但它比寄存器内存慢。
共享内存可供同一块中的所有线程访问,并在块的生命周期内持续存在。
全局内存保存在网格/主机的持续时间内持续的数据。所有线程和主机都可以访问全局内存。
常量内存是只读的,专为在内核执行期间不会更改的数据而设计。
纹理内存是另一种只读内存类型,非常适合物理相邻数据访问。与全局内存相比,它的使用可以减轻内存流量并提高性能。
GPU 内存层次结构
速度与容量的权衡
重要的是要了解,就内存访问效率而言,需要在带宽和内存容量之间进行权衡。较高的速度与较低的容量相关。寄存器
寄存器是GPU 上最快的内存组件,包括直接向CUDA 内核提供数据的寄存器文件。内核函数使用寄存器来存储线程私有且经常访问的变量。寄存器和共享存储器都是片上存储器,可以以并行方式以非常高的速度访问驻留在这些存储器中的变量。
通过有效地利用寄存器,可以最大化数据重用并优化性能。
缓存级别
现代处理器中存在多级缓存。到处理器的距离反映在这些缓存的编号方式上。一级缓存
L1 或一级高速缓存直接连接到处理器核心。当活动数据量超过SM 寄存器文件的容量时,它充当备份存储区域。二级缓存
L2 或2 级缓存更大,并且通常在SM 之间共享。与L1 缓存不同,只有一个L2 缓存。恒定缓存
常量缓存捕获每个内核常用的变量,从而提高性能。在为大规模并行处理器设计内存系统时,会存在恒定的内存变量。重写这些变量是多余且毫无意义的。因此,像常量高速缓存这样的专用存储器系统消除了对计算成本高昂的硬件逻辑的需要。
H100 的新内存功能
NVIDIA Hopper 流式多处理器。图取自NVIDIA H100 白皮书。
与之前的NVIDIA 微架构相比,Hopper 通过其H100 系列GPU 引入了新功能来增强其性能。
线程块簇
正如本文前面提到的,线程块集群随H100 一起首次亮相,扩展了CUDA 编程层次结构。与单个SM 上的线程块所允许的相比,线程块集群允许对更大的线程组进行更大的编程控制。异步执行
异步执行的最新进展在Hopper 架构中引入了张量内存加速器(TMA) 和异步事务屏障。张量内存加速器(TMA) 单元允许在全局内存和共享内存之间高效传输大块数据。
异步事务屏障允许CUDA 线程和片上加速器同步,无论它们物理上是否位于单独的SM 上。
H100 包含Ampere GPU 架构中引入的异步屏障和新的异步事务屏障。
结论
将变量分配给特定的CUDA 内存类型允许程序员对其行为进行精确控制。该指定不仅决定了变量的访问方式,还决定了访问发生的速度。存储在访问时间较快的内存类型(例如寄存器或共享内存)中的变量可以快速检索,从而加速计算。相反,较慢内存类型(例如全局内存)中的变量的访问速度较慢。此外,内存类型分配会影响变量的使用范围以及与其他线程的交互。分配的内存类型控制变量是否可由单个线程、线程块或网格内的所有线程访问。最后,H100s(当前用于AI 工作流程的SOTA GPU)引入了一些影响内存访问的新功能,例如线程块集群、张量内存加速器(TMA) 单元和异步事务屏障。参考文献
大规模并行处理器编程(第4 版)霍珀白皮书
CUDA 复习: CUDA 编程模型| NVIDIA 技术博客


