


8
月
在社区成长 8 月
LEVEL 30
100 XP
计算机视觉AI/ML
 作者:James Skelton
技术布道者//AI 奥术师
 目录热门话题我们在DigitalOcean 博客的Paperspace 上讨论了很多关于深度学习图像生成的功能和潜力。图像生成工具不仅使用起来有趣且直观,而且是公众可用的最广泛民主化和分布式人工智能模型之一。事实上,唯一具有更大社会影响力的深度学习技术是大型语言模型。
在过去的两年里,稳定扩散(Stable Diffusion),第一个公开发布的功能性图像合成模型,完全占据了主导地位。我们已经写过关于PixArt Alpha/Sigma 等竞争对手的文章,并对AuraFlow 等其他竞争对手进行了研究,但是,在每次发布时,没有什么比稳定扩散模型更能定下基调。 Stable Diffusion 3 仍然是最好的开源模型之一,许多人仍在尝试效仿他们的成功。
上周,随着Black Forest Labs 发布FLUX,这种模式发生了变化。 FLUX 在即时理解、物体识别、词汇、书写能力等方面代表了图像合成技术的明显进步。在本教程中,我们将讨论在研究团队发布任何Flux 相关论文之前,公众对这两个开源FLUX 模型FLUX.1 schnell 和FLUX.1-dev 的了解很少。之后,我们将展示如何在由NVIDIA H100 GPU 提供支持的DigitalOcean GPU Droplet 上运行Flux。
Cloud GPU: 运行FLUX.1 将需要足够强大的GPU。我们建议机器至少配备40 GB VRAM。
关于FLUX 模型的开发很少公开,但我们确实知道以下:
所有公共FLUX.1 模型均基于“多模态和并行扩散变压器块的混合架构,并可缩放至12B 参数”(来源)
他们使用流匹配来训练模型,流匹配是一种基于连续归一化流而不是扩散路径的训练方法替代方案,“在可能性和样本质量方面比基于扩散的替代方法始终获得更好的性能”(来源)
通过结合旋转位置嵌入和并行注意层,提高模型性能并提高硬件效率(来源)
这是我们所知道的关于他们为FLUX.1 添加的典型潜在扩散建模技术的大部分改进。幸运的是,他们将在不久的将来发布一份官方技术报告供我们阅读。与此同时,他们在发布声明的其余部分中提供了更多定性和比较信息。
让我们更深入地挖掘一下并讨论他们的官方博客文章: 中提供了哪些信息
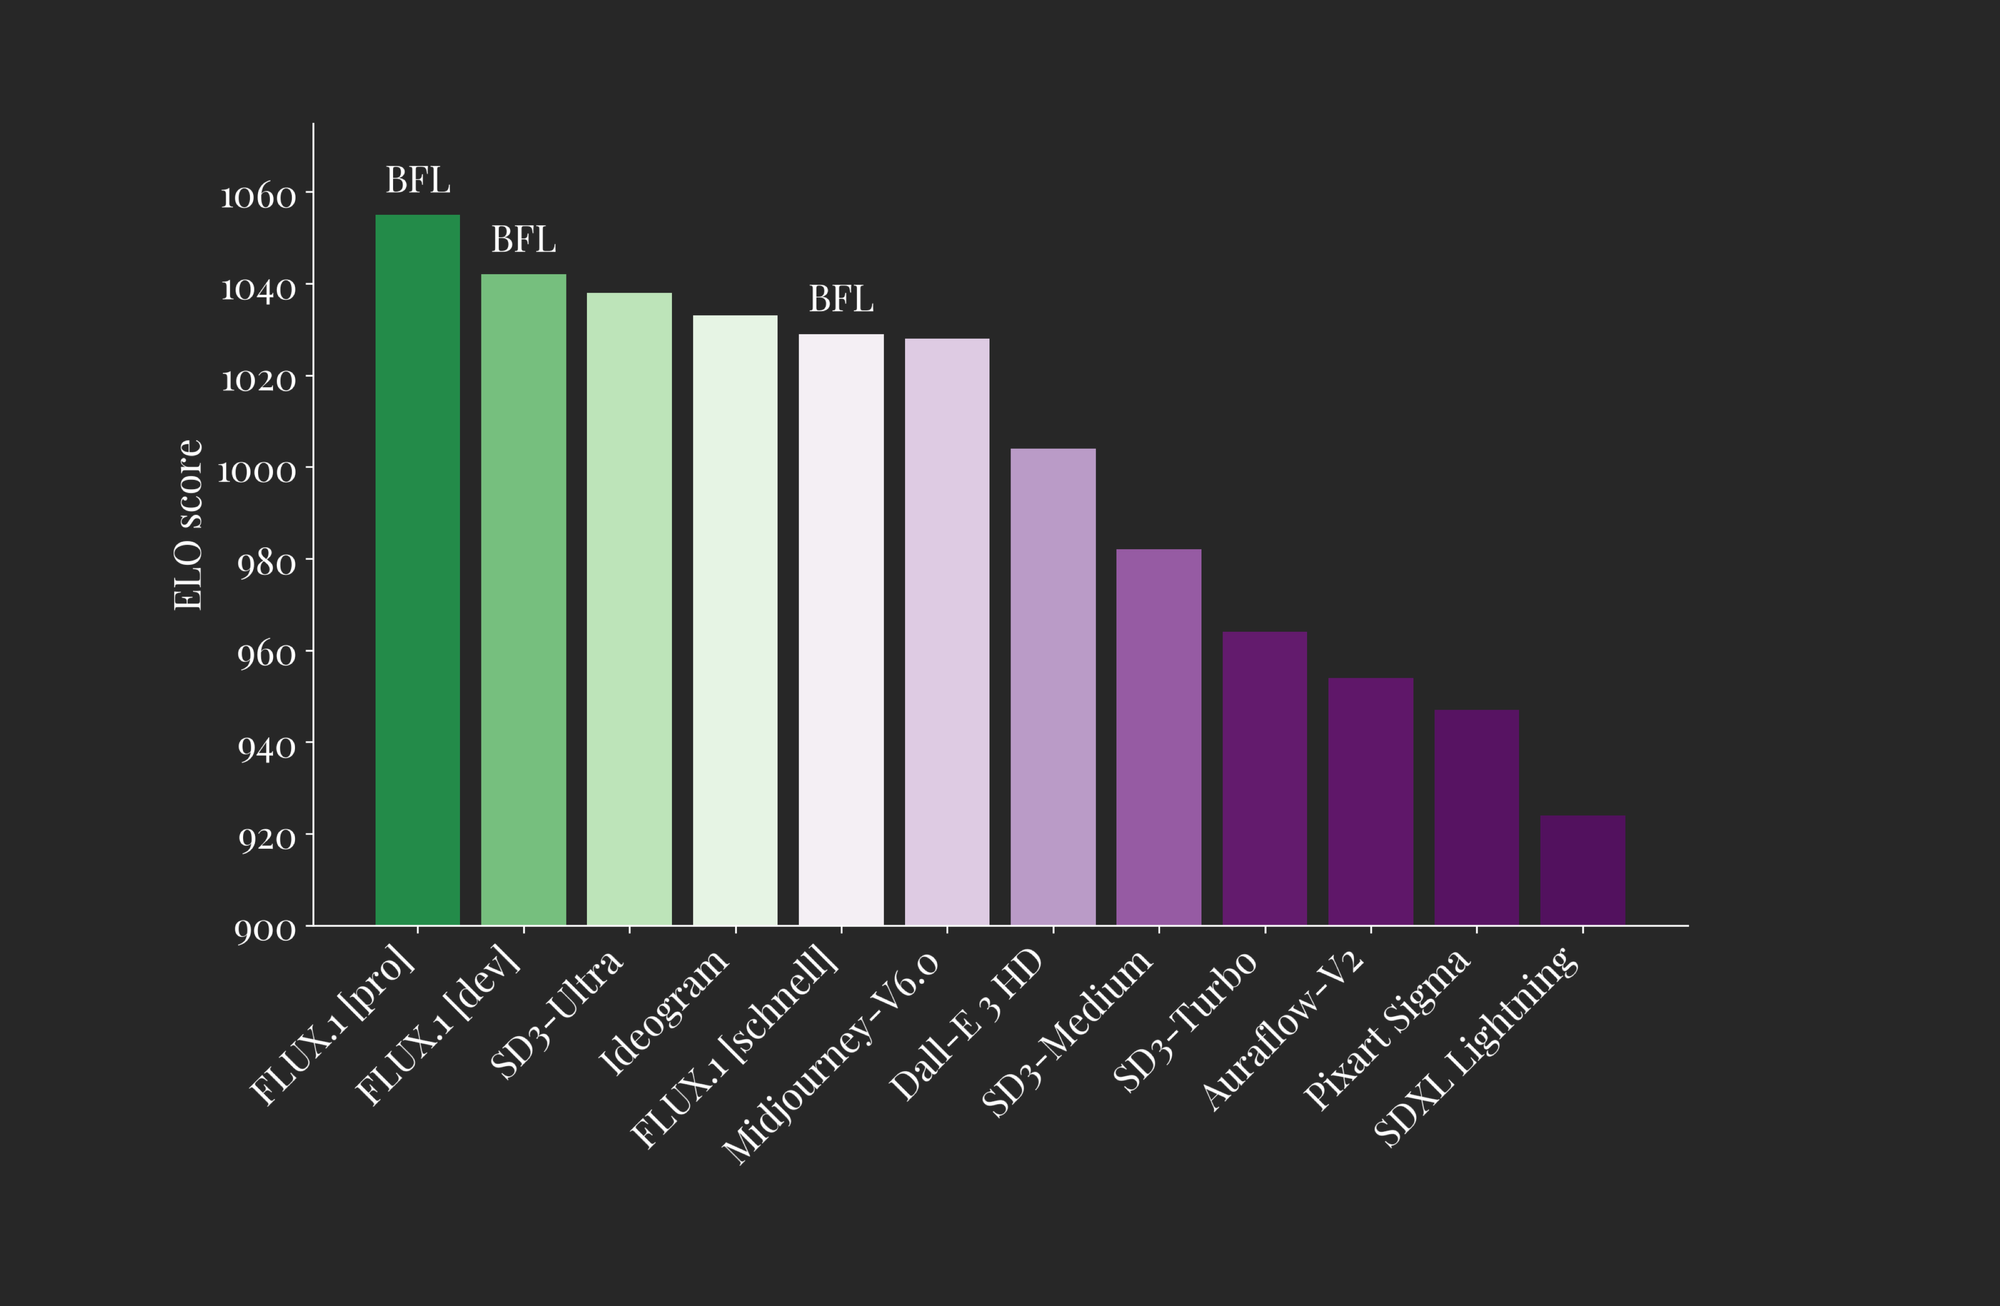
基于ELO 的领先图像合成模型的比较(来源)
FLUX 的发布旨在“定义文本到图像合成的图像细节、即时一致性、风格多样性和场景复杂性方面的新的最先进技术”(来源)。为了更好地实现这一点,他们发布了FLUX: Pro、Dev 和Schnell 三个版本。
第一个只能通过API 获得,而后两个则不同程度地开源。从上图中我们可以看到,在输出质量(ELO 分数)方面,每个FLUX 模型的表现与封闭和开源可用的顶级性能模型相当。由此,我们可以推断出每个FLUX 模型在理解文本输入和潜在场景复杂性方面都具有最高质量的图像生成。
让我们更仔细地看看这些版本之间的差异:
FLUX.1 pro: 是该型号的最佳性能版本。它提供最先进的图像合成,在提示跟随性、细节、质量和输出多样性方面甚至超越了Stable Diffusion 3 Ultra 和Ideogram。 (来源)
FLUX.1 dev: FLUX.1 dev 是“用于非商业应用的开放权重、指导蒸馏模型”(来源)。它是直接从FLUX.1 pro 模型中提炼出来的,在图像生成方面几乎提供了相同水平的性能,并且效率显着提高。这使得FLUX.1 dev 成为可用于图像合成的最强大的开源模型。 HuggingFace 上提供FLUX.1 开发权重,但请记住该许可证仅限于非商业用途
FLUX.1 schnell: schnell 是最快的模型,专为本地开发和个人使用而设计。该模型能够在短短4 个步骤内生成高质量图像,使其成为有史以来最快的图像生成模型之一。与dev 一样,schnell 也可在HuggingFace 上使用,推理代码可在GitHub 上找到
(来源)
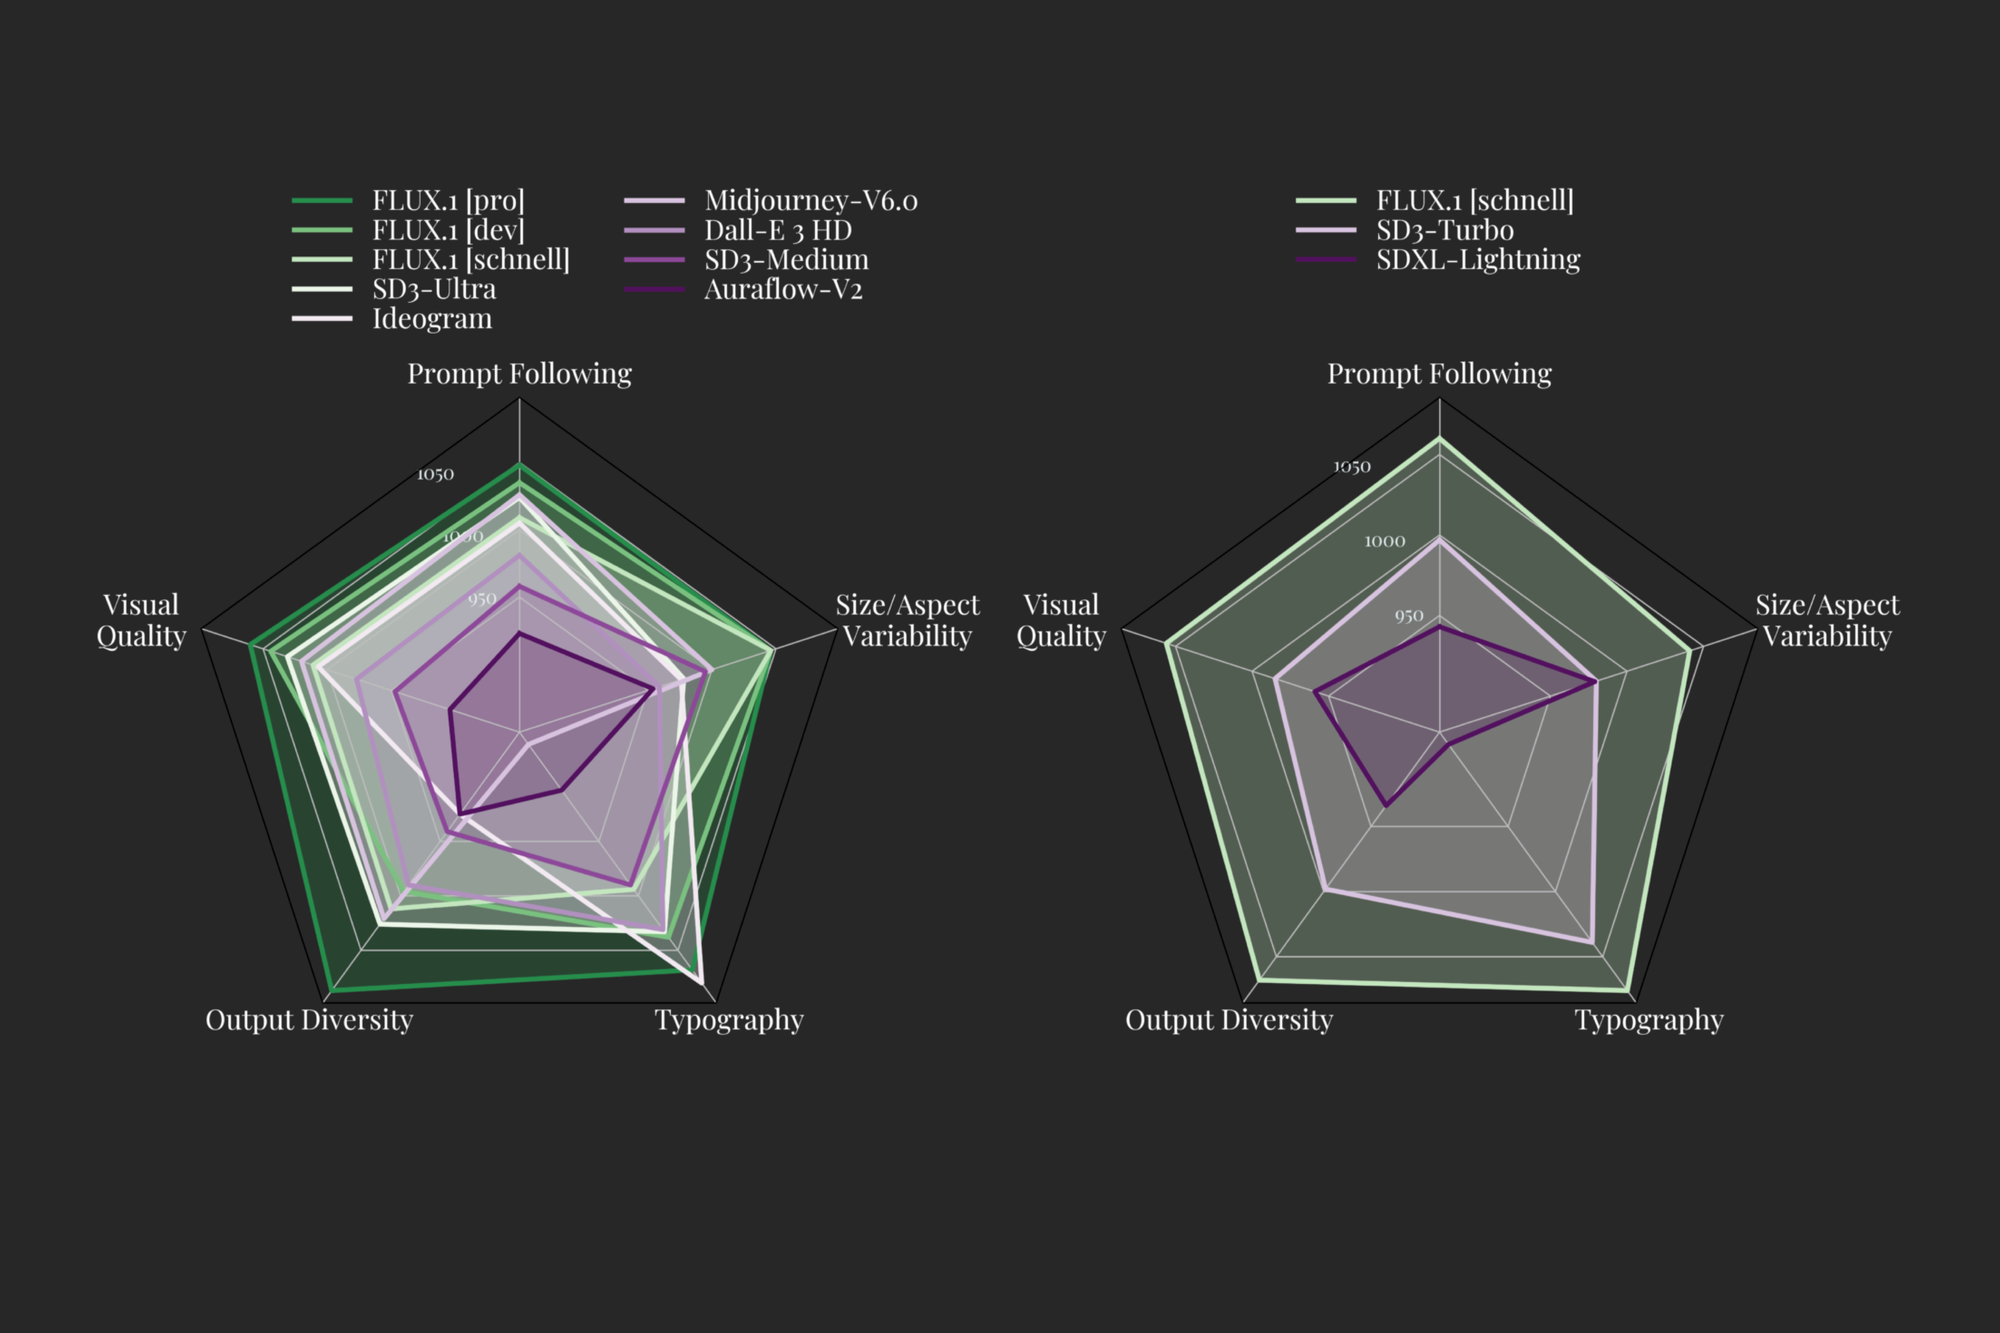
研究人员确定了5 个特征来更具体地测量图像生成模型,即视觉质量、提示跟随、尺寸/方面可变性、版式和输出多样性。根据黑森林团队的说法,上图显示了每个主要图像生成模型在ELO 测量方面的比较情况。他们断言,该模型的每个专业版和开发版在每个类别中都优于Ideogram、Stable Diffusion3 Ultra 和MidJourney V6。此外,他们在博客中表明该模型能够支持多种分辨率和纵横比。
总而言之,发布博客描绘了一幅极其强大的图像生成模型的图景。现在我们已经了解了他们的声明,让我们在NVIDIA H100 上运行他们提供的Gradio 演示,看看该模型如何满足他们的要求。
光盘下载
git 克隆https://github.com/black-forest-labs/flux
光通量
一旦存储库被克隆并且我们进入其中,我们就可以开始设置演示本身。首先,我们将创建一个新的虚拟环境,并安装FLUX 运行的所有要求。
python3.10 -m venv .venv
源.venv/bin/activate
pip install -e '.[全部]'
这将需要一些时间,但一旦完成,我们就几乎准备好运行我们的演示了。剩下的就是登录HuggingFace,然后导航到FLUX 开发页面。如果我们想访问该模型,我们需要同意他们的许可要求。如果您打算仅使用schnell,请跳过此步骤。
接下来,转到HuggingFace 令牌页面并创建或刷新新的读取令牌。我们要拿着这个然后跑
Huggingface-cli 登录
在我们的终端中将访问令牌提供给HuggingFace 缓存。这将确保我们稍后运行演示时可以下载模型。
## 施内尔演示
python demo_gr.py --name Flux-schnell --device cuda
## 开发演示
python demo_gr.py --name Flux-dev --device cuda
我们建议从schnell 开始,因为蒸馏模型实际上使用起来更快、更高效。根据我们使用它的经验,dev 需要更多的微调和提炼,而schnell 实际上能够更好地利用模型的功能。稍后会详细介绍这一点。
运行代码后,演示将开始运行。这些模型将被下载到您机器的HuggingFace 缓存中。对于每个模型下载(schnell 和dev),此过程总共可能需要大约5 分钟。完成后,单击共享的Gradio 公共链接即可开始。或者,您可以使用Core Machine 桌面视图在浏览器中本地打开它。
演示本身非常直观,得益于Gradio 极其易于使用的界面。在左上角,我们有提示输入字段,我们可以在其中输入我们想要的图像的文本提示描述。两种FLUX 模型在提示处理方面都非常强大,因此我们鼓励您尝试一些术语的疯狂组合。
为了
技术布道者//AI 奥术师
在过去的两年里,稳定扩散(Stable Diffusion),第一个公开发布的功能性图像合成模型,完全占据了主导地位。我们已经写过关于PixArt Alpha/Sigma 等竞争对手的文章,并对AuraFlow 等其他竞争对手进行了研究,但是,在每次发布时,没有什么比稳定扩散模型更能定下基调。 Stable Diffusion 3 仍然是最好的开源模型之一,许多人仍在尝试效仿他们的成功。
上周,随着Black Forest Labs 发布FLUX,这种模式发生了变化。 FLUX 在即时理解、物体识别、词汇、书写能力等方面代表了图像合成技术的明显进步。在本教程中,我们将讨论在研究团队发布任何Flux 相关论文之前,公众对这两个开源FLUX 模型FLUX.1 schnell 和FLUX.1-dev 的了解很少。之后,我们将展示如何在由NVIDIA H100 GPU 提供支持的DigitalOcean GPU Droplet 上运行Flux。
先决条件
Python: 本文内容技术性很强。我们向熟悉Python 和深度学习基本概念的读者推荐这篇文章。对于新用户来说,这篇文章可能是一个很好的起点。Cloud GPU: 运行FLUX.1 将需要足够强大的GPU。我们建议机器至少配备40 GB VRAM。
通量模型
FLUX 由Black Forest Labs 团队创建,该团队主要由前Stability AI 员工组成。除了稳定扩散模型套件之外,团队中的工程师还直接负责VQGAN 和潜在扩散的开发/发明。关于FLUX 模型的开发很少公开,但我们确实知道以下:
所有公共FLUX.1 模型均基于“多模态和并行扩散变压器块的混合架构,并可缩放至12B 参数”(来源)
他们使用流匹配来训练模型,流匹配是一种基于连续归一化流而不是扩散路径的训练方法替代方案,“在可能性和样本质量方面比基于扩散的替代方法始终获得更好的性能”(来源)
通过结合旋转位置嵌入和并行注意层,提高模型性能并提高硬件效率(来源)
这是我们所知道的关于他们为FLUX.1 添加的典型潜在扩散建模技术的大部分改进。幸运的是,他们将在不久的将来发布一份官方技术报告供我们阅读。与此同时,他们在发布声明的其余部分中提供了更多定性和比较信息。
让我们更深入地挖掘一下并讨论他们的官方博客文章: 中提供了哪些信息
基于ELO 的领先图像合成模型的比较(来源)
FLUX 的发布旨在“定义文本到图像合成的图像细节、即时一致性、风格多样性和场景复杂性方面的新的最先进技术”(来源)。为了更好地实现这一点,他们发布了FLUX: Pro、Dev 和Schnell 三个版本。
第一个只能通过API 获得,而后两个则不同程度地开源。从上图中我们可以看到,在输出质量(ELO 分数)方面,每个FLUX 模型的表现与封闭和开源可用的顶级性能模型相当。由此,我们可以推断出每个FLUX 模型在理解文本输入和潜在场景复杂性方面都具有最高质量的图像生成。
让我们更仔细地看看这些版本之间的差异:
FLUX.1 pro: 是该型号的最佳性能版本。它提供最先进的图像合成,在提示跟随性、细节、质量和输出多样性方面甚至超越了Stable Diffusion 3 Ultra 和Ideogram。 (来源)
FLUX.1 dev: FLUX.1 dev 是“用于非商业应用的开放权重、指导蒸馏模型”(来源)。它是直接从FLUX.1 pro 模型中提炼出来的,在图像生成方面几乎提供了相同水平的性能,并且效率显着提高。这使得FLUX.1 dev 成为可用于图像合成的最强大的开源模型。 HuggingFace 上提供FLUX.1 开发权重,但请记住该许可证仅限于非商业用途
FLUX.1 schnell: schnell 是最快的模型,专为本地开发和个人使用而设计。该模型能够在短短4 个步骤内生成高质量图像,使其成为有史以来最快的图像生成模型之一。与dev 一样,schnell 也可在HuggingFace 上使用,推理代码可在GitHub 上找到
(来源)
研究人员确定了5 个特征来更具体地测量图像生成模型,即视觉质量、提示跟随、尺寸/方面可变性、版式和输出多样性。根据黑森林团队的说法,上图显示了每个主要图像生成模型在ELO 测量方面的比较情况。他们断言,该模型的每个专业版和开发版在每个类别中都优于Ideogram、Stable Diffusion3 Ultra 和MidJourney V6。此外,他们在博客中表明该模型能够支持多种分辨率和纵横比。
总而言之,发布博客描绘了一幅极其强大的图像生成模型的图景。现在我们已经了解了他们的声明,让我们在NVIDIA H100 上运行他们提供的Gradio 演示,看看该模型如何满足他们的要求。
通量演示
要为schnell 和dev 运行FLUX 演示,我们首先需要在DigitalOcean 或您选择的任何首选云提供商上创建GPU Droplet。我们建议使用H100 或A100-80G GPU 来执行此任务,但A6000 也应该可以毫无问题地处理这些模型。有关GPU Droplet 入门和设置SSH 的详细信息,请参阅DigitalOcean 文档。设置
一旦我们的机器创建完成并且我们已经从本地成功通过SSH 连接到我们的机器,我们就可以导航到我们想要工作的目录。我们选择了“下载”。从那里,我们可以将官方FLUX GitHub 存储库克隆到我们的机器上并移动到新目录中。光盘下载
git 克隆https://github.com/black-forest-labs/flux
光通量
一旦存储库被克隆并且我们进入其中,我们就可以开始设置演示本身。首先,我们将创建一个新的虚拟环境,并安装FLUX 运行的所有要求。
python3.10 -m venv .venv
源.venv/bin/activate
pip install -e '.[全部]'
这将需要一些时间,但一旦完成,我们就几乎准备好运行我们的演示了。剩下的就是登录HuggingFace,然后导航到FLUX 开发页面。如果我们想访问该模型,我们需要同意他们的许可要求。如果您打算仅使用schnell,请跳过此步骤。
接下来,转到HuggingFace 令牌页面并创建或刷新新的读取令牌。我们要拿着这个然后跑
Huggingface-cli 登录
在我们的终端中将访问令牌提供给HuggingFace 缓存。这将确保我们稍后运行演示时可以下载模型。
开始演示
要开始演示,我们现在需要做的就是为要运行的演示执行关联的python 脚本。以下是示例:## 施内尔演示
python demo_gr.py --name Flux-schnell --device cuda
## 开发演示
python demo_gr.py --name Flux-dev --device cuda
我们建议从schnell 开始,因为蒸馏模型实际上使用起来更快、更高效。根据我们使用它的经验,dev 需要更多的微调和提炼,而schnell 实际上能够更好地利用模型的功能。稍后会详细介绍这一点。
运行代码后,演示将开始运行。这些模型将被下载到您机器的HuggingFace 缓存中。对于每个模型下载(schnell 和dev),此过程总共可能需要大约5 分钟。完成后,单击共享的Gradio 公共链接即可开始。或者,您可以使用Core Machine 桌面视图在浏览器中本地打开它。
运行演示
使用FLUX.1 schnell 在H100 上实时生成1024x1024 的图像演示本身非常直观,得益于Gradio 极其易于使用的界面。在左上角,我们有提示输入字段,我们可以在其中输入我们想要的图像的文本提示描述。两种FLUX 模型在提示处理方面都非常强大,因此我们鼓励您尝试一些术语的疯狂组合。
为了


