


8
月
在社区成长 8 月
LEVEL 50
100 XP
矢量数据库的兴起
由于近年来生成式人工智能的快速发展,许多公司都争先恐后地将人工智能融入到他们的业务中。最常见的方法之一是构建人工智能系统来回答有关可在文档数据库中找到的信息的问题。此类问题的大多数解决方案都基于一项关键技术:检索增强生成(RAG)。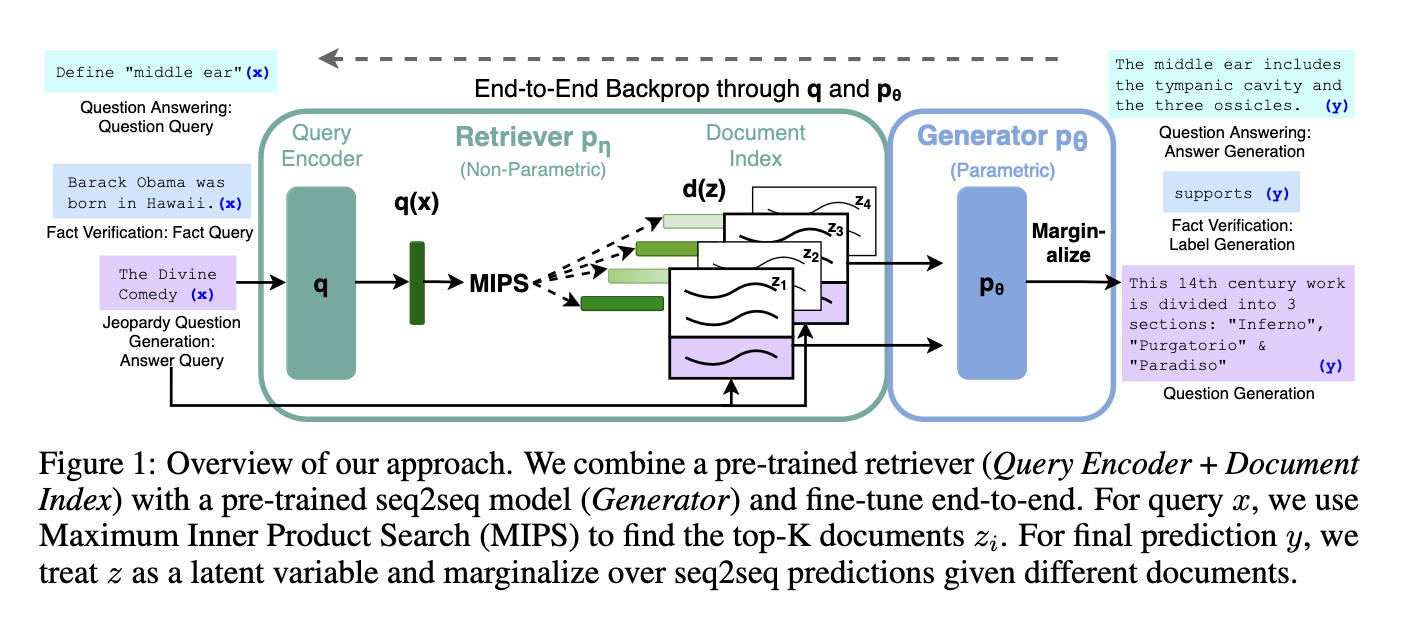
这些RAG 系统通过使用“嵌入”(嵌入模型生成的文档的向量表示)来确定文档相关性。这些嵌入应该表示一些相似性的概念,因此与搜索相关的文档在嵌入空间中将具有较高的向量相似性。
RAG 的流行导致了矢量数据库的兴起,矢量数据库是一种新型数据库,旨在存储和搜索大量嵌入。数亿美元的资金已经发放给那些声称通过简化嵌入搜索来促进RAG 的初创公司。 RAG 的有效性是许多新应用程序将文本转换为向量并将其存储在这些向量数据库中的原因。
嵌入很难阅读
那么文本嵌入中存储了什么?除了语义相似性的要求之外,对于必须为给定文本输入分配哪些嵌入没有任何限制。嵌入向量中的数字可以是任何数字,并且根据它们的初始化而变化。我们可以解释嵌入与其他嵌入的相似之处,但无法理解嵌入的个体数字。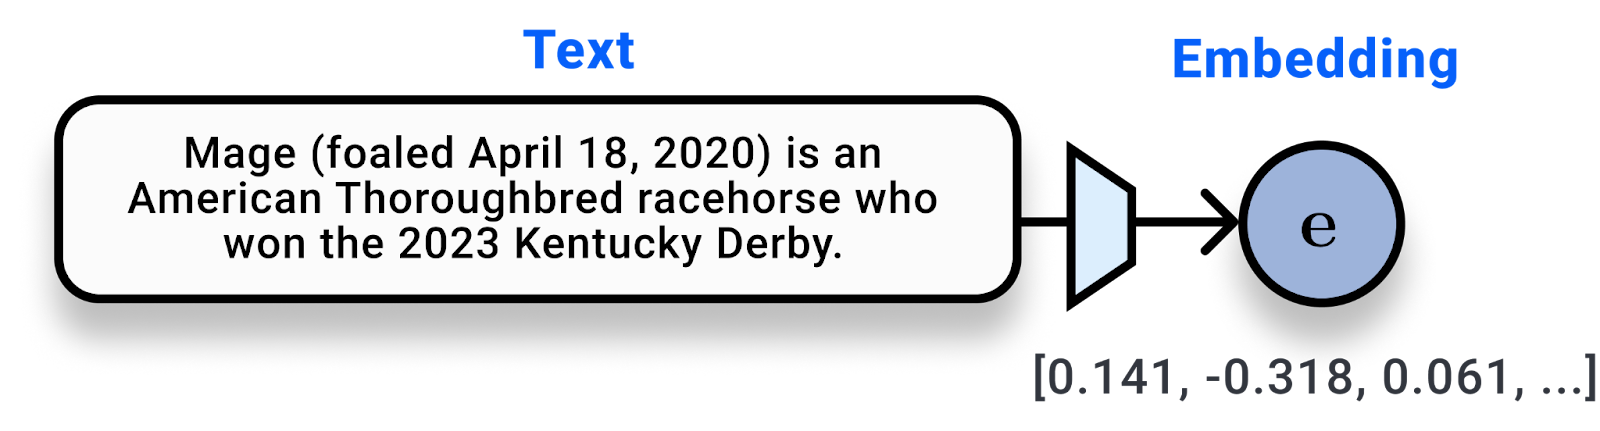
您知道该文本对应于受贵公司隐私政策保护的客户文档。但您实际上并不是随时在外部发送文本;而是在外部发送文本。您只发送嵌入向量,在您看来它们就像随机数。
如果有人侵入数据库并访问您所有的文本嵌入向量怎么办?这会很糟糕吗?或者,如果服务提供商想将您的数据出售给广告商,他们可以吗?这两种情况都涉及能够获取嵌入向量并以某种方式将它们反转回文本。
从文本到嵌入...返回文本
从嵌入中恢复文本的问题正是我们在论文《文本嵌入与文本一样显示》(EMNLP 2023) 中解决的场景。嵌入向量是信息存储和通信的安全格式吗?简而言之: 可以从输出嵌入中恢复输入文本吗?在深入研究解决方案之前,让我们多思考一下这个问题。文本嵌入是神经网络的输出,是由应用于输入数据的非线性函数运算连接起来的矩阵乘法序列。在传统的文本处理神经网络中,一个字符串输入被分割成多个标记向量,这些标记向量反复进行非线性函数运算。在模型的输出层,标记被平均为单个嵌入向量。
信号处理界的一条格言(称为数据处理不等式)告诉我们,函数不能向输入添加信息,它们只能维持或减少可用信息量。尽管传统观点告诉我们,神经网络的更深层次正在构建更高阶的表示,但它们并没有添加任何输入端未输入的有关世界的信息。
此外,非线性层肯定会破坏一些信息。现代神经网络中普遍存在的非线性层是“ReLU”函数,它只是将所有负输入设置为零。在典型文本嵌入模型的多个层中应用ReLU 后,不可能保留输入中的所有信息。
其他上下文中的反转
在计算机视觉社区中也提出了有关信息内容的类似问题。一些结果表明,图像模型的深度表示(本质上是嵌入)可用于以一定程度的保真度恢复输入图像。早期结果(Dosovitskiy,2016)表明可以从深度卷积神经网络(CNN)的特征输出中恢复图像。考虑到CNN 的高级特征表示,他们可以将其反转以生成原始输入图像的模糊但相似的版本。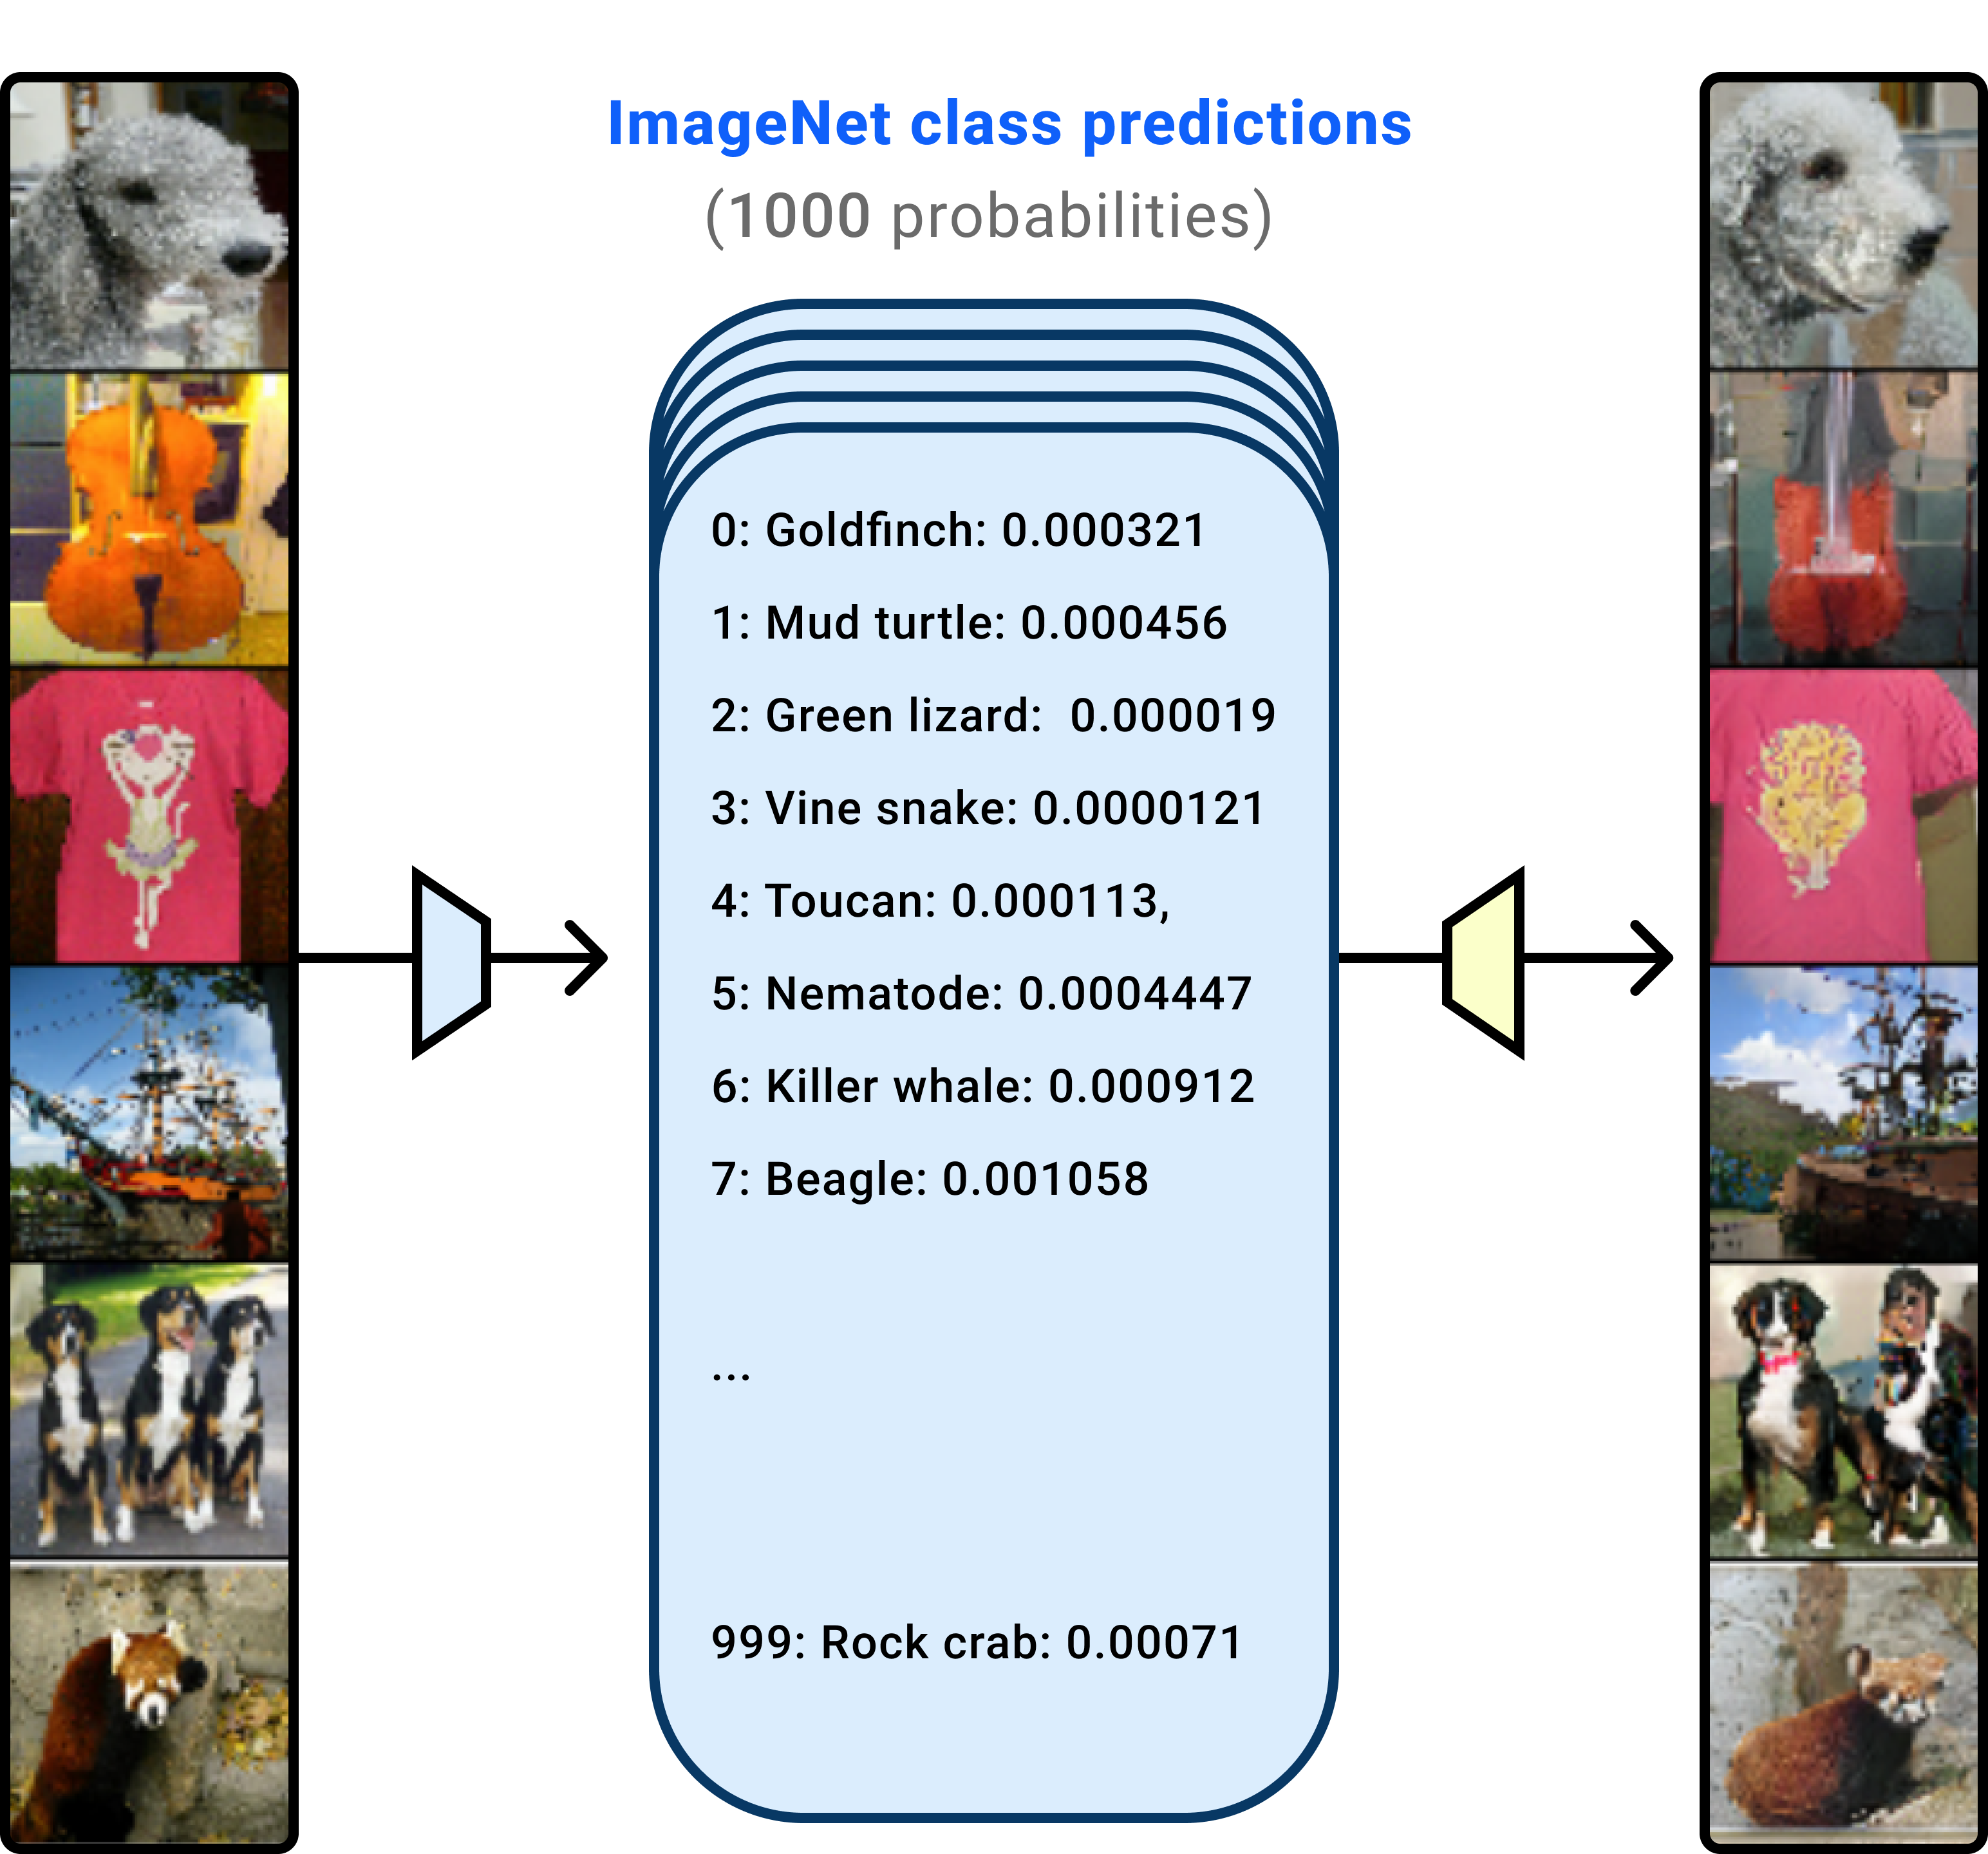
vec2text 之旅
如果反转可以用于图像表示,那么为什么它不能用于文本?让我们考虑一个恢复文本嵌入的玩具问题。对于我们的玩具设置,我们将文本输入限制为32 个标记(大约25 个单词,一个长度合适的句子),并将它们全部嵌入到768 个浮点数的向量中。在32 位精度下,这些嵌入为32 * 768=24,576 位或大约3 KB。许多位代表很少的字。您认为我们可以在这个场景中完美地重建文本吗?
首先,我们需要定义一个衡量良好程度的标准,以了解我们完成任务的情况。一个明显的指标是“精确匹配”,即反转后我们获得精确输入的频率。之前的反演方法在精确匹配方面没有取得任何成功,因此这是一个相当雄心勃勃的测量。因此,也许我们想从平滑的测量开始,测量倒置文本与输入的相似程度。为此,我们将使用BLEU 分数,您可以将其视为反转文本与输入的接近程度的百分比。
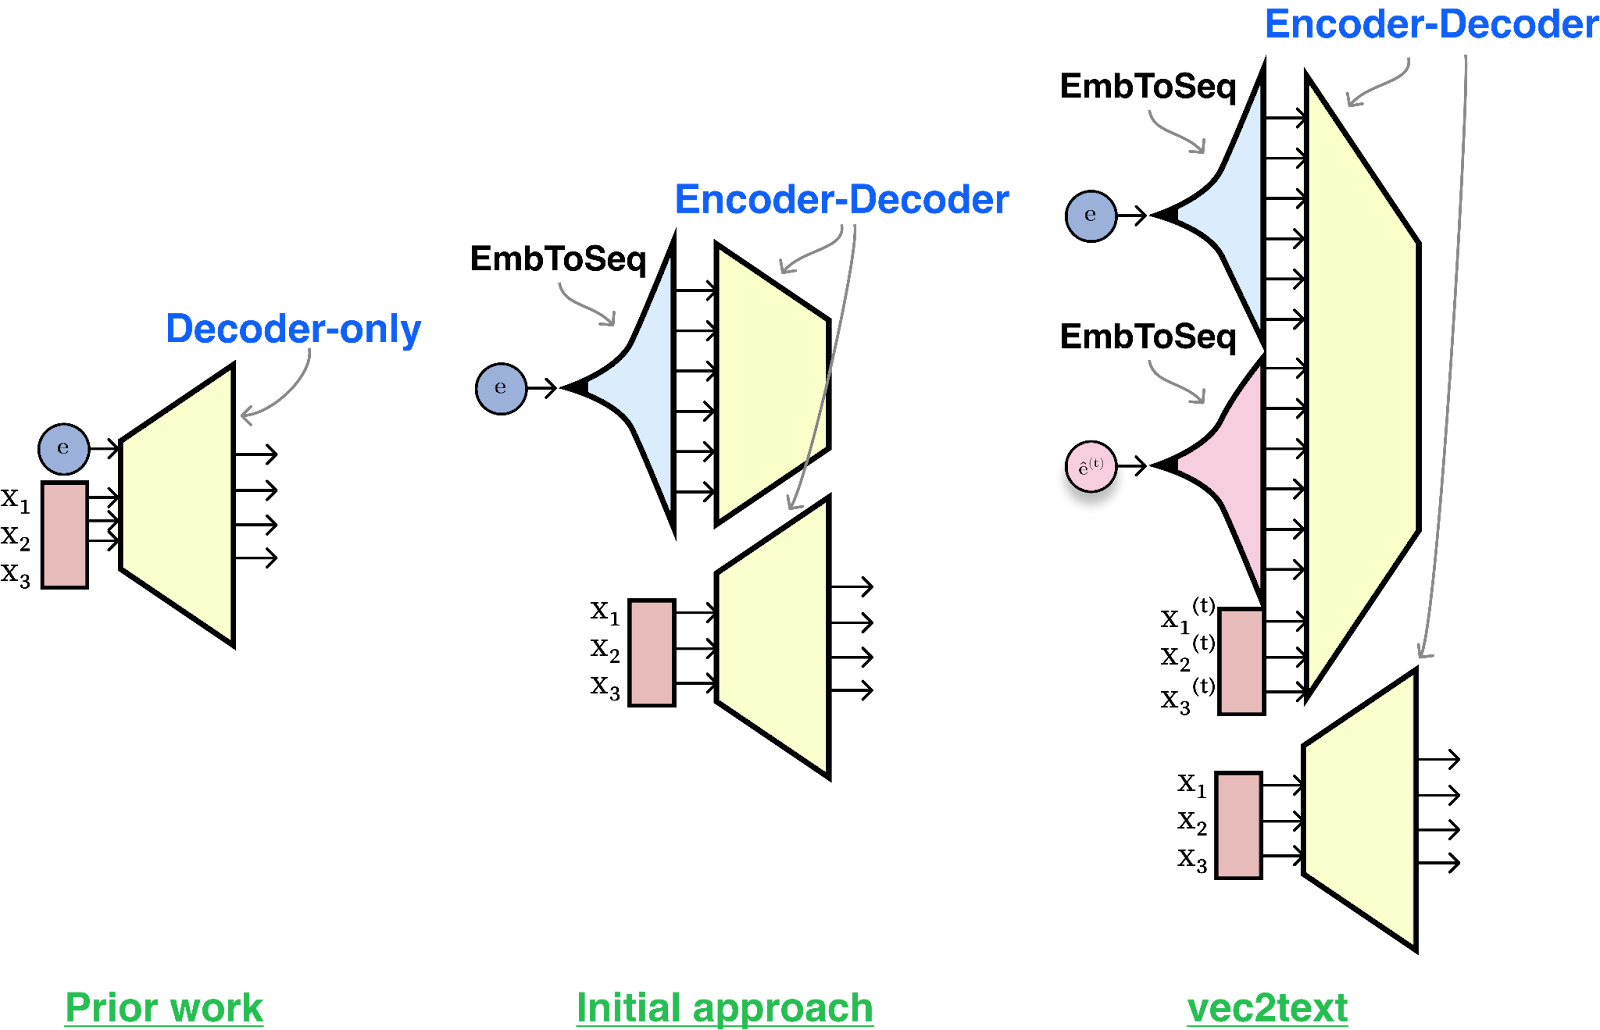
定义了成功指标后,让我们继续提出一种使用所述指标进行评估的方法。对于第一种方法,我们可以将反演视为传统的机器学习问题,并通过收集嵌入文本对的大型数据集,以我们知道的最佳方式解决它,并训练模型以输出给定嵌入作为输入的文本。
这就是我们所做的。我们构建了一个转换器,将嵌入作为输入,并使用传统语言建模对输出文本进行训练。第一种方法为我们提供了BLEU 分数约为30/100 的模型。实际上,模型可以猜测输入文本的主题,并得到一些单词,但它会丢失它们的顺序,并且经常弄错大部分单词。准确的比赛分数接近于零。事实证明,要求一个模型在一次前向传递中反转另一个模型的输出是相当困难的(其他复杂的文本生成任务也是如此,例如以完美的十四行诗形式生成文本或满足多个属性)。
(顺便说一句,如果不是这种情况怎么办?也就是说,如果嵌入为我们错误的假设分配了与原始序列相同的嵌入,该怎么办。我们的嵌入器将是有损的,将多个输入映射到相同的输出。如果是这种情况,那么我们的问题将是无望的,我们将无法区分多个可能序列中的哪一个产生了它。实际上,我们在实验中从未观察到这些类型的冲突。)
假设对真实情况具有不同的嵌入这一观察激发了一种类似优化的嵌入反演方法。给定真实值嵌入(我们想要去的地方)和当前假设文本及其嵌入(我们现在所处的位置),我们可以训练一个校正器模型,该模型经过训练可以输出比假设更接近真实值的内容。
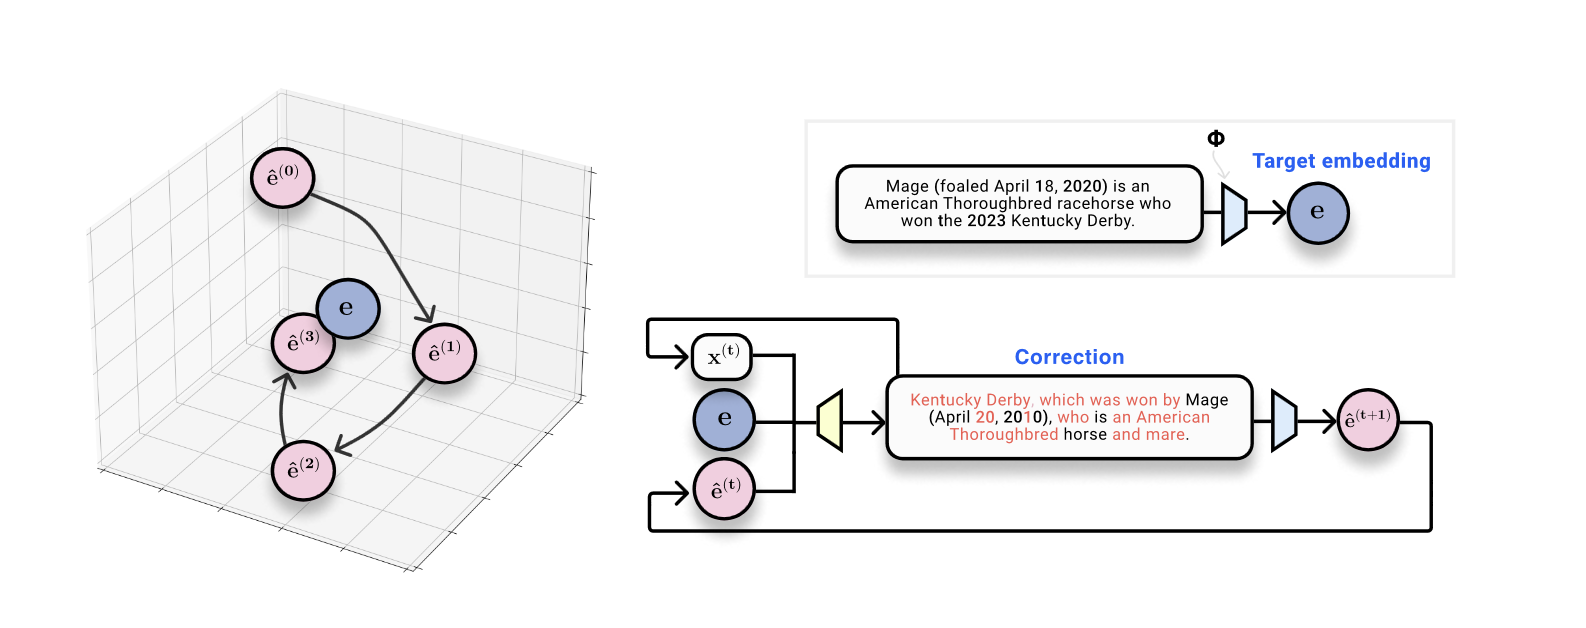
在完成一些细节并训练模型后,这个过程非常有效!一次前向传递校正将BLEU 分数从30 提高到50。该模型的一个好处是它可以自然地递归查询。给定当前文本及其嵌入,我们可以运行此优化的许多步骤,迭代生成假设,重新嵌入它们,并将它们作为模型的输入反馈回来。通过50 个步骤和一些技巧,我们可以准确地恢复92% 的32 个标记序列,并获得97 的BLEU 分数! (一般来说,BLEU 得分达到97 分意味着我们几乎完美地重建了每个句子,也许有些标点符号放错了地方。)
扩展和未来的工作
文本嵌入可以完美反转这一事实引发了许多后续问题。其一,文本嵌入向量包含固定数量的比特;必须存在一定的序列长度,达到该长度信息就无法再完美地存储在该向量中。尽管我们可以恢复大多数长度为32 的文本,但某些嵌入模型可以嵌入多达数千个标记的文档。我们将分析文本长度、嵌入大小和嵌入可逆性之间的关系留给未来的工作。另一个悬而未决的问题是如何构建可以防御反转的系统。是否有可能创建能够成功嵌入文本的模型,使得嵌入在混淆创建它们的文本的同时仍然有用?
最后,我们很高兴看到我们的方法如何应用于其他模式。 vec2text(嵌入空间中的一种迭代优化)背后的主要思想不使用任何特定于文本的技巧。这是一种迭代恢复任何固定输入中包含的信息的方法,给定对模型的黑盒访问。这些想法如何应用于其他模式的反转嵌入以及比嵌入反转更通用的方法还有待观察。
要使用我们的模型来反转文本嵌入,或者开始自己运行嵌入反转实验,请查看我们的Github 存储库: https://github.com/jxmorris12/vec2text
参考文献
用卷积网络反转视觉表示(2015),https://arxiv.org/abs/1506.02753通过判别训练分类器的前馈反转了解不变性(2021),https://proceedings.mlr.press/v139/teterwak21a/teterwak21a.pdf
文本嵌入(几乎)与文本一样多(2023),https://arxiv.org/abs/2310.06816
语言模型反转(2024),https://arxiv.org/abs/2311.13647
作者简介
Jack Morris 是纽约市康奈尔理工大学的博士生。他从事机器学习、自然语言处理和安全交叉领域的研究。他对深度神经表示的信息内容特别感兴趣,例如嵌入和分类器输出。引用
对于学术背景或书籍的归属,请将此作品引用为Jack Morris,“文本嵌入可以完美地编码文本吗?”,The Gradient,2024 年。
BibTeX 引文:
@文章{morris2024inversion,
作者={杰克马云惹不起马云莫里斯},
title={文本嵌入完美地编码文本吗?},
日记={梯度},
年={2024},
如何发布={\url{https://thegradient.pub/text-embedding-inversion},
}


